
版本与译文说明
原题:DINO-WM: World Models on Pre-trained Visual Features enable Zero-shot Planning。原作者:Gaoyue Zhou、Hengkai Pan、Yann LeCun、Lerrel Pinto;作者机构为纽约大学 Courant 研究所与 Meta AI。本译稿采用 ICML 2025 正式会议版,刊于 Proceedings of Machine Learning Research 第 267 卷,第 79115–79135 页;与 2024 年预印本区分。译者:世界模型图谱。
翻译范围为摘要、正文、致谢、影响声明及技术附录 A.1–A.8,保留全部 13 张数据表和 11 张图。文内作者与年份引用沿用原文,完整参考书目请查阅文末的原论文。原图从正式 PDF 导出,图内文字与图形保持原样,图注译为中文;未复制项目页的视频或交互演示。
正文中的“我们”指原作者,实验结果与比较结论保留论文发表时的语境。本文的“零样本规划”指世界模型经离线轨迹训练后,在测试时针对目标优化行动;不意味着世界模型无需训练,也不意味着所有训练数据都是随机、非专家轨迹。附录关于数据来源、轨迹长度及行动索引的细节,另以“译者注”标明。
原论文版权归作者所有,依 PMLR 的 CC BY 4.0 出版条款转载与翻译。学术出处为:Zhou, Gaoyue; Pan, Hengkai; LeCun, Yann; Pinto, Lerrel. DINO-WM: World Models on Pre-trained Visual Features enable Zero-shot Planning. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267:79115–79135, 2025。本中文译文属于翻译与排版改编,亦采用 CC BY 4.0;原文、出版信息与许可链接集中在文末。
摘要
给定控制行动,预测未来结果的能力是物理推理的基础。然而,这类预测模型通常被称为世界模型,学习起来仍然困难,而且往往配合在线策略学习,为特定任务构建解决方案。我们认为,要释放世界模型的潜力,它们应当能够:(1)在预先收集的离线轨迹上训练;(2)支持测试时的行为优化;(3)支持与任务无关的推理。
为此,我们提出 DINO World Model(DINO-WM):一种无需重建视觉世界即可建模视觉动态的新方法。DINO-WM 使用 DINOv2 预训练得到的空间图像块特征,通过预测未来的图像块特征,从离线行为轨迹中学习。它把目标特征作为预测目标,优化行动序列以达到由观测指定的目标,从而实现与任务无关的规划。
我们在六个环境中展示了 DINO-WM 在测试时生成零样本行为解法的能力,无需专家演示、奖励建模或预先学习的逆模型。在任意配置的迷宫、不同物体形状的推移操作以及多粒子场景等多种任务族中,它优于此前最先进的方法。
译者注:上一句忠实保留摘要中的作者表述。附录 A.1 同时说明,PushT 训练数据由已发布的专家轨迹加不同程度的噪声回放生成;因此不能据此把整套实验的数据来源概括为“完全没有专家轨迹”。
1. 引言
机器人与具身 AI 近年来取得了很大进展。模仿学习和强化学习的进步,使智能体能够在多种任务中学会复杂行为(Agarwal et al., 2022; Zhao et al., 2023; Lee et al., 2024; Ma et al., 2024; Hafner et al., 2024; Hansen et al., 2024; Haldar et al., 2024; Jia et al., 2024)。尽管如此,泛化仍是一项主要挑战(Zhou et al., 2023)。现有方法大多依赖训练好的策略:部署时以一次前向计算把观测映射为行动,不再进行优化或推理。
在这一框架下,要成功泛化,智能体在训练完成时就必须掌握所有可能任务与场景的解决方案;而这只有在训练时见过类似场景才有可能(Reed et al., 2022; Brohan et al., 2023b;a; Etukuru et al., 2024)。然而,提前学会所有潜在任务与环境的解法,既不可行,也不高效。
另一条路径是在训练数据上拟合动态模型,再在运行时优化特定任务的行为,而不是在训练时学会所有任务的解法。这类动态模型也称为世界模型(Ha & Schmidhuber, 2018),在机器人与控制领域有悠久历史(Sutton, 1991; Todorov & Li, 2005; Williams et al., 2017)。近来的研究表明,世界模型可以直接在原始感官数据上训练(Hafner et al., 2019; Micheli et al., 2023; Robine et al., 2023; Hansen et al., 2024; Hafner et al., 2024),免去显式状态估计,从而可以灵活地通过基于模型的优化得到策略。即便如此,用它解决通用任务仍面临重大挑战。
要理解世界建模的困难,可以考察在线与离线这两种主要范式。在线学习通常需要访问环境:持续收集数据以改进世界模型,模型的改进又改善策略及后续数据采集。然而,在线世界模型只在被优化策略所覆盖的范围内准确。它虽然能用于训练强大的任务专用策略,但即使环境相同,每个新任务仍需要重新训练。
离线学习则在预先收集的环境轨迹数据集上训练世界模型;只要数据集具有充分覆盖,就能去除对特定任务的依赖。但在实际求解任务时,这类方法往往需要很强的辅助信息,例如专家演示(Pathak et al., 2018; Wang et al., 2023)、结构化关键点(Ko et al., 2023; Wen et al., 2024)、预训练逆模型(Du et al., 2023; Ko et al., 2023),或稠密奖励函数(Ding et al., 2024)。这些要求都会降低离线世界模型的通用性。由此产生的核心问题是:是否存在另一种辅助信息,既能帮助构建更好的离线世界模型,又不损害其通用性?
本文提出 DINO-WM,一种从离线轨迹数据集构建与任务无关的世界模型的新方法,结构简单,见图 1。DINO-WM 在世界的紧凑嵌入上建模动态,而非直接预测原始观测。我们采用 DINOv2 的预训练图像块特征作为嵌入,它们提供了空间表征与以物体为中心的表征先验。我们推测,这种预训练表征能使世界建模更稳健、一致,放宽对特定任务数据覆盖的要求。
给定视觉嵌入与行动,DINO-WM 用 ViT 架构预测未来嵌入。模型在离线数据集上训练好后,任务求解被表述为视觉目标到达:从当前观测出发,达到未来期望的目标。由于 DINO-WM 的预测质量较高(见图 4),我们可以直接使用带推理时优化的模型预测控制,在测试时无需额外信息便到达目标。
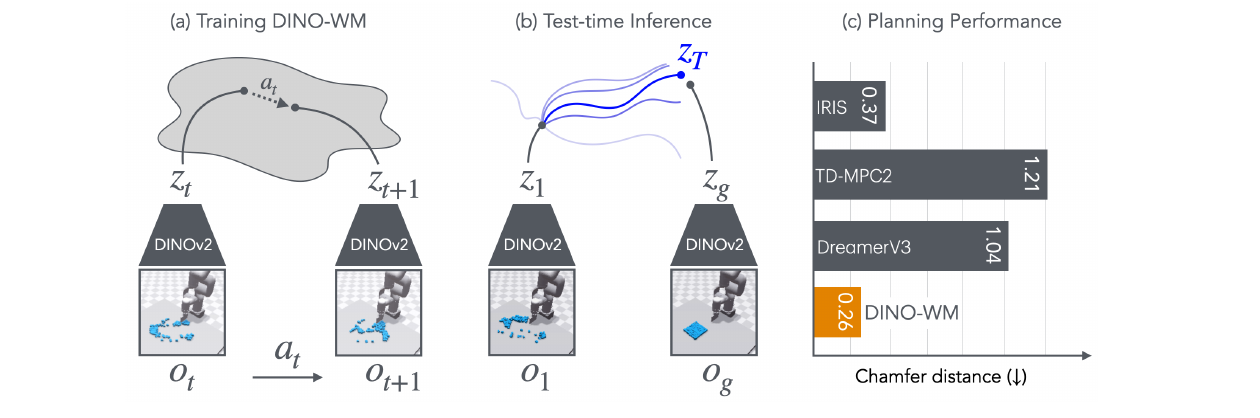
图 1|DINO-WM 用图像帧的预训练 DINOv2 嵌入训练视觉模型(a)。训练后,给定目标观测 o_T,可通过模型预测控制,在 DINO-WM 中规划并直接优化智能体行为(b)。预训练嵌入使其性能明显优于论文比较的既有世界模型(c)。
我们在六个环境套件中评估 DINO-WM,覆盖迷宫导航、滑动推移操作、机械臂控制和可变形物体操作。实验得到以下发现:
- DINO-WM 能生成高质量的未来世界预测,通过训练后的解码器可测量其视觉重建质量。在我们最困难的任务上,LPIPS 指标相较此前最先进的方法改善了 56%(见第 4.7 节)。
- 使用 DINO-WM 训练的潜在空间世界模型,可以在最困难的任务上以较高成功率达到任意目标,相较既有工作平均改善 45%(见第 4.3 节)。
- DINO-WM 可以在同一任务族的不同环境变体上训练,例如不同迷宫布局、不同操作物体形状,并取得高于既有工作的成功率(见第 4.5 节)。
为支持复现,我们公开了 DINO-WM 的代码与模型,并在项目网站提供规划视频。项目地址:dino-wm.github.io。
3. DINO 世界模型:概览与问题表述
我们遵循基于视觉的控制任务框架,将环境建模为部分可观测马尔可夫决策过程(POMDP)。该过程由三元组(O, A, p)定义:O 为观测空间,A 为行动空间。环境动态由转移分布 p(oₜ₊₁ | o≤ₜ, a≤ₜ) 描述,它根据过去的行动和观测预测未来观测。
我们的目标是从预先收集的离线数据集学习与任务无关的世界模型,并在测试时用它进行视觉推理和控制。测试时,系统从任意环境状态出发,得到一个用 RGB 图像表示的目标观测,与既有工作一致(Ebert et al., 2018; Wu et al., 2020; Mendonca et al., 2023b);系统需要执行行动序列 a₀, …, a_T,以到达目标状态。
这不同于在线强化学习中的世界模型:后者为一组固定任务优化奖励(Hafner et al., 2024; Hansen et al., 2024)。它也不同于通过文本提示指定目标的文本条件世界模型(Du et al., 2023; Ko et al., 2023)。
3.1. 基于 DINO 的世界模型(DINO-WM)
我们在潜在空间中建模环境动态。具体而言,在每个时间步 t,世界模型包含以下组件:
- 观测模型:zₜ ∼ encθ(zₜ | oₜ)。
- 转移模型:zₜ₊₁ ∼ pθ(zₜ₊₁ | zₜ₋H:ₜ, aₜ₋H:ₜ)。
- 解码器模型:ôₜ ∼ qθ(oₜ | zₜ)。这一组件可选,仅用于可视化。
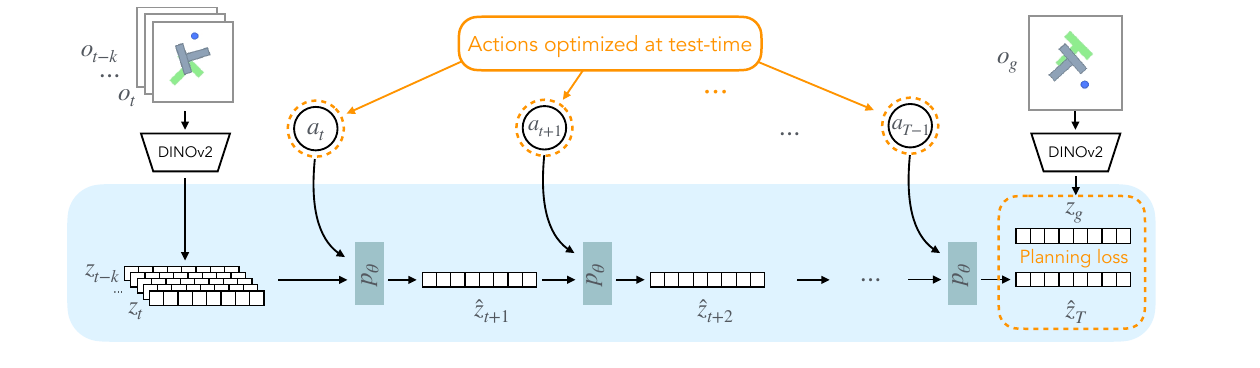
图 2|DINO-WM 架构。给定观测 oₜ₋ₖ:ₜ,优化行动序列 aₜ:T₋₁,使预测结果与期望目标 o_g 之间的损失最小。全部前向计算都在潜在空间 z 中完成。pθ 是用于预测未来的动态模型。
观测模型把图像观测编码为潜在状态 zₜ;转移模型输入长度为 H 的过去潜在状态历史;解码器输入潜在状态 zₜ,重建图像观测 oₜ。θ 表示这些模型的参数。解码器完全可选,因为它的训练目标独立于世界模型其余部分的训练。
这种设计让训练和测试都无需重建图像,相较将观测模型与解码器联合训练的做法(Micheli et al., 2023; Hafner et al., 2024),计算成本更低。附录 A.4.2 的消融实验展示了这一选择的效果。
DINO-WM 只建模环境离线轨迹数据中已有的信息。近期在线强化学习世界模型还需要任务相关信息,例如奖励(Hafner et al., 2020; Hansen et al., 2022; 2024)、折扣因子(Hafner et al., 2022; Robine et al., 2023),以及终止条件(Micheli et al., 2023; Hafner et al., 2024)。
3.1.1. 观测模型
要学习能用于多种环境与现实世界的通用世界模型,我们认为观测模型应当:(1)独立于任务和环境;(2)捕捉导航与操作所需的丰富空间信息。既有工作通常针对当前任务学习观测模型(Hafner et al., 2024),而我们认为,面对新环境,从零学到优质观测模型可能低效,甚至常常做不到;感知是一项能够受益于大规模互联网数据的通用任务。
因此,我们使用预训练 DINOv2 作为世界模型的观测模型,利用它在目标检测、语义分割与深度估计等任务中的强大空间理解能力(Oquab et al., 2024)。观测模型在训练与测试期间始终冻结。每个时间步 t,它把图像 oₜ 编码为图像块嵌入 zₜ ∈ ℝᴺˣᴱ,其中 N 为图像块数,E 为嵌入维度。图 2 展示了这一过程。
3.1.2. 转移模型
ViT 架构适合处理图像块特征,因此我们采用它作为转移模型(Dosovitskiy et al., 2021)。模型直接处理图像块嵌入,所以去掉词元化层,实质上将其变成仅有解码器的 Transformer。我们还修改架构,使其能够以本体感知信息和控制行动为额外条件。
转移模型输入过去的潜在状态 zₜ₋H:ₜ₋₁ 与行动 aₜ₋H:ₜ₋₁,预测下一时间步的潜在状态 zₜ;H 是表示上下文长度的超参数。为了正确捕捉时间依赖,使时间 t 的世界状态只依赖过去的观测和行动,我们在 ViT 中使用因果注意力机制,让模型在帧的层面自回归预测潜在状态。
具体来说,潜在状态 zₜ 中的每个图像块向量 zₜⁱ,都关注过去 H 帧的全部 N 个图像块向量 {zⁱₜ₋H:ₜ₋₁},i = 1, …, N。这不同于 IRIS(Micheli et al., 2023):IRIS 也将每个观测表示为一组向量,却在词元层面自回归预测;除过去帧外,还关注当前帧此前已经生成的词元。我们认为,按帧预测并把同一观测的图像块向量视为整体,能更好地捕捉全局结构与时间动态,建模整个观测的依赖关系,而非孤立词元的依赖,从而改善时间泛化。附录 A.4.1 的消融实验展示了该注意力掩码的效果。
为建模智能体行动对环境的影响,世界模型的预测以行动为条件。具体而言,先用多层感知机(MLP)把原始行动表示映射成 K 维向量,再将该向量拼接到每个图像块向量 zₜⁱ 上,i = 1, …, N。如有本体感知信息,也以相同方式拼接到观测潜在表征中,将其整合进潜在状态。
我们用教师强制训练世界模型。训练时,将轨迹切成长度 H + 1 的片段,对 H 个预测帧分别计算潜在一致性损失。对每一帧,损失为:
L_pred = ‖pθ(encθ(oₜ₋H:ₜ), φ(aₜ₋H:ₜ)) − encθ(oₜ₊₁)‖²。〔式 1〕
φ 为行动编码器,用于把行动映射到更高维度。世界模型的训练完全在潜在空间中完成,无需重建原始像素图像。
3.1.3. 用于解释预测的解码器
为了可视化并增强可解释性,我们使用多层转置卷积,把图像块表征解码回图像像素,做法类似 Razavi et al.(2019)。给定预先收集的数据集,我们用简单的重建损失优化解码器 qθ 的参数 θ:
L_rec = ‖qθ(zₜ) − oₜ‖²,其中 zₜ = encθ(oₜ)。〔式 2〕
解码器训练完全独立于转移模型训练。这有两个好处:解码器不影响世界模型求解下游任务时的推理和规划能力;规划时无需重建原始像素图像,因而降低计算成本。解码器仍然很有价值,因为它使世界模型的预测更容易理解。也可以将解码器损失反向传播给预测器,但我们的消融发现,相较不加入解码器损失,这样做会损害性能;详细结果见附录 A.4.2。
3.2. 用 DINO-WM 进行视觉规划
为了评估世界模型质量,我们在测试时优化轨迹,并测量性能。规划方法本身相当常规,作用是体现世界模型的质量。模型接收当前观测 o₀ 与目标观测 o_g,二者均为 RGB 图像。规划被定义为寻找一组能够让智能体达到 o_g 的行动。我们使用模型预测控制(MPC),通过考虑未来行动的结果进行规划。
每次迭代中,我们用交叉熵方法(CEM)优化行动序列。规划代价定义为潜在状态与目标潜在状态之间的均方误差(MSE):
C = ‖ẑ_T − z_g‖²;其中 ẑₜ = p(ẑₜ₋₁, aₜ₋₁),ẑ₀ = enc(o₀),z_g = enc(o_g)。
MPC 框架与 CEM 优化流程见附录 A.5.1。世界模型可微,因此还可以用梯度下降(GD)优化这个目标,让模型直接引导智能体达到指定目标;这种方法可能更高效,流程见附录 A.5.2。不过,实验中 CEM 的表现优于 GD,完整结果见附录 A.5.3。我们推测,在训练与规划目标中加入正则化,可能进一步提高性能,留待未来研究。
4. 实验
实验围绕五个问题展开:(1)能否用预先收集的离线数据有效训练 DINO-WM?(2)训练后能否用它进行视觉规划?(3)世界模型的质量在多大程度上依赖预训练视觉表征?(4)它能否泛化到新的空间布局、物体排列等环境配置?(5)其性能如何随离线数据集规模变化?
我们在六个环境套件上训练和评估 DINO-WM,完整描述见附录 A.1,并与在潜在空间或原始像素空间预测的先进世界模型比较。
4.1. 环境与任务
我们评估了六个动态复杂度不同的环境套件,部分来自 D4RL(Fu et al., 2021)与 DeepMind Control Suite(Tassa et al., 2018)等标准机器人基准,见图 3。它们包括迷宫导航(Maze、Wall)、桌面推移的精细控制(PushT)、机械臂控制(Reach),以及用 XArm 进行的可变形物体操作(Rope、Granular)。
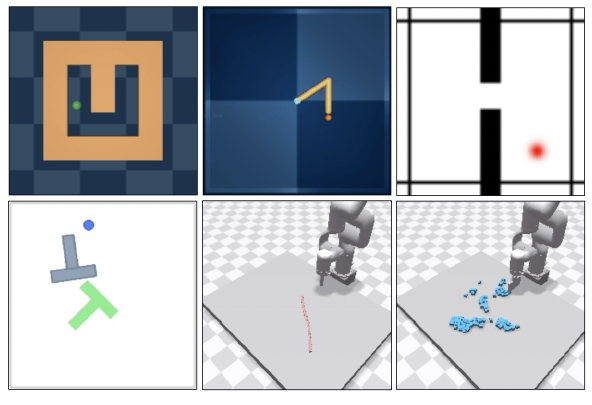
图 3|六个评估环境。从左到右、从上到下分别为 Maze、Reach、Wall、Push-T、绳索操作与颗粒操作。
所有环境中的任务都是:从任意初始状态出发,到达由目标观测指定、随机采样的目标状态。PushT 的目标配置经过采样,以保证可在 25 步内到达。Granular 的目标要求将全部粒子聚成方形,其位置和大小随机变化。所有环境的观测均为 224 × 224 的 RGB 图像。完整环境描述见附录 A.1。
4.2. 基线
我们与以下常用于控制的先进模型比较。对 IRIS、DreamerV3 和 TD-MPC2,均使用我们的离线数据集训练,不提供奖励或任务信息,再对学到的世界模型执行 MPC 来求解下游任务。
- IRIS(Micheli et al., 2023):通过离散自编码器把视觉输入编码为词元,再用 GPT Transformer 预测未来词元,从而支持通过想象学习策略和价值。
- DreamerV3(Hafner et al., 2024):把视觉输入编码为类别表征,预测未来状态与奖励,并从想象轨迹训练 actor-critic 策略。
- TD-MPC2(Hansen et al., 2024):在潜在空间学习不含解码器的世界模型,用奖励信号优化潜在表征。
- AVDC(Ko et al., 2023):使用扩散模型,根据初始观测与文本目标生成任务执行视频。第 4.6 节提供定性评估,以及行动条件变体的 MPC 规划结果。
译者注:前三项简介描述各方法原本的设计;本论文比较时的训练与求解条件以本节首段为准。
4.3. 用 DINO-WM 优化行为
世界模型训练后,我们研究 DINO-WM 能否直接在潜在空间中进行零样本规划。对于 Maze、Reach、PushT 和 Wall,我们采样 50 组初始与目标状态,测量全部实例的成功率。由于 Rope 与 Granular 环境的单步运行耗时较长,分别在 10 个实例上评估 Chamfer 距离(CD)。在 Granular 中,从验证集采样随机配置,目标是把材料推成方形,其位置和尺度随机选择。
| 模型 | Maze SR↑ | Wall SR↑ | Reach SR↑ | PushT SR↑ | Rope CD↓ | Granular CD↓ |
|---|---|---|---|---|---|---|
| IRIS | 0.74 | 0.04 | 0.18 | 0.32 | 1.11 | 0.37 |
| DreamerV3 | 1.00 | 1.00 | 0.64 | 0.30 | 2.49 | 1.05 |
| TD-MPC2 | 0.00 | 0.00 | 0.00 | 0.00 | 2.52 | 1.21 |
| DINO-WM(本文) | 0.98 | 0.96 | 0.92 | 0.90 | 0.41 | 0.26 |
如表 1 所示,在 Wall、PointMaze 等较简单的环境中,DINO-WM 与 DreamerV3 等先进世界模型相当。但在操作环境中,任务完成需要准确推断丰富的接触信息与物体动态,DINO-WM 显著优于既有工作。我们注意到,TD-MPC2 缺少奖励信号时难以学到良好的潜在表征,继而表现较差。所有环境的规划可视化见附录 A.8。
随着数据增多,DINO-WM 是否能学到更好的环境动态?第 4.8 节的消融显示,规划性能随训练数据量增加而提升。附录 A.6 还提供完整推理和规划耗时,展示其相较传统仿真的显著加速,尤其是在计算密集的可变形物体环境中。
4.4. 预训练视觉表征重要吗?
我们将不同的预训练通用编码器作为世界模型的观测模型,评估下游规划性能。具体选用机器人控制与通用感知中常见的 R3M(Nair et al., 2022)、ImageNet 预训练 ResNet-18(Russakovsky et al., 2015; He et al., 2016)以及 DINO CLS(Caron et al., 2021)。编码器细节见附录 A.3。
| 模型 | Maze SR↑ | Wall SR↑ | Reach SR↑ | PushT SR↑ | Rope CD↓ | Granular CD↓ |
|---|---|---|---|---|---|---|
| R3M | 0.94 | 0.34 | 0.40 | 0.42 | 1.13 | 0.95 |
| ResNet | 0.98 | 0.12 | 0.06 | 0.20 | 1.08 | 0.90 |
| DINO CLS | 0.96 | 0.58 | 0.60 | 0.44 | 0.84 | 0.79 |
| DINO Patch(本文) | 0.98 | 0.96 | 0.92 | 0.90 | 0.41 | 0.26 |
表 2 展示规划性能。PointMaze 的动态与控制较简单,不同观测编码器的世界模型都接近完全成功。然而,随着环境变复杂、需要更精确的控制与空间理解,将观测编码成单个潜在向量的世界模型性能明显下降。我们认为,基于图像块的表征更能捕捉空间信息;R3M、ResNet 与 DINO CLS 等模型将观测压缩为单个全局特征向量,丢失了操作任务所需的关键空间细节。
为了理解 DINOv2 特征为何带来良好的规划性能,我们直接分析特征。下游控制中评估特征质量的一种常见方法,是从特征线性探测环境状态,以考察特征是否编码了任务相关的状态信息。我们在三个环境中比较图像块特征——不同 ViT 大小的 DINOv2 与预训练 MAE(He et al., 2021)——以及全局特征 DINO CLS、R3M。
| 方法 | PointMaze | PushT | Wall |
|---|---|---|---|
| DINO-S Patch | 0.017 | 0.434 | 0.184 |
| DINO-B Patch | 0.014 | 0.504 | 0.163 |
| DINO-S CLS | 0.475 | 0.833 | 0.519 |
| 预训练 MAE | 0.856 | 0.804 | 0.711 |
| R3M | 0.192 | 0.902 | 0.539 |
表 3 中 DINO-S Patch 和 DINO-B Patch 的验证损失最低,表明它们具有更好的任务表征能力。预训练 MAE 虽也使用图像块特征,验证损失却高得多。我们推测,这是因为 MAE 优先考虑重建,而非任务相关性,所以在控制任务中不如前者合适。
4.5. 泛化到新的环境配置
我们不仅评估世界模型对不同目标的泛化,也评估它对不同环境配置的泛化。为此构建 WallRandom、PushObj 与 GranularRandom 三个环境族,在未见过的配置上用随机目标测试模型。图 5 展示训练与测试例子,详细环境说明见附录 A.2。
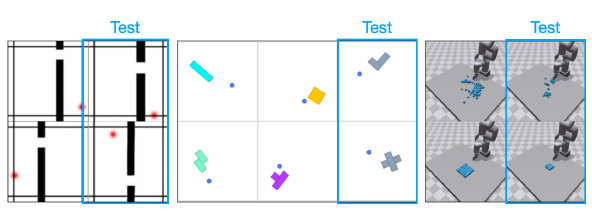
图 5|WallRandom、PushObj 与 GranularRandom 的训练和测试设置;测试设置以蓝色标出。
| 模型 | WallRandom SR↑ | PushObj SR↑ | GranularRandom CD↓ |
|---|---|---|---|
| IRIS | 0.06 | 0.14 | 0.86 |
| DreamerV3 | 0.76 | 0.18 | 1.53 |
| R3M | 0.40 | 0.16 | 1.12 |
| ResNet | 0.40 | 0.14 | 0.98 |
| DINO CLS | 0.64 | 0.18 | 1.36 |
| DINO-WM(本文) | 0.82 | 0.34 | 0.63 |
表 4 显示,DINO-WM 在 WallRandom 中表现明显更好,说明模型有效学到了墙与门的一般概念,即使二者出现在训练时未见过的位置。相比之下,其他方法难以准确识别门的位置并穿过它。PushObj 对所有方法仍然困难:模型只在四种物体形状上训练,难以精确推断相关物理参数。
GranularRandom 测试时的粒子数不到训练时的一半,相较训练实例,整幅图像属于分布外输入。尽管如此,DINO-WM 能准确编码场景,将粒子聚到指定方形位置,其 Chamfer 距离是所有基线中最低的,体现出更好的场景理解。我们推测,这是因为观测模型将场景编码为图像块特征;虽然粒子总数改变,每个图像块中的变化仍在分布范围内。
4.6. 与生成式视频模型的定性比较
生成式视频模型受到广泛关注,人们自然会设想它们能充当世界模型。我们将 DINO-WM 与基于扩散的生成模型 AVDC(Ko et al., 2023)比较。如图 6 所示,AVDC 虽能生成视觉上逼真的未来图像,却缺乏物理合理性:一个时间步内可能发生不现实的大幅变化,而且模型难以达到精确目标状态。生成模型未来的进步可能缓解这些问题。
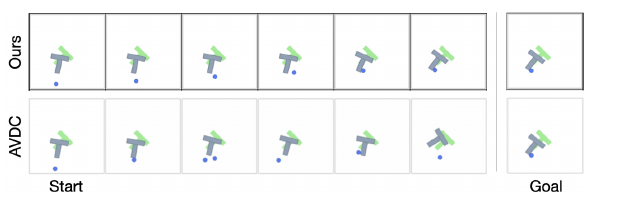
图 6|DINO-WM 与 AVDC 生成的规划。
我们还比较了 AVDC 的一个变体:扩散模型以当前观测 oₜ 和行动 aₜ 为条件生成下一观测 oₜ₊₁,而不是以文本目标为条件,一次生成整段观测序列。图 7 展示这一行动条件 AVDC 在验证轨迹上的开环展开结果。可见,长期预测逐渐偏离真实观测,不足以支持准确的任务规划。
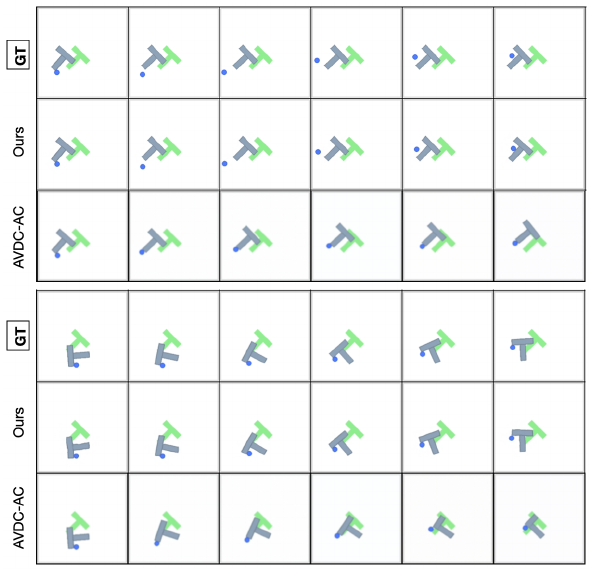
图 7|DINO-WM 与行动条件 AVDC(AVDC-AC)在 PushT 上的开环展开。每条轨迹给定第一帧与行动序列,世界模型按这些行动进行开环预测。
4.7. 解码与解释潜在表征
DINO-WM 在潜在空间运行,观测模型也不用像素重建目标训练,但训练一个解码器仍有助于解释预测。我们评估所有模型所预测未来的图像质量,发现本方法优于其他方法,包括那些以环境专用重建目标训练编码器的模型。图 4 的开环展开展示了 DINO-WM 即使没有显式像素监督,依然具有稳健的预测能力。
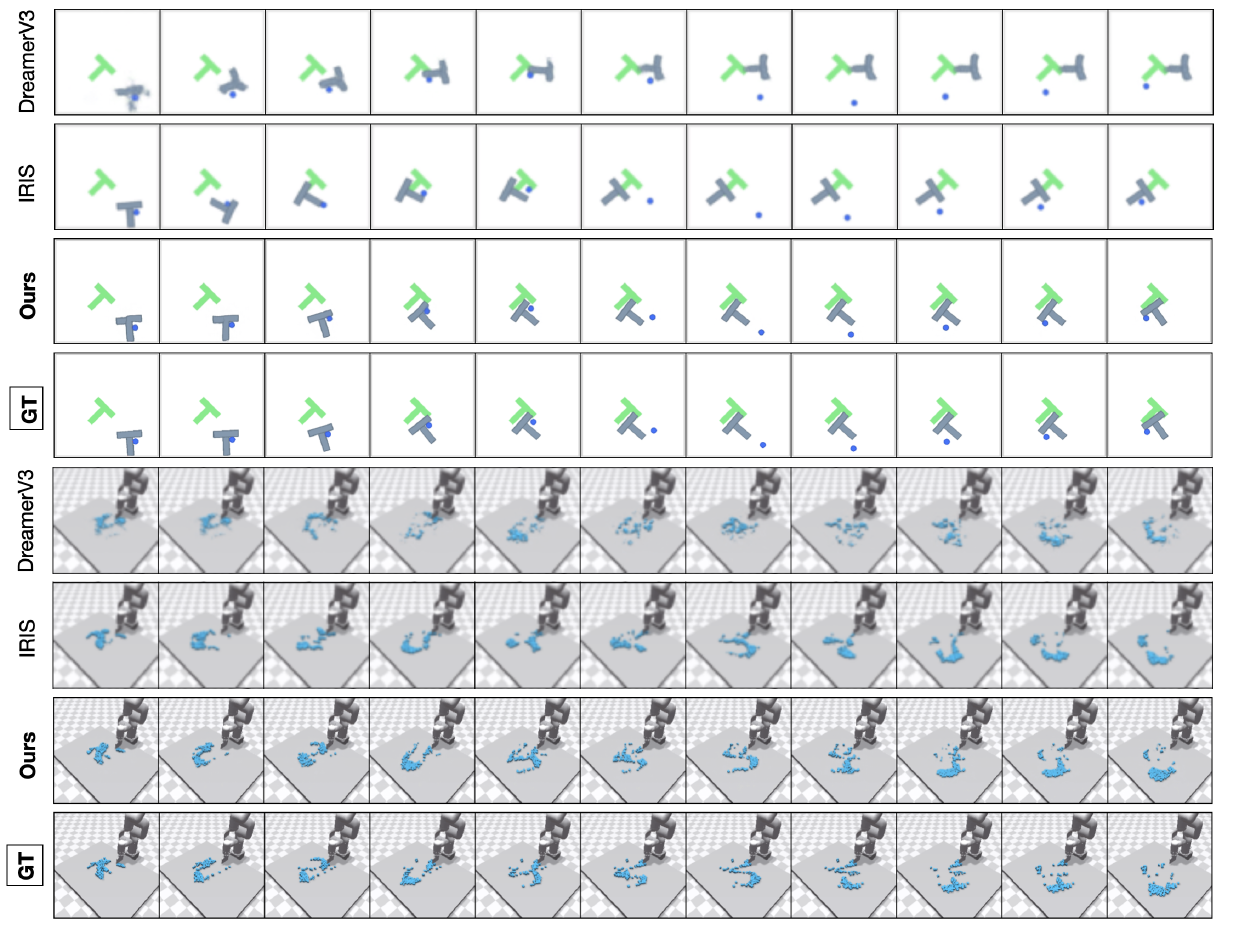
图 4|世界模型在 Push-T 与 Granular 上的开环展开。给定第一帧与行动序列,各模型预测未来帧,再由解码器重建。每个环境的最下行是真实观测。DINO-WM(Ours)对应行加粗;作者认为其在视觉上与真实观测难以区分。
表 5 与表 6 报告预测未来帧的学习感知图像块相似度(LPIPS;Zhang et al., 2018)和结构相似性指数(SSIM;Wang et al., 2004)。SSIM 根据预测与真实图像之间的结构信息及亮度一致性衡量感知质量,数值越高越相似。LPIPS 比较图像的深层表征,评估感知相似性,分数越低表示视觉上越接近。
| 方法 | PushT | Wall | Rope | Granular |
|---|---|---|---|---|
| R3M | 0.045 | 0.008 | 0.023 | 0.080 |
| ResNet | 0.063 | 0.002 | 0.025 | 0.080 |
| DINO CLS | 0.039 | 0.004 | 0.029 | 0.086 |
| AVDC | 0.046 | 0.030 | 0.060 | 0.106 |
| DINO-WM(本文) | 0.007 | 0.0016 | 0.009 | 0.035 |
| 方法 | PushT | Wall | Rope | Granular |
|---|---|---|---|---|
| R3M | 0.956 | 0.994 | 0.982 | 0.917 |
| ResNet | 0.950 | 0.996 | 0.980 | 0.915 |
| DINO CLS | 0.973 | 0.996 | 0.980 | 0.912 |
| AVDC | 0.959 | 0.983 | 0.979 | 0.909 |
| DINO-WM(本文) | 0.985 | 0.997 | 0.985 | 0.940 |
4.8. DINO-WM 的规模规律
为分析 DINO-WM 的规模变化规律,我们在 PushT 环境中使用 200 到 18,500 条轨迹的不同规模数据集,训练世界模型并进行规划。表 7 展示清楚的趋势:数据集增大时,世界模型预测质量与规划行为性能均明显改善。更大的数据集使模型捕捉环境中更多样的动态与细微差异,从而预测更准确,规划也拥有更充分的依据。
| 轨迹数 | SR↑ | SSIM↑ | LPIPS↓ |
|---|---|---|---|
| 200 | 0.08 | 0.949 | 0.056 |
| 1000 | 0.48 | 0.973 | 0.013 |
| 5000 | 0.72 | 0.981 | 0.007 |
| 10000 | 0.88 | 0.984 | 0.006 |
| 18500 | 0.92 | 0.987 | 0.005 |
5. 结论、局限与未来工作
我们提出 DINO-WM:一种简单而有效的技术,在潜在空间中建模视觉动态,无需像素空间重建。我们展示了它能够捕捉环境动态,在不依赖任务说明的情况下泛化到未见配置,并在测试时进行视觉推理,通过规划生成下游任务的零样本解法。DINO-WM 朝着连接与任务无关的世界建模、推理与控制迈出了一步,为通用世界模型在现实世界中的应用提供了有前景的方向。
局限与未来工作。首先,DINO-WM 假设可以获得充分覆盖状态与行动的离线数据集;对高度复杂的环境而言,获取这样的数据并不容易。将 DINO-WM 与探索策略结合,并在获得新经验时更新模型,可能缓解这一问题。其次,它仍依赖智能体真实行动标签;使用大量互联网视频训练时,不一定能获得这些行动。最后,当前方法在行动空间规划以求解下游任务;未来可以扩展为结合高层规划与低层控制策略的层级结构,支持更精细的控制任务。
致谢
感谢 Ademi Adeniji、Alfredo Canziani、Amir Bar、Kevin Zhang、Mido Assran、Vlad Sobal、Zichen Jeff Cui 提供的宝贵讨论与反馈。本研究得到 Honda、Hyundai、NSF 项目 2339096,以及 ONR 项目 N00014-21-1-2758 和 N00014-22-1-2773 的资助。Lerrel Pinto 获得 Packard Fellowship 支持。
影响声明
本文工作的目标是促进与任务无关的世界模型的学习与应用。这项工作可能带来许多社会影响,但我们认为没有必须在这里特别强调的影响。
译者注:以上为原作者的影响声明。
附录 A.1. 环境与数据集生成
PointMaze。该环境由 Fu et al.(2021)引入:一个受力驱动、具有两个自由度的小球,需要沿笛卡尔坐标 x 与 y 方向到达目标。智能体动态包含速度、加速度与惯性等物理属性,使运动具有真实感。我们生成 2000 条完全随机的轨迹训练世界模型。为简洁起见,表格中将此任务记为 Maze。
Wall。这个自定义二维导航环境包含两个房间,由一面带门的墙分隔。智能体需要从一个房间中随机选择的起点出发,穿门到达另一房间的目标。我们还提供墙与门位置随机化的变体,以测试模型对新配置的泛化。固定墙设置的训练数据完全随机,共 1920 条轨迹,每条 50 个时间步;多种训练环境配置的变体使用 10,240 条随机轨迹。
Reacher。来自 DeepMind Control Suite(Tassa et al., 2018)的连续控制任务,包含一个在二维空间到达目标的双关节机械臂。我们提高了难度,要求整个机械臂匹配任意目标姿态,而非只让末端执行器到达目标。为训练世界模型,生成 3000 条轨迹,每条 100 步。表格中简称 Reach。
Push-T。该环境由 Chi et al.(2024)引入:推移智能体与 T 形块交互。目标是从随机初始化状态出发,在 25 步内将智能体和 T 形块都引导到一个已知可达的目标配置。智能体与 T 形块都必须匹配目标位置。与此前设置不同,固定的绿色 T 形不再表示块的目标位置,而只作为视觉参照。成功需要精确理解智能体与物体之间丰富的接触动态,因此是视觉运动控制与物体操作的困难测试。
我们将原始发布的专家轨迹加入不同程度的噪声并回放,生成包含 18,500 个样本的数据集。此外,通过改变物体的形状与颜色,评估模型对新任务的适应能力。这个变体使用 20,000 条随机采样的轨迹,每条 100 步。
绳索操作。该任务来自 Zhang et al.(2024),使用 Nvidia Flex 仿真(Zhang et al., 2024):XArm 与放置在桌面的柔软绳索交互。目标是把绳索从任意起始配置移到测试时指定的目标配置。训练使用随机数据集:1000 条轨迹,每条 20 个时间步,从随机起点执行随机行动。测试从不同初始位置设置目标配置,并对方向与空间位移加入随机变化。
颗粒操作。采用与绳索操作相同的仿真设置,操纵约 100 个粒子形成期望形状。训练数据为 1000 条轨迹,每条 20 个时间步,从相同初始配置执行随机行动。测试则从多种起始位置到达特定目标形状,同时随机改变粒子分布、间距和方向。
译者注:本节保留原文关于 PushT 专家轨迹回放的说明,以及 Rope、Granular 的“20 个时间步”。表 12 对这两个环境列出的轨迹长度为 5;论文未解释两处数字的关系,本译稿不自行统一。
附录 A.2. 用于测试泛化的环境族
- WallRandom:基于 Wall,随机改变墙和门的位置。测试时,智能体从墙一侧的随机位置,移动到另一侧的随机位置;测试中的墙和门位置不与训练中见过的位置重叠。
- PushObj:由 Push-T 衍生,加入新的块形状,包括类似俄罗斯方块的形状与“+”形。模型在四种形状上训练,在两种未见形状上评估。智能体与物体都需要到达目标位置。
- GranularRandom:由 Granular 衍生,以不同粒子数量初始化场景。机器人需要将全部粒子聚成方形,方形位置随机采样。直接使用第 4.3 节中以固定材料数量训练的模型。
可视化见图 5。
附录 A.3. 预训练特征
- R3M:在广泛的现实人类操作视频上预训练的 ResNet-18(Nair et al., 2022)。
- ImageNet:在 ImageNet-1K 数据集上预训练的 ResNet-18(Russakovsky et al., 2015)。
- DINO CLS:预训练 DINOv2 提供 Patch 与 CLS 两种嵌入。CLS 嵌入是概括整幅图像全局信息的一维向量。
- 预训练 MAE:以掩码自编码方式训练的 ViT(He et al., 2021)。输入图像中大部分图像块被遮蔽,模型学习重建它们。我们使用 ViT-Base 检查点,特征维度为 768,参数量约 8600 万。
译者注:原文称 CLS 为“1-dimensional vector”,这里译为“一维向量”,指展平的全局特征向量,不应理解为只有一个数值的标量。
附录 A.4.1. 使用与不使用因果注意力掩码
第 3.1.2 节引入了因果注意力掩码。我们在 PushT 上进行消融,在不同历史长度 h 下,分别训练有掩码与无掩码的 DINO-WM。模型输入 oₜ₋ₕ₊₁, oₜ₋ₕ₊₂, …, oₜ,输出 oₜ₋ₕ₊₂, …, oₜ₊₁。有掩码时,预测每个 oₜ 只能关注过去观测;无掩码时,预测输出序列中任意观测,都可关注整个输入观测序列。
表 8 展示 PushT 设置下的规划成功率。h = 1 时,有无掩码的模型等价,成功率相同且较好。历史变长时,无掩码模型性能快速下降,因为训练时可以通过关注未来帧“作弊”,而测试时没有这些未来帧。加入因果掩码解决了这个问题;历史变长后,模型可以更好地捕捉速度、加速度与物体动量等动态信息,性能也相应提高。
| 设置 | h = 1 | h = 2 | h = 3 |
|---|---|---|---|
| 无掩码 | 0.76 | 0.36 | 0.08 |
| 有掩码 | 0.76 | 0.88 | 0.92 |
附录 A.4.2. 加入重建损失
DINO-WM 不需要以像素重建损失训练世界模型,从而避免学到与下游任务无关特征的风险。我们仍进行了一项消融:将解码器的重建损失传播到预测器,用它训练预测器。表 9 显示,这种做法在 PushT 上表现尚可,但稍逊于预测器完全独立于解码器训练的方法。这体现了将特征学习与重建目标解耦的优势。
| 设置 | 成功率 |
|---|---|
| 无解码器损失 | 0.92 |
| 有解码器损失 | 0.80 |
附录 A.5.1. 结合交叉熵方法的模型预测控制
下面详细说明实验使用的规划优化流程。给定当前 RGB 观测 o₀ 与目标 RGB 观测 o_g,结合 CEM 的 MPC 步骤如下:
- 先将观测编码为潜在状态:ẑ₀ = enc(o₀),z_g = enc(o_g)。〔式 3〕
- 规划目标为最终时间步 T 的预测潜在状态与目标状态之间的均方误差:C = ‖ẑ_T − z_g‖²,其中 ẑₜ = p(ẑₜ₋₁, aₜ₋₁),ẑ₀ = enc(o₀)。〔式 4〕
- 每次规划迭代,CEM 从一个分布中采样 N 条行动序列,每条长度为 T。初始分布设为高斯分布。
- 对每条采样序列 {a₀, a₁, …, a_T₋₁},世界模型在潜在空间预测其轨迹:ẑₜ = p(ẑₜ₋₁, aₜ₋₁),t = 1, …, T。〔式 5〕随后计算每条轨迹的代价 C。
- 选出代价最低的 K 条行动序列,据此更新分布的均值与协方差。
- 从更新后的分布重新采样 N 条行动序列,重复上述过程,直到成功,或达到由超参数指定的固定迭代次数。
- 优化结束后,在环境中执行前 k 个行动,原文记为 a₀, …, aₖ。随后,在下一时间步依据新观测重复规划。
译者注:原文写“前 k 个行动”,同时把索引列为 a₀, …, aₖ;从零开始计数时该序列包含 k + 1 个行动。本译稿保留原文记号,不推断实际实现如何取值。
附录 A.5.2. 梯度下降
由于世界模型可微,我们也考虑梯度下降(GD):通过反向传播直接优化行动,使代价最小。
- 将当前观测 o₀ 与目标观测 o_g 编码到潜在空间:ẑ₀ = enc(o₀),z_g = enc(o_g)。〔式 6〕
- 目标与 CEM 相同:C = ‖ẑ_T − z_g‖²,其中 ẑₜ = p(ẑₜ₋₁, aₜ₋₁),ẑ₀ = enc(o₀)。〔式 7〕
- 计算代价相对于行动序列 {a₀, a₁, …, a_T₋₁} 的梯度,迭代更新行动:aₜ ← aₜ − η × ∂C/∂aₜ,t = 0, …, T − 1。〔式 8〕η 为学习率。
- 重复直到达到固定迭代次数,再在环境中执行前 k 个行动,原文记为 a₀, …, aₖ;k 为预先指定的超参数。
附录 A.5.3. 规划结果
表 10 提供不同规划优化方法的完整性能。CEM 表示用交叉熵方法优化行动序列,然后直接在环境执行,期间不纠正、不重新规划。GD 同样以开环方式一次执行全部规划行动,只是用梯度下降优化。MPC 表示用 CEM 优化,同时允许重新规划与滚动时域控制。
| 方法 | PointMaze | Push-T | Wall | Rope | Granular |
|---|---|---|---|---|---|
| CEM | 0.8 | 0.86 | 0.74 | NA | NA |
| GD | 0.22 | 0.28 | NA | NA | NA |
| MPC | 0.98 | 0.90 | 0.96 | 0.41 | 0.26 |
译者注:原表 10 未在列名中重复标指标。依据正文评估定义,前三个环境使用成功率,Rope 与 Granular 使用 Chamfer 距离,两类数值不能直接比较。NA 保留为原文未报告的结果,不是 0。
附录 A.6. 推理时间
将模型部署用于实时决策时,推理时间是关键因素。表 11 报告 NVIDIA A6000 GPU 上的单步推理时间、仿真器推进一步的环境展开时间,以及用 CEM 生成最优行动序列的整体规划时间。由于模型大小与输入图像分辨率固定,DINO-WM 的推理时间在各环境中保持不变,相比传统仿真展开明显加速。
尤其在可变形物体操作等计算需求较高的环境中,仿真展开每步需要数秒,DINO-WM 则支持快速推理与高效规划。规划耗时用每次迭代 100 个样本、10 次优化步骤的 CEM 测量,表明它能在保持任务准确性与适应性的同时实现可行的规划耗时。
| 测量项 | 时间(秒) |
|---|---|
| 推理(批量 32) | 0.014 |
| 仿真展开(批量 1) | 3.0 |
| 规划(CEM,100 × 10) | 15.89 |
译者注:0.014 秒对应批量 32 的单步前向推理,15.89 秒对应整次 CEM 规划,两者不是同一个指标。推理与仿真的批量也不同,不能将表中数字直接解释为相同条件下的速度倍数。
附录 A.7. 超参数与实现
下面列出 DINO-WM 超参数及相关实现仓库。所有环境的世界模型使用表 13 中相同的超参数训练。架构在各环境中保持一致:采用基于 DINOv2 的编码器,将输入图像缩放为 196 × 196 像素,提取形状为(14 × 14, 384)的特征。ViT 主干深度为 6,注意力头数为 16,MLP 维度为 2048,参数量约 1900 万。
相邻观测可能十分相似,因此数据处理引入 frameskip 参数,以确保预测任务有意义。该参数指定模型预测到多远的未来。各环境的值见表 12。
| 环境 | H | Frameskip | 数据集规模 | 轨迹长度 |
|---|---|---|---|---|
| PointMaze | 3 | 5 | 2000 | 100 |
| Reacher | 3 | 5 | 3000 | 100 |
| Push-T | 3 | 5 | 18500 | 100–300 |
| PushObj | 3 | 5 | 20000 | 100 |
| Wall | 1 | 5 | 1920 | 50 |
| WallRandom | 1 | 5 | 10240 | 50 |
| Rope | 1 | 1 | 1000 | 5 |
| Granular | 1 | 1 | 1000 | 5 |
| 名称 | 数值 |
|---|---|
| 图像大小 | 224 |
| 优化器 | AdamW |
| 解码器学习率 | 3e-4 |
| 预测器学习率 | 5e-5 |
| 行动编码器学习率 | 5e-4 |
| 行动嵌入维度 | 10 |
| 训练轮数 | 100 |
| 批量大小 | 32 |
译者注:本节正文的编码器输入缩放为 196 × 196,表 13 的图像大小为 224;二者按原文分别保留。表 12 的 Rope、Granular 轨迹长度为 5,与附录 A.1 的 20 个时间步不同,关系未在论文中说明。
相关实现仓库如下,地址按论文所列保留:
- DINOv2:https://github.com/facebookresearch/dinov2
- DreamerV3:https://github.com/NM512/dreamerv3-torch
- AVDC:https://github.com/flow-diffusion/AVDC
- R3M:https://github.com/facebookresearch/r3m/
- 预测器实现基于:https://github.com/lucidrains/vit-pytorch/
附录 A.8. 更多规划可视化
图 8 展示 DINO-WM 与基线的规划实例。为便于比较,展示表现最好的世界模型 DINO CLS 与 DreamerV3。图 9 还展示 DINO-WM 在所有任务上的表现:每个环境上方带阴影的行,是执行规划行动后的环境观测;下方的行,是世界模型想象出的观测。
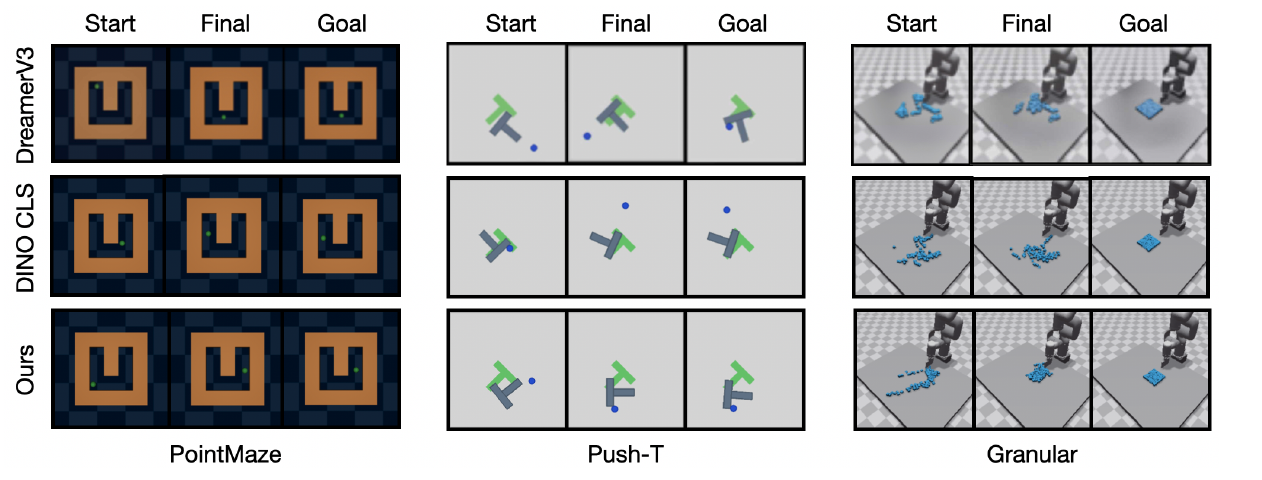
图 8|随机采样初始与目标配置后的 PointMaze、Push-T、Granular 规划可视化。Start 与 Goal 为初始和目标观测,定义任务;Final 为使用各世界模型规划后系统到达的最终状态。比较模型为 DINO CLS、DreamerV3 与 DINO-WM。
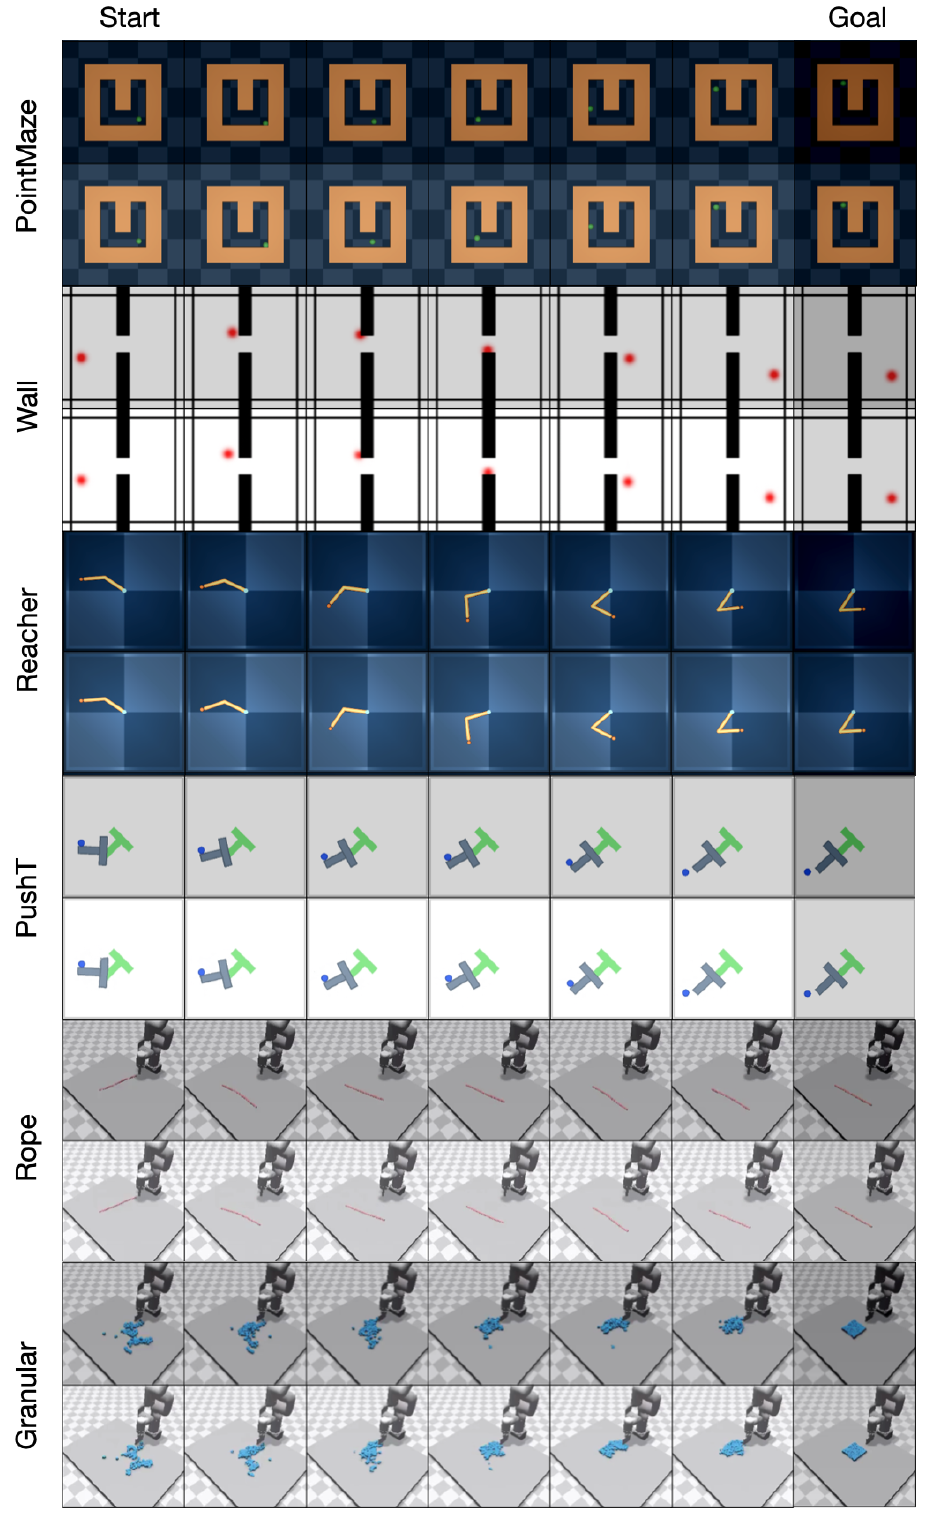
图 9|DINO-WM 在全部六个环境中规划的轨迹。每个环境上方带阴影的行,是执行规划行动后的环境观测;下方的行,是世界模型想象出的观测。
为了展示 DINO-WM 在测试时对不同目标的泛化,图 10 与图 11 提供相同初始观测、不同目标观测下的更多可视化。每对轨迹的上方阴影行,是执行 DINO-WM 规划行动后的环境观测;下方行,是模型想象出的轨迹。最左列表示初始观测,最右侧阴影列表示目标观测。
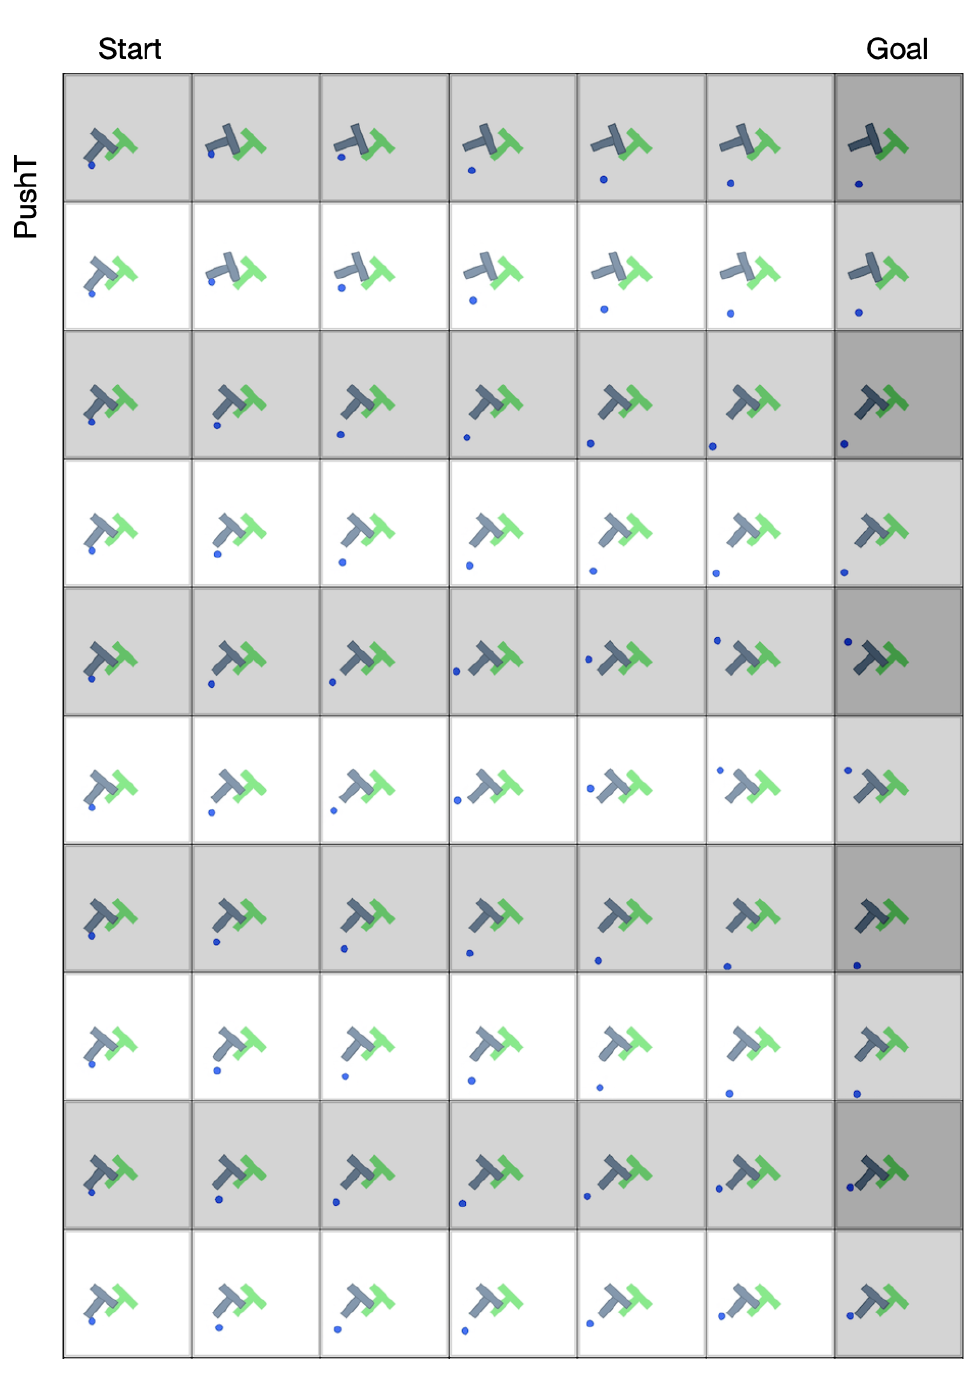
图 10|DINO-WM 在 PushT 中,从相同初始状态规划到不同目标状态的轨迹。
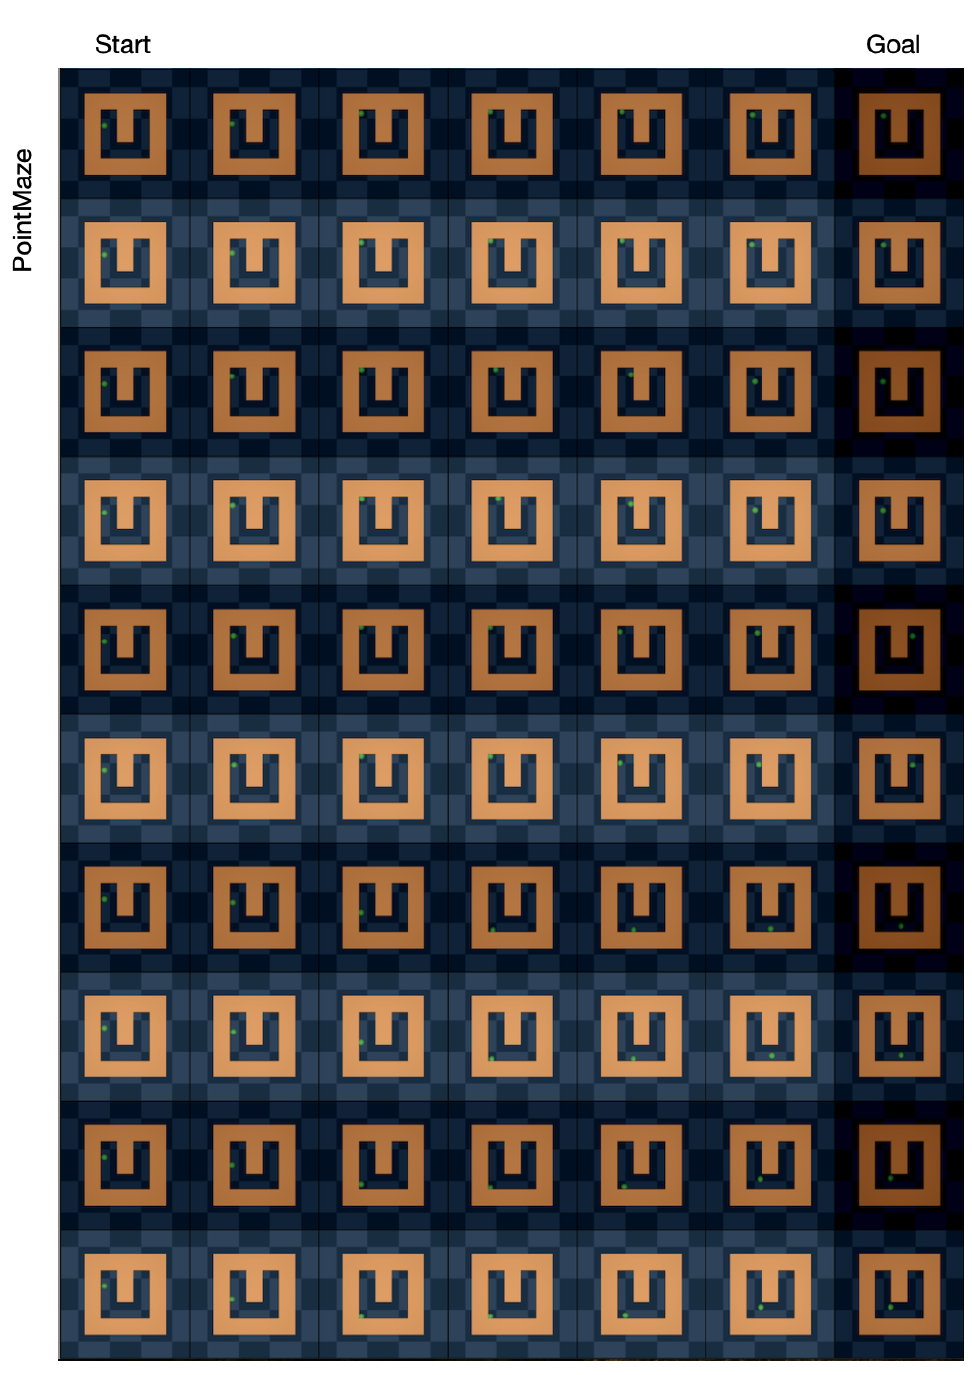
图 11|DINO-WM 在 PointMaze 中,从相同初始状态规划到不同目标状态的轨迹。
译者术语说明
以下为译者补充,用于统一本文术语。
- patch feature / patch embedding:图像块特征/图像块嵌入。保留多个空间位置的特征,而非仅用单个全局向量表示图像。
- latent space:潜在空间。模型在编码后的特征中预测未来,不必每步生成像素图像。
- teacher forcing:教师强制。训练时使用数据中的真实历史作为预测条件。
- open-loop rollout:开环展开。按给定行动连续预测未来,中途不以新环境观测校正。
- model predictive control(MPC):模型预测控制。执行规划中的一段行动,获得新观测后重新规划。
- cross-entropy method(CEM):交叉熵方法。本文通过采样行动序列、筛选低代价序列并更新分布来优化规划。
- proprioception:本体感知。智能体关于自身状态的信息。
- Chamfer Distance(CD):Chamfer 距离。用于比较点集合;本文在绳索与颗粒任务中使用,越低越好。
原文与来源
图片:Gaoyue Zhou、Hengkai Pan、Yann LeCun、Lerrel Pinto · DINO-WM(ICML 2025)· CC BY 4.0 · 论文原图(由 PDF 导出,图内内容未改)