
版本与译文说明
原题:WorldModelBench: Judging Video Generation Models As World Models。作者:Dacheng Li、Yunhao Fang、Yukang Chen、Shuo Yang、Shiyi Cao、Justin Wong、Michael Luo、Xiaolong Wang、Hongxu Yin、Joseph E. Gonzalez、Ion Stoica、Song Han、Yao Lu。作者机构为加州大学伯克利分校、加州大学圣迭戈分校、NVIDIA 与 MIT。Dacheng Li 和 Yunhao Fang 为共同第一作者,部分工作在 NVIDIA 实习期间完成。译者:世界模型图谱。
本译稿采用 NeurIPS 2025 数据集与基准赛道正式会议版,DOI 为 10.52202/085713-1834。翻译范围:摘要、正文 1–6 节与技术附录 A.1–A.6,保留全部 10 张数据表及公式,并转载 9 张原图;图 2、5、12 保留中文图注与原论文阅读入口。参考书目和 NeurIPS 标准论文检查表请阅原 PDF。正文中的数字引文沿用原文编号,“我们”指原作者,结果保留论文当时的实验语境。
正式版摘要写的是相较 GPT-4o“预测错误率降低 9.9%”;2025 年 2 月 arXiv v1 摘要写的是“平均准确率提高 8.6%”。两者指标表述和数字不同,本译稿不混用。原文中若有图注笔误、交叉引用错位或不同表格的小数差异,另标译者注,不静默替作者修改结果。
OpenReview 正式会议版标注 CC BY 4.0,本译稿为翻译与排版改编。图 2、5、12 包含第三方数据集的参考画面,其单独转载条件尚未确认,因此保留中文图注与原 PDF 阅读入口。其余原图保留图内标注,中文图注随图显示;原文、作者署名与许可集中列于文末。
摘要
视频生成模型发展迅速,开始被视为能够支持机器人和自动驾驶等决策应用的视频世界模型。然而,现有基准无法严格检验这些主张:它们只关注一般视频质量,忽略了遵循物理规律等对世界模型重要的因素。为弥合这一缺口,我们提出 WorldModelBench,用于评估视频生成模型在面向应用的领域中的世界建模能力。
WorldModelBench 有两项主要优势。(1)能够针对细微的世界建模违规:通过纳入指令遵循和物理规律遵循维度,WorldModelBench 能检测此前基准忽略的细微违规,例如物体尺寸不规则变化、违反质量守恒。(2)与大规模人类偏好对齐:我们众包收集 6.7 万个人工标签,对 14 个前沿模型进行准确测量。利用这些高质量人工标签,我们进一步微调一个准确的评判器,使评估自动化;该评判器只有 20 亿参数,但预测世界建模违规时的错误率比 GPT-4o 低 9.9%。
此外,我们展示了通过最大化评判器奖励来与人工标注对齐的训练,可以明显提高世界建模能力。数据集托管于 Hugging Face 的 Efficient-Large-Model/worldmodelbench,评估代码位于 GitHub 的 WorldModelBench-Team/WorldModelBench。
1. 引言
视频生成模型在创造高保真、逼真视频方面取得了显著成功 [24, 8, 44, 57, 13, 52, 62, 42, 29, 18]。除了生成有视觉吸引力的内容,这些模型越来越被视为潜在的视频世界模型。视频世界模型根据给定的文本和图像指令模拟可行的未来帧 [31, 42, 1]。这些未来帧遵循现实世界动态,能够为机器人、自动驾驶和人体预测等决策任务提供有依据的规划 [6, 7, 1, 63, 9, 19, 10]。
尽管有这种潜力,视频生成模型是否能充当可靠世界模型仍属推测。现有基准主要评估时间一致性和审美连贯性等一般视频质量 [26, 36, 54]。这些指标对视频世界模型是必要的,却并不充分:它们没有捕捉现实世界动态,例如是否遵守基本物理规律(图 1)。VideoPhy [4] 等工作引入了基于物理的评估,但对日常物体交互的关注仍未覆盖更广泛的应用场景。
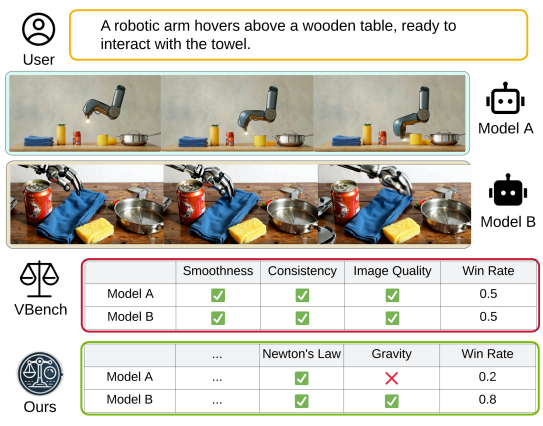
图 1:模型 A 和 B 都能生成高质量视频,但 A 的视频中机械臂悬在空中,违反重力规律。已有基准侧重一般视频质量,不能区分违反物理规律的视频。
为弥合这一缺口,我们引入 WorldModelBench。它由 350 对图像与文本条件构成,覆盖 7 个面向应用的领域、56 个子领域,同时支持文生视频(T2V)和图生视频(I2V)模型。除了覆盖范围广,它还具备两项独特优势。
第一,WorldModelBench 能检测此前基准忽略的细微世界建模违规。它保留对一般视频质量的基本评估——逐帧质量与时间质量——并加入世界建模专用的两个维度:指令遵循和物理规律遵循。指令遵循进一步分为四级,物理规律遵循分为五种常见违规(第 3.1 节),从而捕捉物体尺寸变化等情况。
译者注:原文此处把物体尺寸变化举例为“违反牛顿定律”;第 3.1.2 节则把不规则形变归入“质量守恒与固体力学”维度。此处保留它所指的检测现象,具体评分类别以第 3.1 节为准。
第二,WorldModelBench 配有大规模人工标签。我们开展大规模人工标注,收集 6.7 万个标签,准确反映现有模型在所提指标下的表现(第 3.3 节)。这些标注揭示了现有视频生成模型的一些特点,例如 I2V 模型的调优不足(第 4 节)。我们还在这些标签上微调一个 20 亿参数评判器,方便后续评估。尽管轻量,这个评判器凭借高质量人工标签,预测人类偏好的错误率比 GPT-4o [2] 低 9.9%。更重要的是,最大化微调评判器的分数来对齐人工标注,能够提高视频生成模型的世界建模能力 [65, 44]。
- 我们展示此前基准不足以评估视频世界模型,并提供 WorldModelBench,在多种面向应用的领域测量世界建模能力。
- 提供 14 个前沿模型的 6.7 万个人工标签,供社区进一步研究。
- 提供一个准确的微调评判器;它能预测世界建模违规,以其奖励进行微调会改善生成结果。
图 2:WorldModelBench 概览。模型依据文本以及可选的图像条件生成视频,再从常识、指令遵循和物理规律遵循三个维度评分。我们收集 6.7 万个人工标签评估 14 个前沿模型,并配备微调评判器,为模型提供细粒度反馈;与其奖励对齐的训练能改善世界建模能力。(原图含第三方参考画面,见文末原论文 PDF 第 2 页。)
2. 相关工作
视频生成模型。许多基于扩散的视频生成模型在合成逼真视频方面取得了重要进步 [30, 24, 38, 12, 13, 23, 50, 52, 38, 47, 57, 62, 14, 15, 60, 18, 59, 65, 42, 37, 39, 29, 3, 56]。许多模型根据文本条件 [12, 13, 23, 50, 52, 59, 65, 42, 29, 37, 39]、图像条件 [5] 或两者共同条件 [56, 57, 65, 30] 合成视频。本文关注带文本和图像条件的视频模型评估。
视频生成模型评估。此前评估主要使用 Fréchet 视频距离(FVD)[48]、CLIPSIM [45] 等单一数值指标。Huang 等 [26] 建立 VBench,全面评估一般视频质量与视频和条件的一致性。Wu 等 [54] 提出 T2VScore,采用文本与视频匹配及一般视频质量标准。Bansal 等 [4] 进一步用 0 或 1 的粒度评估视频是否遵循正确物理规律,也以同样粒度评估指令遵循。我们的 WorldModelBench 沿这一路线改进:采用更细的物理和指令评分,纳入多样应用领域,也保留 VBench 的部分指标。He 等 [22] 同样使用人工标注,但不侧重物理与指令遵循能力;[27] 则在二维模拟中研究视频生成模型的物理规律遵循。
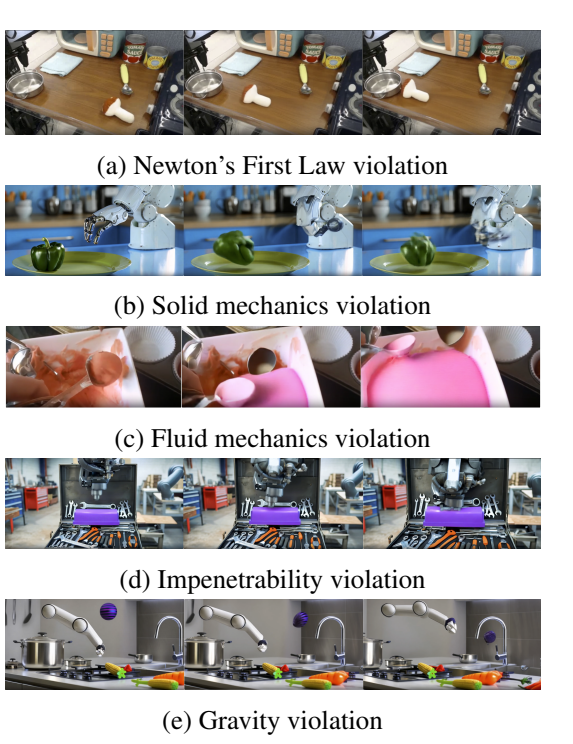
图 3:物理违规示例:(a)牛顿第一定律;(b)固体力学;(c)流体力学;(d)不可穿透性;(e)重力。
视频生成的奖励模型。Li 等 [33]、Prabhudesai 等 [44] 探索用奖励模型改善视频生成质量。图像奖励模型较丰富 [58, 55, 28],视频奖励模型则较少 [33]。VideoPhy 收集了判断指令与物理遵循的 0–1 粗粒度人工标签,但没有进一步用训练出的奖励模型改善视频生成。本文收集大规模视频偏好,聚焦世界建模,训练一个准确的奖励模型来反映人类偏好。
在文本领域,从奖励模型学习已被证明有助于让输出与人类偏好对齐 [32, 43]。视频领域的 [61] 使用文本与图像奖励模型改进人类反馈下的生成质量;[33] 进一步混合文本与图像、文本与视频奖励模型;[44] 提出包含多个奖励模型的奖励梯度框架。我们沿用这一框架,把微调评判器作为奖励模型,提高视频生成能力。
3. WorldModelBench:设计原则
本节正式介绍 WorldModelBench。理想的视频世界模型应当响应文本及图像指令,合成可行的后续帧,帮助下游决策应用。因此,评估应包括:模型能否准确遵循输入条件的指令,能否准确合成接下来的若干帧,以及能否覆盖多样应用领域。
具体来说,我们把评分标准分为两部分:(1)指令遵循:生成的视频是否正确遵循文本及图像提示;(2)未来帧生成:视频是否表示世界可能的下一状态,包括物理规律遵循和常识。第 3.1 节细分这两部分,第 3.2 节介绍数据整理流程,第 3.3 节给出人工标注流程。
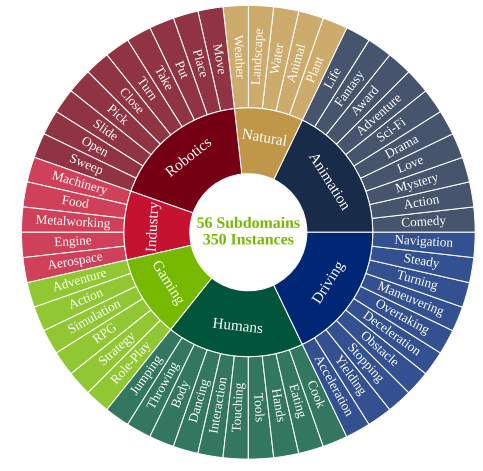
图 4:WorldModelBench 包含 7 个领域、56 个子领域,共 350 对图像与文本条件。
3.1. 评分标准
在 WorldModelBench 的每个实例中,模型根据文本及图像条件生成视频。每个视频按下列维度进行细粒度评分,总分最高为 10。表 1 将 WorldModelBench 与已有基准对照。
| 类别/指标 | VBench | VideoArena | VideoPhy | 本文 |
|---|---|---|---|---|
| 指令遵循 | ✓ | × | ✓ | ✓ |
| 常识 | ✓ | × | × | ✓ |
| 物理规律遵循 | × | × | ✓ | ✓ |
| 支持 T2V | ✓ | ✓ | ✓ | ✓ |
| 支持 I2V | ✓ | ✓ | × | ✓ |
| 提示套件规模 | 946 | 1500 | 688 | 350 |
| 人工标签 | — | 30k | 73k | 67k |
| 标签是否公开 | — | No | No | Yes |
3.1.1. 指令遵循。我们定义四个等级,依据等级赋予 0–3 分。
- 等级 0:主体不存在,或始终静止。
- 等级 1:主体移动,但没有遵循预期动作。例如要求汽车左转,生成视频却显示右转。
- 等级 2:部分遵循指令,但未完成任务。例如要求人触碰自己的肩膀,视频只显示手向肩膀移动,没有真正完成触碰。
- 等级 3:主体完整、准确地完成指定任务。
3.1.2. 物理规律遵循。物理规律是物理世界的基本原则,是否遵循它们可作为评估生成帧是否可信的重要代理指标。我们根据现有模型的常见失败和相关工作 [4],选取五项基本物理规律,每项记 0 或 1 分,总分为 0–5。违规例见图 3。
- 规律 1,牛顿第一定律:物体不应在没有外力的情况下自行运动。
- 规律 2,质量守恒与固体力学:物体不应发生不规则的形变或扭曲。
- 规律 3,流体力学:液体不应不自然或不规则地流动。
- 规律 4,不可穿透性:物体不应不自然地穿过彼此。
- 规律 5,重力:物体不应违背重力,例如悬浮。
译者注:上述是论文供标注者使用的操作性规则,不能当作完整物理定律表述。例如牛顿第一定律并不禁止物体在无合外力时保持匀速直线运动;这里判断的是不合场景依据的运动。
3.1.3. 常识。一般视频生成质量并非 WorldModelBench 的重点,却是良好视频世界模型的前提。例如可行的未来状态应具有连贯运动和视觉上合理的质量。我们沿用 [26] 的分类,把常识概括为时间质量与逐帧质量,每项记 0 或 1 分,总分 0–2。逐帧质量判断是否有不美观帧或低质量内容;时间质量判断是否有明显闪烁、卡顿,以及无关物体突然出现或消失。
3.2. 多样领域的数据整理流程
WorldModelBench 覆盖自动驾驶、机器人、人类活动、工业、自然场景、模拟游戏及动画。每个领域有 50 个样本,来自 5–10 个子领域;每个样本是一对文本与图像条件。图 4 展示子领域。为保证质量,我们对每个样本执行以下三步。
1. 获取参考视频。为确保条件对可实现,我们从已有开放许可数据集中选择初始参考视频:驾驶来自 [11](CC BY-NC-SA 4.0),机器人来自 [41](Apache 2.0),人类活动来自 [10](MIT 许可)。这些数据集已有类别,我们选其常见类别作为子领域。其他领域的参考视频来自 [40];用 GPT-4o [2] 为视频生成描述、按领域关键词筛选,并选择其中最常见的子领域。
2. 获取文本与图像条件。每个参考视频的首帧作为图像条件。用 GPT-4o [2] 描述首帧与后续帧之间的变化,把它作为动作;同时重新描述图像条件,以支持 T2V。我们细致设计提示,使 T2V 模型对视频有连贯理解,例如保证动作里提及的物体也出现在首帧描述中。
3. 人工参与核验。前两步可能引入错误:有些视频的首帧是黑屏,GPT-4o 描述并不总是准确,有些视频不具备可供评分标准判断的潜在违规。因此,我们人工检查全部 350 对图像与文本条件,确保其质量。
3.3. 获得可靠的世界建模评判器
大语言模型和视觉语言模型在聊天助手等领域与人类评判已较为一致 [17, 64],但这种能力是否能扩展到世界建模、特别是物理规律理解,仍不清楚。为对现有视频生成模型得出可靠结论,我们开展大规模人工标注。每次投票都要求标注者选择第 3.1 节的全部标准;一次完整标注含 8 个标签。一个生成视频可能收到多个投票,因此可以计算人工一致性来验证质量。
投票统计。表 4 汇总了学生志愿者提供的 8336 次完整投票,共约 6.7 万个标签。87.1% 的投票之间总分绝对差在 2 分以内。为与偏竞技场式的相关工作比较,我们把投票转换为成对比较:对同一提示的模型视频比较总分,将相同胜负结果的概率记为成对一致率。我们得到 70%,与 Bansal 等 [4] 的 70%–75%、Chiang 等 [17] 的 72.8%–83.1% 相近。
此外,我们选取 10 位至少具有计算机科学博士水平的专家,计算专家投票均值上下一个标准差的区间。96.2% 的专家投票和 95.4% 的众包投票落入区间,支持众包投票的质量。
| 基本统计 | 值 | 一致性统计 | 值 |
|---|---|---|---|
| 完整投票数 | 8336 | 成对一致率 | 70.0% |
| 标注者数 | 65 | 评分一致率(±2) | 87.1% |
| 每个视频投票数 | 1.70 | 专家一致率(±σ) | 96.2% |
| 标签数 | 67K | 众包一致率(±σ) | 95.4% |
自动评估微调。为评估未来发布的模型,我们在收集的标注 [51] 上微调一个视觉语言模型。一次投票处理为 8 个问答对:模型接收文本及图像条件、生成视频,输出第 3.1 节各标准的分数。每个提示随机选择 12 个模型生成的视频作训练集,剩余作测试集,结果见第 4 节。我们发现,现有领先的专有视觉语言模型 GPT-4o 在世界模型理解上已有不错表现,构成 VLM-as-a-judge 的新用例;我们的评判器只有 20 亿参数,却能更高效地取得较高准确率。
3.4. 利用微调评判器对齐
基于互联网规模视觉与文本数据训练的 VLM 具有广泛世界知识和较强推理能力,因此有潜力充当“世界模型教师”。我们在人工数据上微调的 VLM 评判器可以提供现实世界反馈,帮助视频生成模型成为更准确的世界模拟器。我们提出可微分的“从反馈学习”方法,用自回归评判器改进预训练视频扩散模型。
基于 VADER [44],给定预训练视频扩散模型 pθ(·)、自回归奖励模型 R(·)、评分标准集合 G 和条件数据集 Dc,训练目标为最大化世界模型评判器的奖励:
J(θ) = E[c ∼ Dc, x₀ ∼ pθ(x₀ | c)] [ Σ[g ∼ G] R(x₀, c, g) ]。 (1)
x₀ 表示生成视频。奖励模型按指令遵循、物理规律遵循和常识来评估,并直接把子奖励相加。语言模型的离散输出会使过程不可微,我们改为优化回答 token 的类别分布概率差,例如 p(token("No")) − p(token("Yes"));p(·) 是最终隐藏状态经 softmax 后的类别分布。由此能计算 ∇θR(x₀, c, g),反向传播更新视频生成模型参数。
译者注:上例的 No/Yes 概率差沿用原文;奖励符号应结合各问题的问法判断,不能一概理解成鼓励负面回答。
图 5:用微调评判器的稀疏奖励改善视频生成模型。实线为前向过程,虚线为梯度方向。(原图含第三方参考画面,见文末原论文 PDF 第 7 页。)
4. 实验
我们先展示、分析现有视频生成模型的结果(第 4.1 节):绝对平均分、成对 Elo 分数 [17, 16] 与分类分数,并沿用 [17] 的方法展示投票质量。随后评估微调评判器(第 4.2 节),包括预测人工标注的准确性,以及将其作为奖励模型使用奖励梯度方法后的质量改善。最后研究标注规模,以及本基准与 VBench [26] 的相关性(第 4.3 节)。
模型。我们主要测量 2024 年 11 月之前的 14 个模型。开放模型包括 OpenSora-v1.2(T2V、I2V)[65]、OpenSora-Plan-v1.3(T2V、I2V)[30]、T2VTurbo-v2 [34]、CogVideoX-5B(T2V、I2V)[59]、Pandora [56]、Mochi [3]。闭源模型包括 Luma-1.6 [37]、Runway-3.0 [46]、Minimax [39]、Kling-v1.5 [29] 以及 Mochi 的 API 版本 Mochi-official。开放模型使用推荐超参数,细节见附录;表 3 另评估 Veo3、Wan 2.1-T2V、Wan 2.1-I2V、ltx-T2V、ltx-I2V 五个较新模型 [20, 49, 21]。
| 模型(原文分类) | 指令遵循 | 逐帧质量 | 时间质量 | 牛顿定律 | 形变/质量 | 流体 | 不可穿透 | 重力 | 总分 |
|---|---|---|---|---|---|---|---|---|---|
| 真实视频 | 2.97 | 1.0 | 1.0 | 1.0 | 1.0 | 1.0 | 1.0 | 1.0 | 9.97 |
| [闭源] KLING [29] | 2.32 | 0.99 | 0.97 | 1.00 | 0.90 | 1.00 | 0.93 | 0.99 | 9.10 |
| [闭源] Minimax [39] | 2.28 | 0.99 | 0.93 | 1.00 | 0.86 | 0.99 | 0.88 | 0.99 | 8.92 |
| [闭源] Mochi-official [3] | 2.00 | 0.97 | 0.89 | 1.00 | 0.88 | 1.00 | 0.93 | 0.99 | 8.66 |
| [闭源] Runway [46] | 2.17 | 0.99 | 0.87 | 1.00 | 0.77 | 0.98 | 0.89 | 0.96 | 8.64 |
| [闭源] Luma [37] | 1.98 | 0.96 | 0.81 | 1.00 | 0.70 | 0.98 | 0.87 | 0.95 | 8.24 |
| [开放] OpenSoraPlan-T2V [30] | 1.72 | 0.83 | 0.85 | 1.00 | 0.77 | 0.99 | 0.91 | 0.98 | 8.04 |
| [开放] Mochi [3] | 2.06 | 0.78 | 0.68 | 0.99 | 0.63 | 0.99 | 0.79 | 0.98 | 7.91 |
| [开放] CogVideoX-T2V [59] | 2.03 | 0.75 | 0.60 | 0.99 | 0.58 | 0.99 | 0.73 | 0.98 | 7.65 |
| [开放] CogVideoX-I2V [59] | 1.78 | 0.61 | 0.52 | 1.00 | 0.52 | 0.99 | 0.68 | 0.99 | 7.08 |
| [开放] Pandora [56] | 1.56 | 0.49 | 0.53 | 1.00 | 0.55 | 0.98 | 0.79 | 0.99 | 6.90 |
| [开放] T2V-Turbo [34] | 1.37 | 0.64 | 0.44 | 0.99 | 0.41 | 0.99 | 0.73 | 0.98 | 6.56 |
| [开放] OpenSora-T2V [65] | 1.61 | 0.40 | 0.29 | 0.98 | 0.30 | 0.98 | 0.64 | 0.97 | 6.17 |
| [开放] OpenSora-I2V [65] | 1.42 | 0.36 | 0.18 | 0.98 | 0.22 | 0.98 | 0.68 | 0.98 | 5.82 |
| 模型(原文分类) | 指令遵循 | 逐帧质量 | 时间质量 | 牛顿定律 | 形变/质量 | 流体 | 不可穿透 | 重力 | 总分 |
|---|---|---|---|---|---|---|---|---|---|
| Veo3 | 2.57 | 0.99 | 0.91 | 1.00 | 0.85 | 0.99 | 0.87 | 0.99 | 9.18 |
| Wan 2.1-T2V [49] | 2.30 | 0.99 | 0.96 | 1.00 | 0.86 | 0.99 | 0.95 | 1.0 | 9.04 |
| Wan 2.1-I2V [49] | 2.03 | 0.99 | 0.83 | 1.00 | 0.80 | 0.98 | 0.86 | 1.0 | 8.78 |
| ltx-T2V [21] | 2.38 | 0.93 | 0.83 | 1.00 | 0.80 | 0.98 | 0.86 | 1.0 | 8.78 |
| ltx-I2V [21] | 2.06 | 0.85 | 0.85 | 1.00 | 0.78 | 1.0 | 0.9 | 0.99 | 8.43 |
4.1. 评估结果
本节分析受评模型表现和投票质量。表 5 是各模型在全部提示上的平均人工分数,我们有四项主要观察。
| 模型(原文分类) | 指令遵循 | 逐帧质量 | 时间质量 | 牛顿定律 | 形变/质量 | 流体 | 不可穿透 | 重力 | 总分 |
|---|---|---|---|---|---|---|---|---|---|
| [闭源] KLING [29] | 2.36 | 0.94 | 0.92 | 0.93 | 0.88 | 0.96 | 0.89 | 0.93 | 8.82 |
| [闭源] Minimax [39] | 2.29 | 0.91 | 0.88 | 0.93 | 0.81 | 0.96 | 0.86 | 0.94 | 8.59 |
| [闭源] Mochi-official [3] | 2.01 | 0.89 | 0.83 | 0.94 | 0.82 | 0.99 | 0.92 | 0.98 | 8.37 |
| [闭源] Runway [46] | 2.15 | 0.87 | 0.78 | 0.91 | 0.69 | 0.94 | 0.82 | 0.91 | 8.08 |
| [闭源] Luma [37] | 2.01 | 0.81 | 0.76 | 0.89 | 0.62 | 0.95 | 0.77 | 0.90 | 7.72 |
| [开放] Mochi [3] | 2.22 | 0.63 | 0.63 | 0.94 | 0.58 | 0.97 | 0.71 | 0.94 | 7.62 |
| [开放] OpenSoraPlan-T2V [30] | 1.79 | 0.70 | 0.77 | 0.9 | 0.66 | 0.97 | 0.89 | 0.93 | 7.61 |
| [开放] CogVideoX-T2V [59] | 2.11 | 0.60 | 0.51 | 0.91 | 0.52 | 0.96 | 0.74 | 0.95 | 7.31 |
| [开放] CogVideoX-I2V [59] | 1.89 | 0.56 | 0.43 | 0.87 | 0.43 | 0.96 | 0.66 | 0.96 | 6.75 |
| [开放] OpenSora-Plan-I2V [30] | 1.77 | 0.47 | 0.54 | 0.84 | 0.42 | 0.97 | 0.70 | 0.92 | 6.62 |
| [开放] Pandora [56] | 1.56 | 0.42 | 0.53 | 0.91 | 0.50 | 0.96 | 0.74 | 0.94 | 6.57 |
| [开放] T2VTurbo [34] | 1.33 | 0.49 | 0.43 | 0.88 | 0.42 | 0.96 | 0.75 | 0.96 | 6.22 |
| [开放] OpenSora-T2V [65] | 1.71 | 0.40 | 0.33 | 0.89 | 0.32 | 0.95 | 0.60 | 0.92 | 6.11 |
| [开放] OpenSora-I2V [65] | 1.60 | 0.37 | 0.25 | 0.90 | 0.25 | 0.92 | 0.60 | 0.94 | 5.83 |
与理想视频世界模型仍有很大差距。最高分模型 Kling 只有 61% 的视频正确完成指定任务;12% 违反质量守恒,11% 出现物体相互穿透。这表明它尚未完整理解物理物体属性。
更好的常识指标不等于更好的视频世界模型。Luma 的逐帧质量(0.81 对 0.63)和时间质量(0.76 对 0.63)高于最好的开放模型 Mochi,但其指令遵循差得多:完成任务的视频为 44%,Mochi 为 53%;物理规律遵循接近(4.13 对 4.14)。此前基准 [26] 主要关注常识,我们的结果指出了训练时还需要考虑的其他维度。
I2V 模型弱于相应 T2V 模型。这一趋势出现在三对模型中:CogVideoX 为 7.31 对 6.75,OpenSora-Plan 为 7.62 对 6.62,OpenSora 为 6.11 对 5.83,需要进一步改进已发布的 I2V 版本。
译者注:正文把 OpenSora-Plan 的 T2V 分数写为 7.62,表 5 对应值为 7.61;保留两处原值,不替作者统一。这里的趋势只指论文测量的版本和条件。
头部开放模型有竞争力。Mochi 与 OpenSora-Plan 的总分为 7.62、7.61,接近闭源 Luma 的 7.72;尤其 Mochi 的指令遵循和物理规律遵循能力具有潜力。
成对比较。我们枚举同一提示下的所有模型组合,把标注转为成对结果。沿用 [17],以 Bradley–Terry 模型和 100 轮自助采样计算 Elo,以 OpenSora 的 800 分为校准。图 6 显示各能力之间存在取舍,例如 Mochi-official 的物理规律遵循最高,指令遵循却居中。
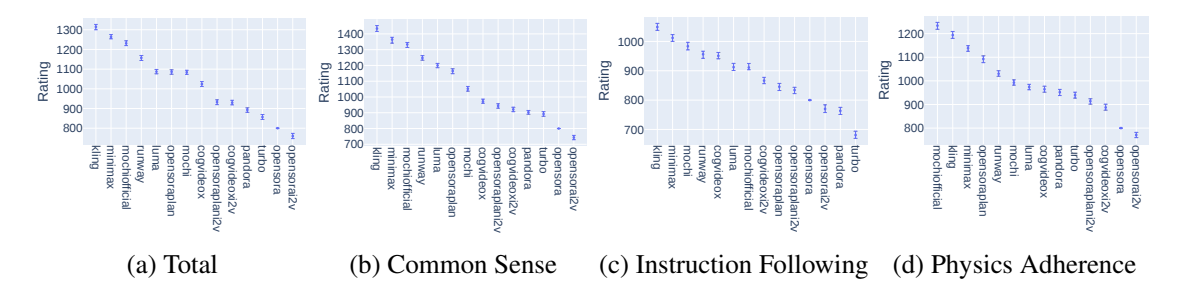
图 6:WorldModelBench 各类别的模型 Elo 评分。
子领域细分。图 7 以热图展示 56 个子领域上的总分。大多数模型在自动驾驶、人类活动和机器人上表现困难,例如人抛掷物体或跳跃。这些领域需要复杂的环境交互和准确的主体建模,例如人体。多数模型在植物、动物和水体等自然领域表现较好,需要新一代模型针对困难类别改进。
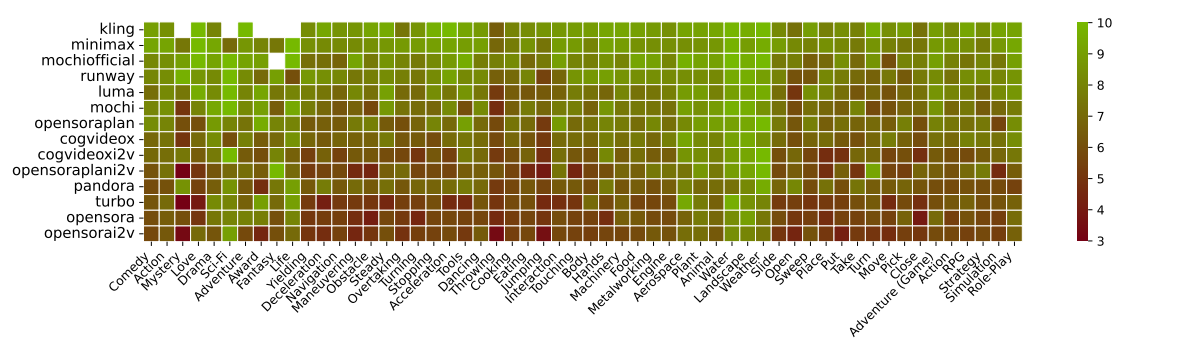
图 7:各模型在全部子领域的总分。越红分数越低,越绿分数越高;白色为专有模型拒绝响应造成的缺失值。
4.2. 微调评判器的质量
我们从两个方面展示评判器质量:一是与领先 VLM GPT-4o 及其不同策略在测试集上比较准确性;二是展示用其分数改进 OpenSora-T2V。
测试集准确性。每个提示使用来自 14 个视频模型的视频,以及最多 3 位不同标注者的标注。随机选 12 个模型的输出,加上原始参考视频——它提供文本提示和首帧条件,获得满分奖励——构建训练集,另外 2 个模型留作测试。训练样本混合高、低奖励视频,让评判器能区分质量,并为相同提示下尚未见过的视频预测分数。
训练集共 4421 个视频,每个视频有 8 项人工标签;评估集有 713 个视频,排除了部分被闭源 API 拒绝的样本。对多个投票的提示,以多数意见作为稀疏标签的真值。为增强与世界知识和推理过程的对齐,我们要求 GPT-4o 和 Gemini-1.5-Pro 为训练样本生成推理链,只保留最终答案正确的推理链,作为额外训练数据。随后与 GPT-4o 的零样本、思维链提示 [53] 等解码策略比较。
| 模型/方法 | 指令遵循 ↓ | 常识 ↓ | 物理规律遵循 ↓ |
|---|---|---|---|
| GPT-4o | 29.3 | 35.0 | 36.0 |
| GPT-4o +CoT | 29.7 | 28.5 | 45.6 |
| Gemini-1.5-Pro | 30.7 | 34.5 | 29.3 |
| Gemini-1.5-Pro +CoT | 29.3 | 19.5 | 28.3 |
| Qwen2-VL-2B | 30.3 | 39.0 | 39.7 |
| VILA-2B +Zero-Shot | 21.0 | 28.0 | 24.0 |
| VILA-2B +CoT Fine-tuned | 32.3 | 16.4 | 29.7 |
表 6 显示微调的世界模型评判器比 GPT-4o 准确。表 10 和附录 A.4 进一步对照人工与评判器分数。作为奖励模型时,我们把第 3.4 节算法应用到 OpenSora-v1.2 T2V,图 8 展示定性样本,为未来继续改善奖励模型提供积极信号。
译者注:表 6 中并不是每一项微调设置都在每个维度优于 GPT-4o,例如 CoT 微调项的指令错误率为 32.3%。这里保留原作者总体表述,不能把它改写为所有配置、所有维度均获胜。
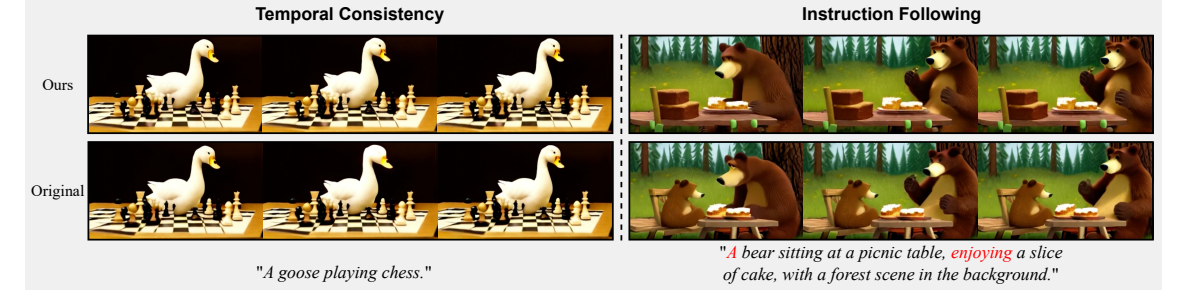
图 8:世界模型梯度方法带来的改善。原始 OpenSora 1.2 与奖励微调版本对照:学习世界模型奖励缓解了左侧视频闪烁及右侧指令不遵循,更多结果见图 11。
译者注:原文图 8 图注两次写“底行”;图内明确标 Ours 在上、Original 在下,本中文图注依据图内标签区分,保留原图不修改。
4.3. 与既有基准的相关性
图 1 展示 WorldModelBench 相对一般视频质量基准的动机。本节与 VBench [25] 深入比较。对 OpenSora、Pandora、Luma、Minimax、Mochi、CogVideoX、Kling、Runway 在本基准条件下生成的视频,使用 VBench 的评分流程。对每对模型,平均相同文本及图像条件下的胜负得到成对胜率:
W[A,B] = (1 / |prompts|) Σ[p ∈ prompts] 𝟙(eval[A,p] > eval[B,p])。其中指示函数在 A 的分数大于 B 时为 1,否则为 0。
图 9a、9b 中每点为两个模型的胜率:横轴按 VBench,纵轴按 WorldModelBench。图 9a 只评逐帧质量;图 9b 在 WorldModelBench 上评物理规律遵循、在 VBench 上评全部维度。逐帧质量胜率相关系数为 0.69,较强的相关表明两者都能评一般视频质量,我们的基准与既有标准一致。但物理规律遵循的相关性降至 0.28,表明 VBench 不能有效依据物理遵循区分视频。补充材料还分析了 VBench 其他维度,也显示它们不能据此区分。
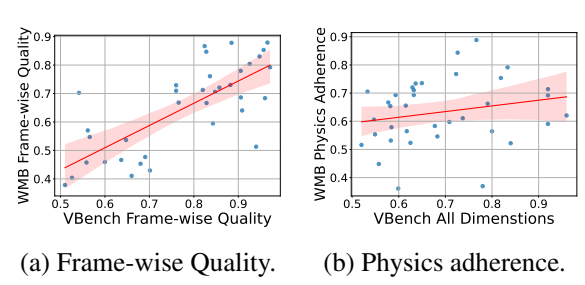
图 9:人工标注与自动指标之间的相关性:(a)逐帧质量;(b)物理规律遵循。
5. 结论
本文提出 WorldModelBench,用于评估视频世界模型。我们发现,一般视频质量基准不足以评估物理规律遵循等世界建模能力。WorldModelBench 从常识、指令遵循和物理规律遵循三个维度,向现有视频生成模型提供细粒度反馈。我们收集 6.7 万个人工标签,分析现有视频生成模型作为世界模型的表现,进一步微调 VLM 来准确地自动评判,并展示最大化评判器奖励有望改善世界建模能力。
6. 致谢
我们感谢 MIT 6.5940 课程(2024 年秋季)的学生志愿者,以及 MIT 的 Qinghao Hu、Guangxuan Xiao、Jiaming Tang、Muyang Li、Shang Yang、Yujun Lin、Zhuoyang Zhang、Haotian Tang、Han Cai、Jinyi Hu、Yuxian Gu、Liuning He,NVIDIA 的 Enze Xie,加州大学伯克利分校的 Xiuyu Li、Ziming Mao,以及 NTU 的 Zeqi Xiao,帮助建立标注流程并参与有益的技术讨论。
附录 A.1. 与 VBench 各维度的相关性
第 4.3 节展示了两基准逐帧质量胜率的高相关(0.69),以及 WorldModelBench 物理遵循与 VBench 总分胜率的低相关(0.28)。这里分析物理遵循与 VBench 其他维度的相关性。我们比较支持自定义视频的全部 VBench 维度:主体一致性、背景一致性、运动平滑度、动态程度、审美质量、成像质量。使用第 4.3 节相同指标,计算各维度模型胜率与物理遵循胜率的相关。
| VBench 维度 | 相关系数 |
|---|---|
| 主体一致性 | 0.15 |
| 背景一致性 | 0.19 |
| 运动平滑度 | 0.34 |
| 动态程度 | -0.05 |
| 审美质量 | 0.41 |
| 成像质量 | 0.24 |
表 7 和图 10 中,最高相关系数为审美质量的 0.41,最低为动态程度的 −0.05,都明显低于逐帧质量的 0.69。这进一步支持 VBench 不能有效依据物理遵循区分视频,也突出了本基准评估物理真实感的价值。
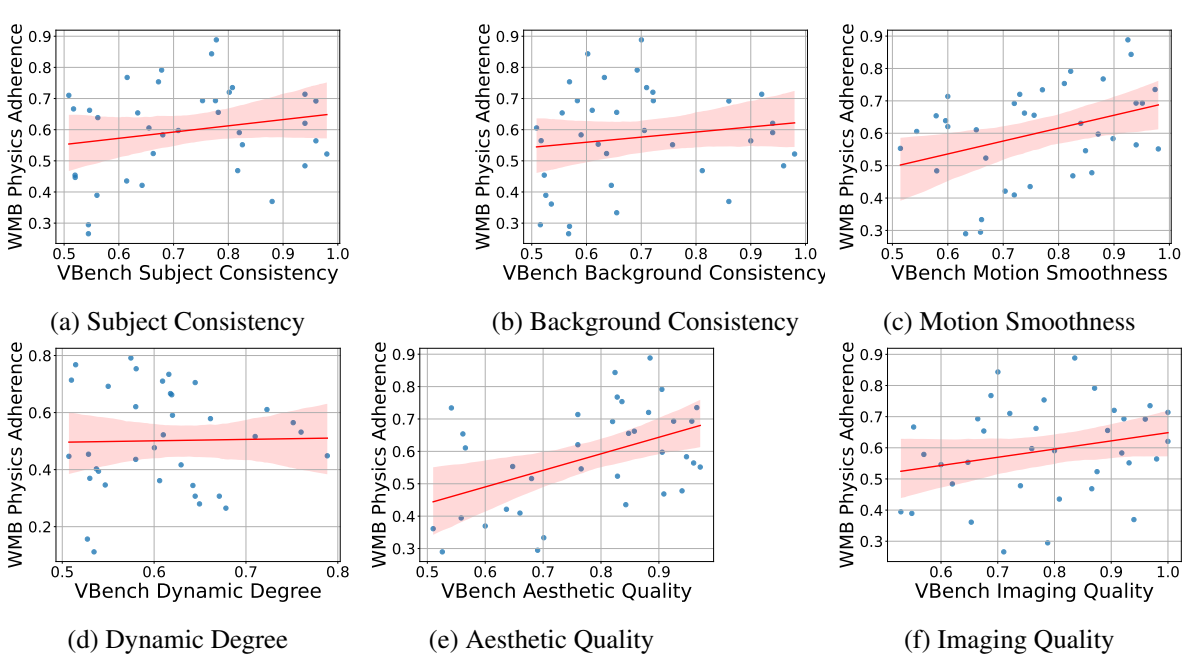
图 10:VBench 各维度模型胜率与 WorldModelBench 物理规律遵循胜率之间的相关性。
附录 A.2. 奖励优化的更多示例
图 11 展示基于世界模型评判反馈优化的更多结果。方法有望利用世界模型反馈增强指令遵循、物理规律遵循及审美质量,仍有继续探索空间。
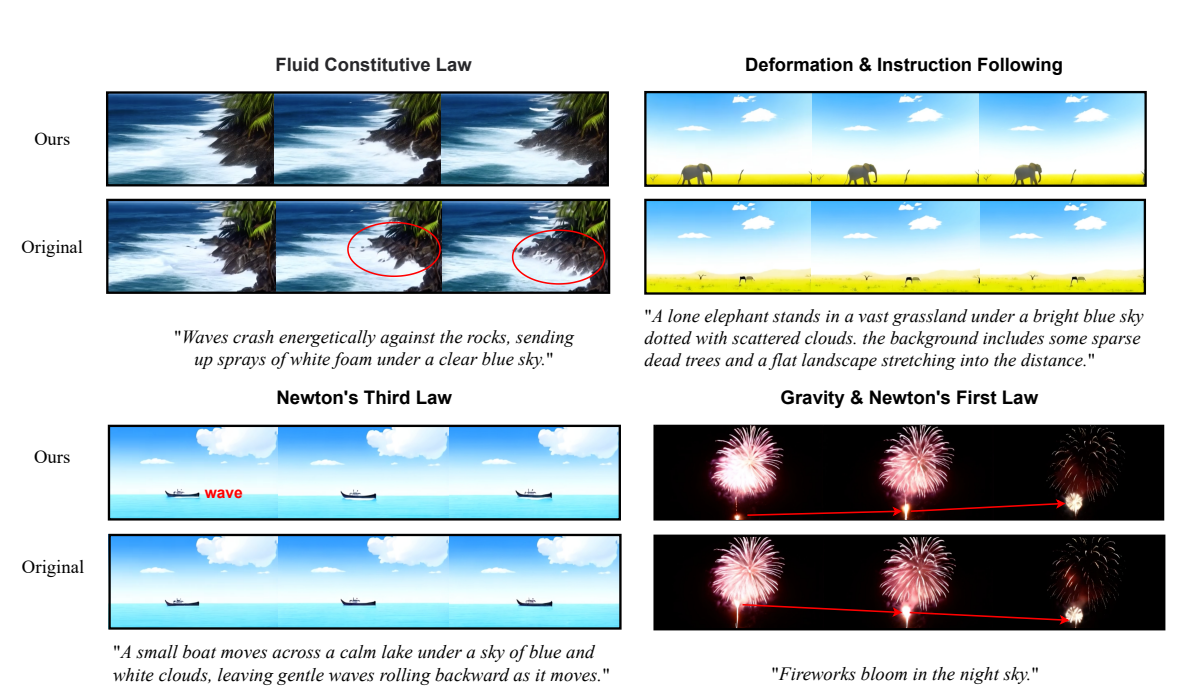
图 11:Original 为原始 OpenSora 1.2,Ours 为奖励微调版本。奖励组合微调改善物理表现:(左上)减轻流体黏滞异常;(右上)减轻形变;(左下)模拟牛顿第三定律对应的波浪;(右下)纠正惯性违规。
附录 A.3. 模型推理细节
以下是第 4 节开放模型的推理设置。CogVideoX [59]:使用 CogVideoX-5B 的 T2V、I2V,遵循官方用法,分类器引导比例为 6.0,DDIM 求解器 50 步。
Open-Sora [65]:按官网推荐,720P,4 秒,宽高比 9:16,采样 30 步,flow 阈值 5.0,审美阈值 6.5。Pandora [56]:官方检查点与 GitHub 默认设置,DDIM 50 步。Mochi [3]:默认设置,CFG scale 4.5,采样 65 步。
T2V-Turbo [34]:按官方用法,采样 4 步,无分类器引导比例 7.5,16 fps、16 帧。Open-Sora-Plan [30]:按官方用法,18 fps,引导比例 7.5,采样 100 步,高度 352、宽度 640。
附录 A.4. 评判器对指令遵循的可靠性
我们计算评判器预测与人工标注的 Kendall 秩相关,得到 τ = 0.96,最大值为 1。表 8 对照指令遵循分数,平均预测误差为 2.79%。
| 模型 | 人工 H ↑ | 评判器 J ↑ | 预测误差 |
|---|---|---|---|
| [闭源] kling | 2.36 | 2.31 | -2.12% |
| [闭源] minimax | 2.29 | 2.28 | -0.44% |
| [闭源] mochi-official | 2.01 | 2.00 | -0.50% |
| [闭源] runway | 2.15 | 2.17 | 0.93% |
| [闭源] luma | 2.01 | 1.98 | -1.49% |
| [开放] mochi | 2.22 | 2.06 | -7.21% |
| [开放] OpenSoraPlan-T2V | 1.79 | 1.72 | -3.91% |
| [开放] CogVideoX-T2V | 2.11 | 2.03 | -3.79% |
| [开放] CogVideoX-I2V | 1.89 | 1.78 | -5.82% |
| [开放] OpenSora-Plan-I2V | 1.77 | 1.76 | -0.56% |
| [开放] pandora | 1.56 | 1.56 | 0.00% |
| [开放] T2VTurbo | 1.33 | 1.37 | 3.01% |
| [开放] OpenSora-T2V | 1.71 | 1.61 | -5.85% |
| [开放] OpenSora-I2V | 1.60 | 1.42 | -11.25% |
附录 A.5. WorldModelBench-Hard
依据之前的投票,我们整理较小的困难子集 WorldModelBench-Hard,便于模型评估。它包含五个闭源模型平均分最低的 45 个提示;表 9 对照全部模型在此子集上的分数。表现最好的 Kling 下降 1.21 分,从 9.08 降到 7.87。这些题目评估成本较低,又足够困难,能区分模型。
| 模型 | 完整数据集 | 困难子集 |
|---|---|---|
| [闭源] kling | 9.08 | 7.87 |
| [闭源] minimax | 8.92 | 7.27 |
| [闭源] mochi-official | 8.66 | 7.24 |
| [闭源] runway | 8.63 | 7.31 |
| [闭源] luma | 8.24 | 6.58 |
| [开放] mochi | 7.91 | 6.93 |
| [开放] OpenSoraPlan-T2V | 8.04 | 7.04 |
| [开放] CogVideoX-T2V | 7.65 | 6.13 |
| [开放] CogVideoX-I2V | 7.08 | 6.27 |
| [开放] OpenSora-Plan-I2V | 6.86 | 5.67 |
| [开放] pandora | 6.90 | 6.49 |
| [开放] T2VTurbo | 6.56 | 5.64 |
| [开放] OpenSora-T2V | 6.17 | 4.82 |
| [开放] OpenSora-I2V | 5.82 | 4.71 |
译者注:附录表 9、10 使用 Kling 9.08、Runway 8.63,正文表 2 分别为 9.10、8.64;表 10 的 OpenSora-Plan-I2V 人工总分为 6.63,表 5 为 6.62。译稿按各表原值保留。
| 模型 | 人工 H ↑ | 评判器 J ↑ | 预测误差 |
|---|---|---|---|
| [闭源] kling | 8.82 | 9.08 | 2.95% |
| [闭源] minimax | 8.59 | 8.92 | 3.84% |
| [闭源] mochi-official | 8.37 | 8.66 | 3.46% |
| [闭源] runway | 8.08 | 8.63 | 6.81% |
| [闭源] luma | 7.72 | 8.24 | 6.74% |
| [开放] mochi | 7.62 | 7.91 | 3.81% |
| [开放] OpenSoraPlan-T2V | 7.61 | 8.04 | 5.65% |
| [开放] CogVideoX-T2V | 7.31 | 7.65 | 4.65% |
| [开放] CogVideoX-I2V | 6.75 | 7.08 | 4.89% |
| [开放] OpenSora-Plan-I2V | 6.63 | 6.86 | 3.47% |
| [开放] pandora | 6.57 | 6.90 | 5.02% |
| [开放] T2VTurbo | 6.22 | 6.56 | 5.47% |
| [开放] OpenSora-T2V | 6.11 | 6.17 | 0.98% |
| [开放] OpenSora-I2V | 5.83 | 5.82 | -0.17% |
附录 A.6. 局限
本节讨论论文中若干潜在局限和假设。与 VideoPhy 比较:VideoPhy 聚焦日常物体,它们并非与世界模型最相关的领域 [4]。我们直接测量机器人等应用领域的表现;此外,WorldModelBench 支持 I2V,并将开源细粒度标签。
样本规模。WorldModelBench 的规模明显小于其他视频基准,例如 VideoPhy 为 688 个样本。考虑到现有模型推理成本高,例如 Mochi 在 4 张 A100 上生成一次需要 5 分钟,我们选择减少提示数量,使评估更快。尽管如此,它仍有指示性:最好的两个专有模型分数已有明确差距,为 8.82 对 8.59。
译者注:原文此处把比较指向表 3,但这两个分数实际出现在人工评分表 5。附录 A.2 的图 11 与图 12 在 PDF 排版中位于本附录末尾;本译稿把图 11 放回对应说明,图 12 保留于此。
图 12:人工标注界面。(原图含第三方参考画面,见文末原论文 PDF 第 18 页。)
原文与来源
- WorldModelBench:NeurIPS 2025 正式论文(正文、图表与附录) ↗
- NeurIPS 2025 正式出版信息与原 PDF ↗
- WorldModelBench:2025 年 2 月 arXiv v1 与其 CC BY 4.0 许可入口 ↗
- OpenReview:WorldModelBench 正式会议版与 CC BY 4.0 许可 ↗
图片:Dacheng Li 等 · WorldModelBench(NeurIPS 2025)· CC BY 4.0 · 原图图内内容未改动