
版本与译文说明
原题:Diffusion for World Modeling: Visual Details Matter in Atari(用于世界建模的扩散:Atari 中的视觉细节很重要)。原作者:Eloi Alonso、Adam Jelley、Vincent Micheli、Anssi Kanervisto、Amos Storkey、Tim Pearce、François Fleuret。Alonso 与 Jelley 为共同第一作者,Pearce 与 Fleuret 为共同指导作者。论文发表于 NeurIPS 2024,Spotlight;本译稿固定采用作者的 arXiv v2,更新于 2024 年 10 月 30 日,并与会议官方 PDF 核对正文图表。译者:世界模型图谱。
翻译范围为摘要、正文第1—9节、致谢和附录A—G,含全部6幅正文原图、正文表1、附录表2—3与算法1。原参考文献书目、附录H—M的额外比较、训练时间、误差及三维实验保留原文入口;本篇不声称覆盖这些未译部分。正文对未译附录的指引仍按原文保留。原文说明,CS:GO 一节是在 NeurIPS 接收之后,因社区对后续实验的兴趣而加入的。
正文中的“我们”均指原作者,最佳成绩与比较判断属于论文发表时的实验语境,本站没有独立复现。固定版本在 arXiv 明示 CC BY 4.0;本中文译文为翻译及排版改编,也按 CC BY 4.0 提供。原图从固定版本 PDF 提取完整图版,不改图内文字、面板及比例;中文图注另写。重复署名、许可及来源统一见文末。
摘要
世界模型为以安全、样本高效的方式训练强化学习智能体提供了一条有前景的路径。近期的世界模型主要在离散潜在变量序列上运作,以此建模环境动力学。然而,压缩成紧凑的离散表示,可能忽略对强化学习重要的视觉细节。与此同时,扩散模型已成为图像生成的主流方法,挑战了成熟的离散潜变量建模方法。受这一范式转变启发,我们提出 DIAMOND(DIffusion As a Model Of eNvironment Dreams),一种在扩散世界模型中训练的强化学习智能体。
我们分析了让扩散适用于世界建模所需的关键设计选择,并展示改进视觉细节如何带来更好的智能体表现。DIAMOND 在竞争激烈的 Atari 100k 基准上取得 1.46 的平均人类归一化分数,为完全在世界模型中训练的智能体创下当时的最佳结果。我们还在静态 Counter-Strike: Global Offensive 游戏数据上训练,展示 DIAMOND 的扩散世界模型可独立作为交互式神经游戏引擎。为支持后续研究,我们公开代码、智能体、视频与可玩的世界模型。
1 引言
环境的生成模型,也称“世界模型”(Ha 与 Schmidhuber,2018),日益成为通用智能体规划与推理环境的重要组成部分(LeCun,2022)。强化学习近年取得广泛成功(Silver 等,2016;Degrave 等,2022;Ouyang 等,2022),但样本效率低的问题限制了它在现实中的应用。世界模型已展现出在不同环境中训练强化学习智能体的潜力(Hafner 等,2023;Schrittwieser 等,2020),显著提高样本效率(Ye 等,2021),从而有望让智能体从现实世界经验中学习(Wu 等,2023)。
近期的世界建模方法常把环境动力学建模为离散潜在变量序列(Hafner 等,2021;Micheli 等,2023;Robine 等,2023;Hafner 等,2023;Zhang 等,2023)。潜在空间离散化有助于抑制多步预测的误差累积,但编码可能损失信息,降低通用性和重建质量。在任务所需信息不那么明确的现实场景中,例如训练自动驾驶车辆,这可能成为问题。输入中很小的细节,如远处的交通灯或行人,也可能改变策略。增加离散潜变量数量能够缓解这种有损压缩,但会增加计算成本。
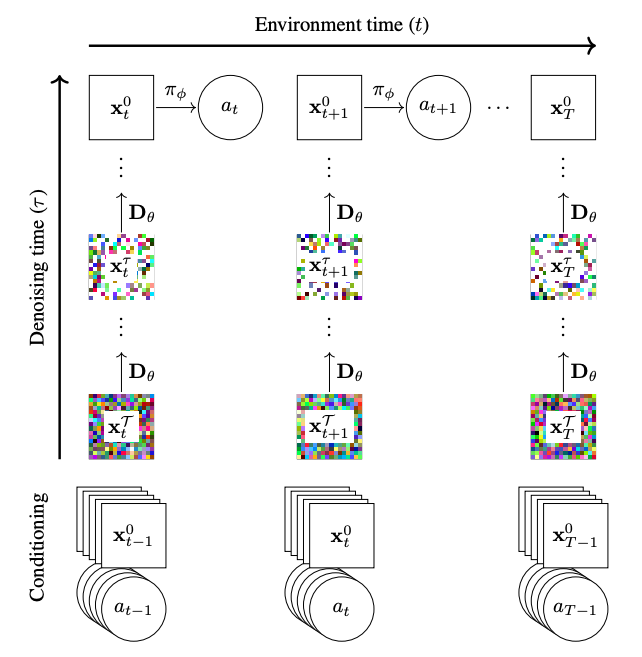
图1:DIAMOND 的想象随时间展开。横轴为环境时间t,纵轴为从T反向走向0的去噪时间τ。策略πϕ在预测环境中行动;模型从带噪样本出发,以干净历史观察和动作为条件反复去噪,得到下一帧。预测观察与新动作随后成为下一步的条件,因此想象过程是自回归的。动态图见原项目页。
与此同时,通过学习逆转加噪过程的扩散模型,已成为高分辨率图像生成的主流范式。这一类方法挑战了成熟的离散 token 方法,为减轻世界建模中的离散化需求提供了另一条路径。扩散模型还容易接受条件,能够灵活建模复杂的多模态分布而不发生模式坍塌。这些特性对于世界模型很重要:忠实响应条件,能让预测更紧密地反映智能体动作,使信用分配更可靠;建模多模态分布,则可为智能体提供更丰富的训练场景。
据此,我们提出在扩散世界模型中训练的强化学习智能体 DIAMOND。为了让模型高效且在长时间跨度中稳定,需要谨慎选择设计,我们以定性分析说明其重要性。DIAMOND 在 Atari 100k 上取得平均人类归一化分数 1.46,为完全在世界模型内部训练的智能体创下新的当时最佳成绩。直接在图像空间运作还使模型能够直接替代环境,让我们更容易观察模型和智能体行为。我们发现,一些游戏中更好的表现,与关键视觉细节得到更好建模有关。
为进一步检验独立世界模型的效果,我们还用 87 小时的静态 CS:GO 游戏数据(Pearce 与 Zhu,2022)训练扩散模型,针对地图 Dust II 构建了一个可交互的神经游戏引擎。代码、智能体和可玩的世界模型均在原项目页公开。原文脚注说明,本文是 Alonso 等(2023)工作的最终版本,与 Ding 等(2024)的工作无关。
2.1 强化学习与世界模型
我们用标准的部分可观测马尔可夫决策过程(POMDP)描述环境,记为(S,A,O,T,R,𝒪,γ)。S为状态集合,A为离散动作集合,O为图像观察集合。转移函数T:S×A×S→[0,1]描述环境动力学p(sₜ₊₁|sₜ,aₜ);奖励函数R:S×A×S→ℝ将转移映射为标量奖励。智能体不能直接访问状态sₜ,只能通过按观察概率p(xₜ|sₜ)产生的图像xₜ∈O观察环境,观察函数为𝒪:S×O→[0,1]。
目标是得到从观察映射到动作的策略π,使期望折扣回报Eπ[Σₜ≥₀γᵗrₜ]最大,γ∈[0,1]为折扣因子。世界模型是环境的生成模型,即p(sₜ₊₁,rₜ|sₜ,aₜ)的模型。它们可作为模拟环境,以较高样本效率训练强化学习智能体(Sutton,1991;Wu等,2023)。
这一范式的训练通常循环执行三个步骤:强化学习智能体在真实环境中采集数据;用全部已采集数据训练世界模型;再在世界模型环境中训练智能体,通常称为“在想象中”训练。
2.2 基于得分的扩散模型
扩散模型是一类受非平衡热力学启发的生成模型,通过逆转加噪过程生成样本。考虑由连续时间变量τ∈[0,T]索引的扩散过程{x^τ},对应边缘分布{p^τ},边界条件为p⁰=p_data、pᵀ=p_prior。p_prior是易处理的无结构先验,如高斯分布。为与环境时间区分,扩散时间用τ及上标,环境时间用t及下标。
这一扩散过程可写为标准随机微分方程(SDE)的解(Song等,2020):dx=f(x,τ)dτ+g(τ)dw。(1)其中w是维纳过程,即布朗运动,向量函数f是漂移系数,标量函数g为扩散系数。
为得到从噪声映射到数据的生成模型,我们必须逆转这个过程。Anderson(1982)证明,反向过程仍是扩散过程,时间反向运行,满足:dx=[f(x,τ)−g(τ)²∇ₓlog p^τ(x)]dτ+g(τ)dŵ。(2)ŵ是反向时间维纳过程,∇ₓlog p^τ(x)为Stein得分函数,即对变量求对数边缘分布的梯度。因此,需要定义f和g,并估计各个τ对应的未知得分。实际中可用一个随时间变化的得分模型Sθ(x,τ)进行估计。
真实得分函数不可访问,所以估计它并不直接。Hyvärinen(2005)提出得分匹配目标,使模型可以只用数据样本训练,而不必知道真实得分。我们只有干净数据样本,为获得边缘分布p^τ中的样本,一般需要从0模拟到τ;但若f是仿射函数,就能对干净样本施加高斯扰动核p^(0τ),一步解析到达任意τ。因为扰动核可微,得分匹配简化为去噪得分匹配(Vincent,2011):
ℒ(θ)=E[‖Sθ(x^τ,τ)−∇_(x^τ)log p^(0τ)(x^τ|x⁰)‖²]。(3)期望涉及扩散时间τ、干净样本x⁰∼p_data,以及施加τ级扰动核得到的x^τ∼p^(0τ)(x^τ|x⁰)。
扰动核是已知高斯分布,因此目标可化成简单的L2重建损失:ℒ(θ)=E[‖Dθ(x^τ,τ)−x⁰‖²]。(4)重参数化为Dθ(x^τ,τ)=Sθ(x^τ,τ)σ²(τ)+x^τ。原文在此将σ(τ)称为τ级扰动核的方差。
译注:公式以x^τ表示带扩散时间上标τ的变量,以xₜ表示环境时间下标t的变量。原文式(4)后的variance表述按原意保留;在后续高斯核定义中,方差写为σ²(τ),σ为相应噪声尺度。
2.3 用于世界建模的扩散
上一节的得分扩散模型无条件建模p_data。要作为世界模型,我们需要环境动力学的条件生成模型p(xₜ₊₁|x≤ₜ,a≤ₜ)。在一般POMDP中,马尔可夫状态sₜ未知,可以从历史观察和动作近似。我们以历史为条件,让扩散模型直接估计并生成下一帧,如图1所示。式(4)因此变为:
ℒ(θ)=E[‖Dθ(xₜ₊₁^τ,τ,x≤ₜ⁰,a≤ₜ)−xₜ₊₁⁰‖²]。(5)训练时,从智能体的回放数据中采样轨迹片段(x≤ₜ⁰,a≤ₜ,xₜ₊₁⁰),向真实下一帧施加τ级扰动,得到带噪的xₜ₊₁^τ。其余与普通扩散过程类似,差别在于得分模型接受历史观察和动作条件。
采样下一帧时,迭代求解式(2)的反向SDE。原则上可选任意ODE或SDE求解器,但采样质量与函数评估次数(NFE)之间存在权衡;NFE直接决定扩散世界模型的推理成本。附录A对此进一步说明。
3.1 扩散范式的实际选择
在上述背景基础上,我们介绍扩散世界模型的具体实现DIAMOND。现在需要定义式(1)中的漂移和扩散系数f、g,也就是选定扩散范式。DDPM(Ho等,2020)是一种自然的历史选择,附录B解释了对应关系;但我们采用Karras等(2022)的EDM表述,实际影响见第5.1节。
扰动核取为p^(0τ)(xₜ₊₁^τ|xₜ₊₁⁰)=𝒩(xₜ₊₁^τ;xₜ₊₁⁰,σ²(τ)I),其中实值函数σ(τ)为噪声调度。对应f(x,τ)=0,g(τ)=√[2σ̇(τ)σ(τ)]。
沿用EDM的网络预条件化,将式(5)中的Dθ参数化为带噪观察与神经网络Fθ预测的加权和:Dθ(xₜ₊₁^τ,yₜ^τ)=c_skip^τxₜ₊₁^τ+c_out^τFθ(c_in^τxₜ₊₁^τ,yₜ^τ)。(6)为简洁起见,yₜ^τ≔(c_noise^τ,x≤ₜ⁰,a≤ₜ)包含全部条件变量。
c_in和c_out用于让网络输入、输出在任意噪声水平下保持单位方差;c_noise是噪声水平的经验变换;c_skip=σ_data²/[σ_data²+σ²(τ)],其中σ_data为数据分布标准差。全部预条件项见附录C。结合式(5)、(6),网络Fθ的训练目标可写为:
ℒ(θ)=E[‖Fθ(c_in^τxₜ₊₁^τ,yₜ^τ)−(xₜ₊₁⁰−c_skip^τxₜ₊₁^τ)/c_out^τ‖²]。(7)前一项为网络预测,后一项为训练目标。
这一目标随退化水平σ(τ)自适应混合信号和噪声。噪声远大于数据尺度时,c_skip趋于0,目标主要由干净信号xₜ₊₁⁰决定;噪声趋于0时,c_skip趋于1,目标转为干净信号与受扰信号之差,即加入的高斯噪声。这避免低噪声区域的任务变得过于简单。实际中,噪声调度两端的目标方差较高,因此EDM从经验选定的对数正态分布采样噪声水平,使训练集中于中等噪声区域,详见附录C。
Fθ使用标准二维U-Net。我们保留L个历史观察和动作作为条件,将历史观察与带噪下一帧按通道拼接,并通过U-Net残差块中的自适应组归一化层输入动作。训练后的模型可用多种方法采样;我们的代码支持不同方案,实验发现Euler方法已经有效,无须承担高阶采样器增加的NFE,也无须引入随机采样的额外复杂性。
3.2 在想象中进行强化学习
为在想象中训练强化学习智能体,我们还需要奖励和终止模型。两者属于标量预测问题,因此使用独立模型Rψ,以标准CNN和LSTM处理部分可观测性。智能体使用共享的CNN-LSTM网络,再接策略头和价值头。策略πϕ以带价值基线的REINFORCE训练,价值网络Vϕ以基于λ回报的贝尔曼误差训练,与Micheli等(2023)类似。
智能体完全在想象中训练,只在采集数据时与真实环境交互。每次采集后,用全部已有数据更新世界模型,再在更新后的模型环境里用强化学习训练智能体,反复执行。训练流程详见算法1,与Kaiser等(2019)、Hafner等(2020)、Micheli等(2023)类似。架构、超参数和强化学习目标分别见附录D、E、F。
4.1 Atari 100k 基准
为全面评估DIAMOND,我们采用已有的Atari 100k基准,由26款游戏组成,测试不同能力。每款游戏中,智能体在评估前只允许在环境执行10万次动作,约相当于人类玩游戏两小时。作为参照,不受这种限制的Atari智能体通常用5000万步训练,经验量是它的500倍。我们对每款游戏用5个随机种子从头训练DIAMOND,每次运行约需12GB显存,在单张Nvidia RTX 4090上约2.9天,总计约1.03 GPU年。
表1比较完全在世界模型中训练智能体的近期方法:STORM、DreamerV3、IRIS、TWM和SimPLe。附录J另外与无模型和搜索方法比较,包括当时在这个基准上表现最好的BBF、EfficientZero。它们使用与本方法正交、不能直接等同的技术,例如BBF结合周期性网络重置与超参数调度,EfficientZero使用计算昂贵的前瞻蒙特卡洛树搜索。将这些额外组件与本世界模型组合,是未来值得研究的方向。
4.2 Atari 100k 结果
表1列出每款游戏得分,以及人类归一化分数(HNS)的均值和四分位间均值(IQM)。考虑到点估计的局限,按Agarwal等(2021)的建议,图2给出分层bootstrap置信区间;性能分布与额外指标见附录H。
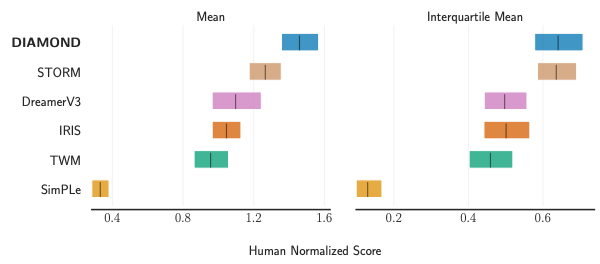
图2:平均与四分位间平均的人类归一化分数。蓝色DIAMOND的平均HNS约为1.46,IQM约为0.64;图中同时保留分层bootstrap置信区间。
| 游戏/指标 | 随机 | 人类 | SimPLe | TWM | IRIS | DreamerV3 | STORM | DIAMOND |
|---|---|---|---|---|---|---|---|---|
| Alien | 227.8 | 7127.7 | 616.9 | 674.6 | 420.0 | 959.0 | 983.6 | 744.1 |
| Amidar | 5.8 | 1719.5 | 74.3 | 121.8 | 143.0 | 139.0 | 204.8 | 225.8 |
| Assault | 222.4 | 742.0 | 527.2 | 682.6 | 1524.4 | 706.0 | 801.0 | 1526.4 |
| Asterix | 210.0 | 8503.3 | 1128.3 | 1116.6 | 853.6 | 932.0 | 1028.0 | 3698.5 |
| BankHeist | 14.2 | 753.1 | 34.2 | 466.7 | 53.1 | 649.0 | 641.2 | 19.7 |
| BattleZone | 2360.0 | 37187.5 | 4031.2 | 5068.0 | 13074.0 | 12250.0 | 13540.0 | 4702.0 |
| Boxing | 0.1 | 12.1 | 7.8 | 77.5 | 70.1 | 78.0 | 79.7 | 86.9 |
| Breakout | 1.7 | 30.5 | 16.4 | 20.0 | 83.7 | 31.0 | 15.9 | 132.5 |
| ChopperCommand | 811.0 | 7387.8 | 979.4 | 1697.4 | 1565.0 | 420.0 | 1888.0 | 1369.8 |
| CrazyClimber | 10780.5 | 35829.4 | 62583.6 | 71820.4 | 59324.2 | 97190.0 | 66776.0 | 99167.8 |
| DemonAttack | 152.1 | 1971.0 | 208.1 | 350.2 | 2034.4 | 303.0 | 164.6 | 288.1 |
| Freeway | 0.0 | 29.6 | 16.7 | 24.3 | 31.1 | 0.0 | 33.5 | 33.3 |
| Frostbite | 65.2 | 4334.7 | 236.9 | 1475.6 | 259.1 | 909.0 | 1316.0 | 274.1 |
| Gopher | 257.6 | 2412.5 | 596.8 | 1674.8 | 2236.1 | 3730.0 | 8239.6 | 5897.9 |
| Hero | 1027.0 | 30826.4 | 2656.6 | 7254.0 | 7037.4 | 11161.0 | 11044.3 | 5621.8 |
| Jamesbond | 29.0 | 302.8 | 100.5 | 362.4 | 462.7 | 445.0 | 509.0 | 427.4 |
| Kangaroo | 52.0 | 3035.0 | 51.2 | 1240.0 | 838.2 | 4098.0 | 4208.0 | 5382.2 |
| Krull | 1598.0 | 2665.5 | 2204.8 | 6349.2 | 6616.4 | 7782.0 | 8412.6 | 8610.1 |
| KungFuMaster | 258.5 | 22736.3 | 14862.5 | 24554.6 | 21759.8 | 21420.0 | 26182.0 | 18713.6 |
| MsPacman | 307.3 | 6951.6 | 1480.0 | 1588.4 | 999.1 | 1327.0 | 2673.5 | 1958.2 |
| Pong | -20.7 | 14.6 | 12.8 | 18.8 | 14.6 | 18.0 | 11.3 | 20.4 |
| PrivateEye | 24.9 | 69571.3 | 35.0 | 86.6 | 100.0 | 882.0 | 7781.0 | 114.3 |
| Qbert | 163.9 | 13455.0 | 1288.8 | 3330.8 | 745.7 | 3405.0 | 4522.5 | 4499.3 |
| RoadRunner | 11.5 | 7845.0 | 5640.6 | 9109.0 | 9614.6 | 15565.0 | 17564.0 | 20673.2 |
| Seaquest | 68.4 | 42054.7 | 683.3 | 774.4 | 661.3 | 618.0 | 525.2 | 551.2 |
| UpNDown | 533.4 | 11693.2 | 3350.3 | 15981.7 | 3546.2 | 9234.0 | 7985.0 | 3856.3 |
| #Superhuman (↑) | 0 | N/A | 1 | 8 | 10 | 9 | 10 | 11 |
| Mean (↑) | 0.000 | 1.000 | 0.332 | 0.956 | 1.046 | 1.097 | 1.266 | 1.459 |
| IQM (↑) | 0.000 | 1.000 | 0.130 | 0.459 | 0.501 | 0.497 | 0.636 | 0.641 |
结果表明,DIAMOND在这个基准上表现较强:在11款游戏中超过人类参考,并取得超人类的平均HNS 1.46,为完全在世界模型中训练的智能体创下当时最佳成绩。DIAMOND的IQM与STORM相当,高于其他基线。我们发现DIAMOND在捕捉细小信息很重要的环境中尤其出色,例如Asterix、Breakout和Road Runner。第5.3节进一步定性分析视觉质量。
5.1 扩散框架的选择
原则上任何扩散模型变体都可用于世界模型。DIAMOND采用EDM,但DDPM已广泛用于图像生成,也是自然候选。为公平比较DDPM与我们的EDM实现,我们使用相同网络架构,在专家策略采集的同一份Breakout静态数据上训练,数据共10万帧。
去噪步数直接关系到推理成本;步数更少,就能降低用想象轨迹训练智能体的成本。Ho等(2020)使用1000步去噪,Stable Diffusion使用数百步。要与IRIS等世界模型基线在计算上可比,后者每个时间步需要16次函数评估,我们至多只能用数十步,最好更少。但步数过低会损害视觉质量,并产生误差累积。
图3展示不同去噪步数n≤10时,自回归生成到t=1000的轨迹。DDPM在这一少步数区间会出现严重误差累积,模型很快偏离分布。EDM模型在长时间跨度内明显更稳定,甚至一步去噪也如此。附录K提供这一误差累积的定量分析。
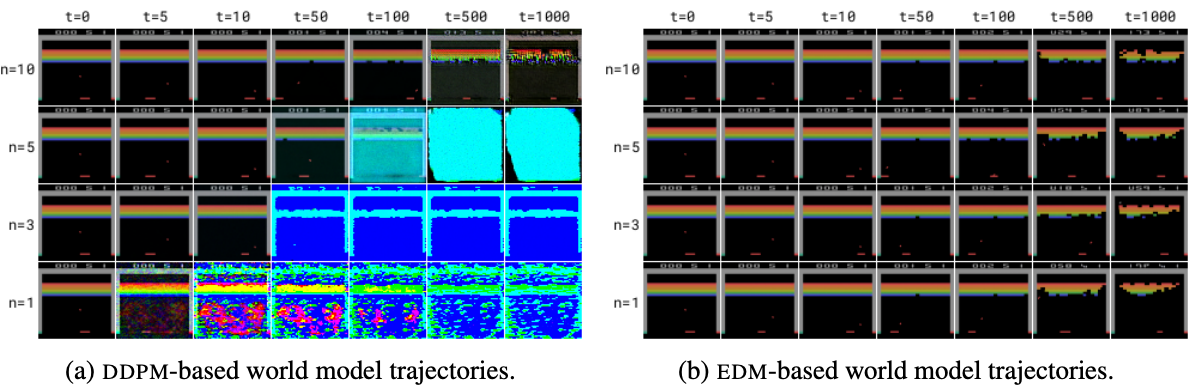
图3:DDPM(左)与EDM(右)世界模型的想象轨迹,初始观察相同,每行的去噪步数n依次减少。DDPM的误差随步数减少更快累积;EDM在所示实验中更稳定,即使n=1也是如此。原图全部时间点和面板保留。
这一结果来自式(7)的改进训练目标。相比之下,DDPM使用更简单的噪声预测目标,在中等噪声水平下效果良好,但当噪声占主导时,模型会倾向于学习恒等函数:σ_noise≫σ_data时,噪声预测网络ξθ(xₜ₊₁^τ,yₜ^τ)趋向xₜ₊₁^τ。这会使采样初期的得分估计较差,降低生成质量并造成误差累积。
EDM则自适应混合信号与噪声;当噪声占主导时,网络被训练为预测干净图像,Fθ的目标趋向xₜ₊₁⁰。这样在缺乏信号时也能更好估计得分,因此以较少去噪步数得到更高质量的生成,如图3右所示。
5.2 去噪步数的选择
虽然EDM模型在Breakout中一步去噪就很稳定,如图3右最后一行,但在一些情形下,这一选择会限制视觉质量。附录L提供进一步定量分析。得分模型等价于以L2重建损失训练的去噪自编码器。因此,对给定带噪输入,最优的单步预测是可能重建结果的期望;若后验分布多模态,这一期望可能落在分布之外。
Breakout等游戏的转移相对确定,一步便能准确建模;另一些游戏的部分可观测性会带来多模态观察分布。这时需要迭代求解,把采样推向某个具体模式,Boxing的图4说明了这一点。因此,我们在全部实验中设n=3。
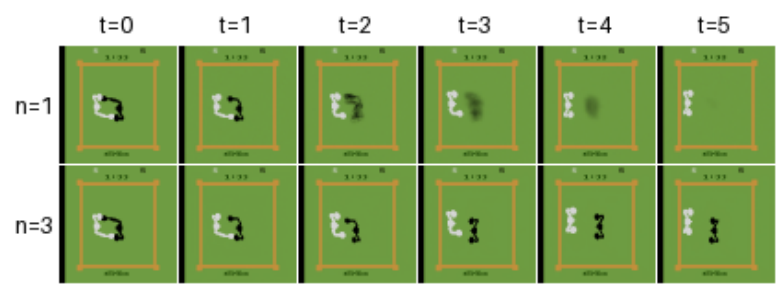
图4:Boxing中的单步(上)与多步(下)采样。黑色拳手的运动不可预测,单步去噪在可能结果间取平均,产生模糊预测;多步采样使生成落到某个具体模式,图像更清晰。策略控制白色拳手,其动作已知,因而两种方法都能正确预测白色拳手的位置。
5.3 与 IRIS 的视觉定性比较
IRIS使用离散自编码器把图像转成离散token,再用自回归Transformer在时间上组合token。为公平比较,我们以专家策略采集的同一份10万帧静态数据训练两个世界模型,结果如图5。
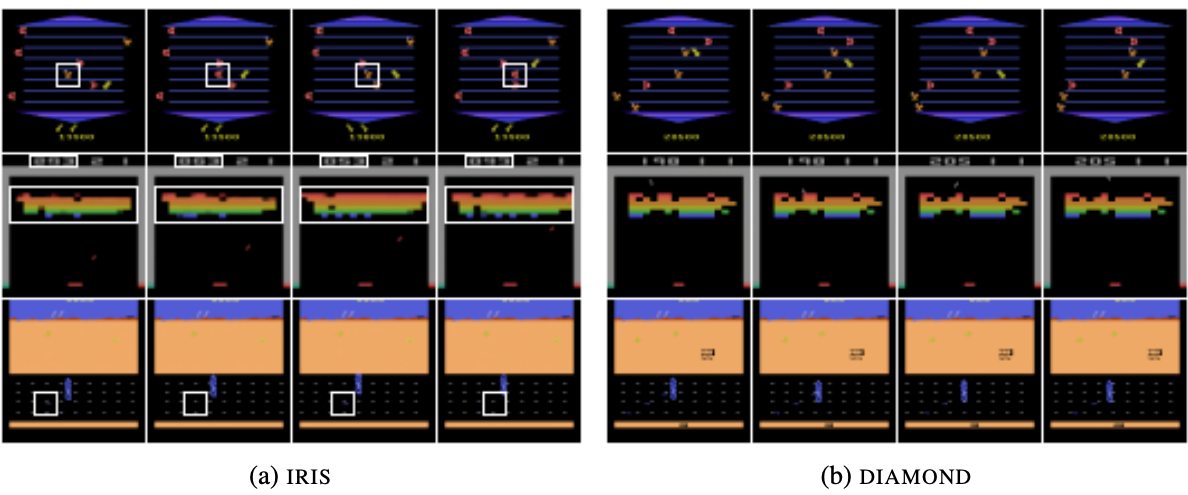
图5:IRIS(左)与DIAMOND(右)的连续预测帧。白框标出IRIS轨迹中的不一致:Asterix里橙色敌人在奖励与敌人之间切换;Breakout中的砖块及分数不一致;Road Runner路面蓝色奖励点不稳定。DIAMOND在这些展示片段中没有出现同类不一致,Breakout击破红砖时分数还正确增加7。
DIAMOND想象的轨迹通常具有更高视觉质量,对真实环境也更忠实。IRIS轨迹出现跨帧视觉不一致,例如把敌人显示为奖励,反之亦然。这些差异也许只占图像的几个像素,却可能显著影响强化学习。智能体通常应追逐奖励、避开敌人,这种小差异会使最优策略更难学到。
视觉细节一致性的改善,大体也反映在这些游戏更好的智能体表现上,见表1。因为两种方法的智能体组件相似,这一改善很可能可归因于世界模型。它也不是单纯增加计算带来的:两者都生成64×64图像,DIAMOND每帧仅需3次函数评估,IRIS则需16次;DIAMOND的参数更少、训练时间更短,详见附录H。
6 扩展到 Counter-Strike: Global Offensive
为检验模型能否建模更复杂的三维环境,我们在静态CS:GO数据上独立训练世界模型。Pearce与Zhu(2022)的Online数据集包含Dust II地图上的550万帧人类在线游戏,采样率16Hz,共95小时。随机留出50万帧,即500个回合、约8小时测试,其余500万帧、87小时训练。这部分实验没有强化学习智能体,也不涉及在线采集数据。原文脚注说明,本节在论文被NeurIPS接收后加入。
为降低成本,我们把世界建模分辨率从280×150降到56×30,再用第二个较小的扩散模型上采样回原始分辨率。扩展U-Net通道后,模型由Atari版本的400万参数增至CS:GO版本的3.81亿参数,其中上采样器5100万。组合模型在RTX 4090上训练12天。
我们为上采样器引入随机采样,并将其去噪步数增至10,改善生成视觉质量;动力学模型保持不变,仍用3步去噪。这在视觉质量和推理成本间取得合理平衡,模型在RTX 3090上以10Hz运行。典型生成见图6。
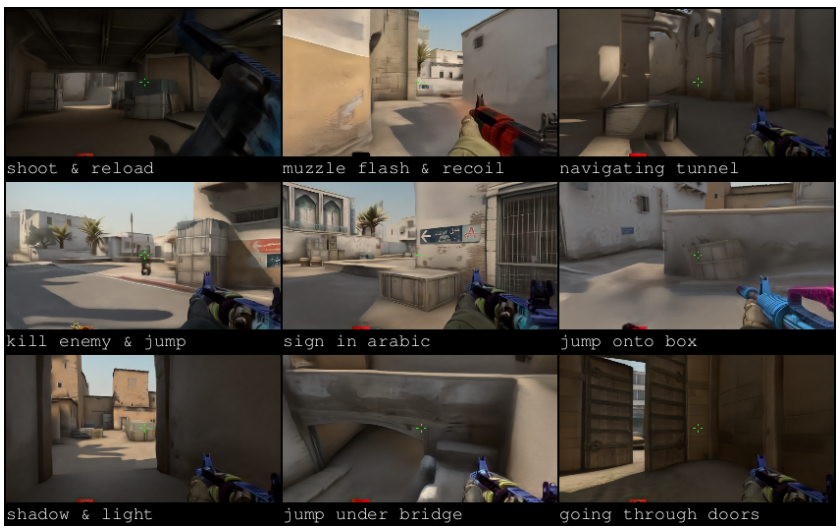
图6:人在DIAMOND扩散世界模型中使用键盘和鼠标游玩时截取的画面。模型以87小时静态CS:GO数据训练,针对Dust II地图形成交互式神经游戏引擎。动态效果请通过原项目视频查看。
模型能够生成数百时间步的稳定轨迹,但在地图中少见区域更容易偏离分布。有限记忆使它在靠近墙壁或失去视野时,可能忘掉当前状态,改生成另一种武器或另一片地图。模型还会错误允许连续跳跃:它将跳跃对场景几何的影响泛化了,而训练数据中连续跳跃不足,使它没有学到空中跳跃应被忽略。我们预计扩大模型与数据能缓解多项限制,但记忆限制除外。CS:GO世界模型能力的定量测量,以及解决这些限制的尝试,留待未来研究。
8 局限
未来研究有三项主要限制。第一,主要评估集中于离散控制环境,扩展到连续领域可能带来更多认识。第二,帧堆叠只是保存历史观察的最小记忆机制;若在环境时间维度上引入自回归Transformer,可能获得更长记忆及更好的可扩展性。附录M包含交叉注意力架构的初步尝试,但早期实验中帧堆叠更有效。第三,未来可将奖励和终止预测整合进扩散模型;结合这些目标、从扩散模型提取表征并不直接,而且会使当前世界模型产生不必要的复杂性。
9 结论与更广泛影响
我们介绍了在扩散世界模型中训练的强化学习智能体DIAMOND,解释了适应世界建模、以较少去噪步数维持长时间稳定的关键设计。DIAMOND在Atari 100k上取得平均HNS 1.46,为完全在世界模型内训练的智能体创下当时最佳结果。对若干游戏的分析表明,改进很可能来自更好地建模关键视觉细节。我们还展示了,在静态CS:GO数据上训练后,扩散世界模型能够建模三维环境,作为实时神经游戏引擎。
世界模型有望解决现实中训练智能体时的样本效率与安全问题。不过,模型不完善仍可能引发次优或意外行为。我们希望,更忠实且可交互的世界模型能为进一步降低这些风险作出贡献。
致谢与经费披露
感谢Andrew Foong、Bálint Máté、Clément Vignac、Maxim Peter、Pedro Sanchez、Rich Turner、Stéphane Nguyen、Tom Lee、Trevor McInroe、Weipu Zhang的讨论与意见。Adam和Eloi在微软剑桥研究院实习时相识,感谢Game Intelligence团队的Anssi Kanervisto、Dave Bignell、Gunshi Gupta、Katja Hofmann、Lukas Schäfer、Raluca Georgescu、Sam Devlin、Sergio Valcarcel Macua、Shanzheng Tan、Tabish Rashid、Tarun Gupta、Tim Pearce、Yuhan Cao,在项目早期提供支持,也带来了一个美好的夏天。
附录 A:在 DIAMOND 中采样观察
要从扩散世界模型采样观察xₜ⁰,先从先验采样带噪初值xₜᵀ,再利用以历史观察和动作为条件的得分模型Sθ(xₜ^τ,τ,x<ₜ⁰,a<ₜ),从τ=T到0迭代求解反向SDE,见图1。
一个训练好的得分模型可搭配多种采样方法。Song等(2020)给出相应的“概率流”常微分方程(ODE),其边缘分布与随机过程相同。此时求解是确定性的,随机性只来自初值采样。可采用一阶Euler、Euler–Maruyama,也可采用Heun等高阶方法。
无论求解器如何选择,每一步都会因局部得分近似和连续过程离散化引入截断误差。高阶方法可降低误差,却增加NFE,即生成样本所需的网络前向次数。局部误差通常相对步长超线性增长,例如Euler方法的局部误差为O(h²)。因此增加去噪步数能改善下一帧的视觉质量,但视觉质量与直接决定推理成本的NFE之间存在权衡。
附录 B:DDPM 与连续时间得分扩散的联系
DDPM可视作第2.2节扩散过程的离散版本。正向过程为马尔可夫链,以0<β₁,…,βᵢ,…,β_N<1为离散噪声调度,并采用方差保持高斯转移核:p(xⁱ|xⁱ⁻¹)=𝒩(xⁱ;√(1−βᵢ)xⁱ⁻¹,βᵢI)。(8)当N→∞时,链成为扩散过程,离散调度成为β(τ)。对应SDE的漂移系数为f(x,τ)=−β(τ)x/2,扩散系数为g(τ)=√β(τ)。
附录 C:EDM 网络预条件项与训练
Karras等(2022)使用以下预条件项实现归一化与尺度调整:c_in^τ=1/√[σ²(τ)+σ_data²](9);c_out^τ=σ(τ)σ_data/√[σ²(τ)+σ_data²](10);c_noise^τ=logσ(τ)/4(11);c_skip^τ=σ_data²/[σ_data²+σ²(τ)](12),其中σ_data=0.5。
为提高训练效果,按logσ(τ)∼𝒩(P_mean,P_std²)采样噪声(13),这里P_mean=−0.4,P_std=1.2。更深入分析见Karras等(2022)。
附录 D:模型架构
扩散模型Dθ为标准二维U-Net,条件包含最近4帧及动作,以及扩散时间τ。观察用帧堆叠输入,动作和扩散时间通过自适应组归一化输入。奖励/终止模型Rψ除最后的预测头外共享各层,将帧和动作序列通过卷积残差块,再接LSTM。在开始想象前,用条件帧与动作预热LSTM的隐状态和单元状态。
策略πϕ和价值网络Vϕ除最后一层外共享权重。下文将组合称为actor–critic,尽管严格说V是状态价值网络。网络把一帧图像通过卷积主干,再进入LSTM。主干包含4个残差块和步长2的2×2最大池化;残差块主路径包含组归一化、SiLU,以及步长1、填充1的3×3卷积。想象前同样用条件帧预热LSTM。超参数见表2,训练步骤见算法1。
| 模块 | 超参数 | 取值 |
|---|---|---|
| 扩散模型Dθ | 观察条件 | 帧堆叠 |
| 扩散模型Dθ | 动作条件 | 自适应组归一化 |
| 扩散模型Dθ | 扩散时间条件 | 自适应组归一化 |
| 扩散模型Dθ | 残差块层数 | [2, 2, 2, 2] |
| 扩散模型Dθ | 残差块通道 | [64, 64, 64, 64] |
| 扩散模型Dθ | 残差块条件维度 | 256 |
| 奖励/终止Rψ | 动作条件 | 自适应组归一化 |
| 奖励/终止Rψ | 残差块层数 | [2, 2, 2, 2] |
| 奖励/终止Rψ | 残差块通道 | [32, 32, 32, 32] |
| 奖励/终止Rψ | 残差块条件维度 | 128 |
| 奖励/终止Rψ | LSTM维度 | 512 |
| Actor–critic | 残差块层数 | [1, 1, 1, 1] |
| Actor–critic | 残差块通道 | [32, 32, 64, 64] |
| Actor–critic | LSTM维度 | 512 |
附录 E:训练超参数
| 部分 | 超参数 | 取值 |
|---|---|---|
| 训练循环 | 轮数 | 1000 |
| 训练循环 | 每轮训练步数 | 400 |
| 训练循环 | 批大小 | 32 |
| 训练循环 | 每轮环境步数 | 100 |
| 训练循环 | 采集时ε-greedy的ε | 0.01 |
| 强化学习 | 想象跨度H | 15 |
| 强化学习 | 折扣γ | 0.985 |
| 强化学习 | 熵权重η | 0.001 |
| 强化学习 | λ回报系数 | 0.95 |
| 序列 | Dθ条件观察及动作数L | 4 |
| 序列 | Rψ预热长度B_R,实际取L | 4 |
| 序列 | Rψ训练序列长度B_R+H | 19 |
| 序列 | πϕ及Vϕ预热长度B_π,V,实际取L | 4 |
| 优化 | 优化器 | AdamW |
| 优化 | 学习率 | 1e-4 |
| 优化 | ε | 1e-8 |
| 优化 | Dθ权重衰减 | 1e-2 |
| 优化 | Rψ权重衰减 | 1e-2 |
| 优化 | πϕ、Vϕ权重衰减 | 0 |
| 扩散采样 | 方法 | Euler |
| 扩散采样 | 步数 | 3 |
| 环境 | 图像观察尺寸 | 64×64×3 |
| 环境 | 动作空间 | 离散,最多18种动作 |
| 环境 | 跳帧 | 4 |
| 环境 | 最大noop | 30 |
| 环境 | 失去生命时终止 | True |
| 环境 | 奖励裁剪 | {−1, 0, 1} |
附录 F:强化学习目标
以下用xₜ、rₜ、dₜ表示世界模型预测的观察、奖励与布尔终止标记;H为想象跨度,Vϕ为价值网络,πϕ为策略,aₜ为策略在世界模型中采取的动作。我们以λ回报在偏差和方差间取舍,作为价值回归目标。对长度H的想象轨迹,递归定义:
Λₜ=rₜ+γ(1−dₜ)[(1−λ)Vϕ(xₜ₊₁)+λΛₜ₊₁],当t<H;Λ_H=Vϕ(x_H)。(14)
价值网络最小化想象轨迹中的平方误差期望:ℒ_V(ϕ)=Eπϕ[Σₜ₌₀ᴴ⁻¹(Vϕ(xₜ)−sg(Λₜ))²]。(15)sg表示停止梯度,因此目标在梯度优化中被视作常数,沿用Mnih等(2015)、Hafner等(2021)、Micheli等(2023)的做法。
因为能在想象中生成大量当前策略轨迹,我们用简单的REINFORCE目标训练策略,以Vϕ(xₜ)为基线降低梯度方差,并加入加权熵最大化维持探索。策略最小化:ℒ_π(ϕ)=−Eπϕ[Σₜ₌₀ᴴ⁻¹{logπϕ(aₜ|x≤ₜ)·sg(Λₜ−Vϕ(xₜ))+ηℋ(πϕ(aₜ|x≤ₜ))}]。(16)
附录 G:DIAMOND 算法
算法1总结整体训练流程。D为存放真实环境采集经验的回放数据集;其余记号沿用前文。以下按原算法的过程及执行顺序译写,循环与更新没有改为另一套训练方法。
训练循环 training_loop:
- 对每一轮,先调用collect_experience(steps_collect)采集经验。
- 按steps_diffusion_model重复update_diffusion_model()。
- 按steps_reward_end_model重复update_reward_end_model()。
- 按steps_actor_critic重复update_actor_critic()。
采集经验 collect_experience(n):
- 调用env.reset()获得x₀⁰。
- 对t=0,…,n−1:从πϕ(aₜ|xₜ⁰)采样aₜ,调用env.step(aₜ)得到xₜ₊₁⁰、rₜ、dₜ。
- 将{xₜ⁰,aₜ,rₜ,dₜ}加入D。若dₜ=1,则重置环境,更新xₜ₊₁⁰。
更新扩散模型 update_diffusion_model:
- 从D采样(xₜ₋L₊₁⁰,aₜ₋L₊₁,…,xₜ⁰,aₜ,xₜ₊₁⁰)序列。
- 采样logσ∼𝒩(P_mean,P_std²),取τ≔σ,沿用EDM默认恒等调度。
- 采样xₜ₊₁^τ∼𝒩(xₜ₊₁⁰,σ²I),加入独立高斯噪声。
- 计算x̂ₜ₊₁⁰=Dθ(xₜ₊₁^τ,τ,xₜ₋L₊₁⁰,aₜ₋L₊₁,…,xₜ⁰,aₜ)。
- 计算重建损失ℒ(θ)=‖x̂ₜ₊₁⁰−xₜ₊₁⁰‖²,更新Dθ。
更新奖励/终止模型 update_reward_end_model:
- 采样索引I≔{t,…,t+L+H−1},覆盖预热与想象跨度;从D采样相应(xᵢ⁰,aᵢ,rᵢ,dᵢ)。
- 将LSTM隐状态h与单元状态c初始化为0。
- 对i∈I,计算r̂ᵢ,d̂ᵢ,h,c=Rψ(xᵢ,aᵢ,h,c)。
- 计算ℒ(ψ)=Σᵢ∈I[CE(r̂ᵢ,sign(rᵢ))+CE(d̂ᵢ,dᵢ)],更新Rψ;CE为交叉熵。
更新actor–critic update_actor_critic:
- 从D采样初始缓冲(xₜ₋L₊₁⁰,aₜ₋L₊₁,…,xₜ⁰)。
- 用该缓冲预热Rψ、πϕ与Vϕ,初始化LSTM状态。
- 对i=t,…,t+H−1:从πϕ(aᵢ|xᵢ⁰)采样aᵢ,用Rψ采样奖励rᵢ与终止dᵢ,再以Dθ模拟反向扩散,采样下一帧xᵢ₊₁⁰。
- 计算i=t,…,t+H的Vϕ(xᵢ),计算ℒ_V(ϕ)及ℒ_π(ϕ)。
- 更新πϕ和Vϕ。
原文与来源
- DIAMOND:NeurIPS 2024 论文,arXiv v2(2024-10-30)全文 ↗
- arXiv 版本记录与 CC BY 4.0 许可链接 ↗
- DIAMOND:NeurIPS 2024会议官方PDF ↗
- Creative Commons:CC BY 4.0 许可条款 ↗
- DIAMOND官方项目:视频、代码与可玩模型 ↗
图片:Eloi Alonso 等 · DIAMOND(2024)· CC BY 4.0 · 原图未改动