
偏一点,下一次就从偏掉的位置开始
设想一颗球沿着弯曲轨道滚动。模型预测下一刻时,把球的位置估计得稍微靠外了一点。如果下一次预测仍然从摄像头看到的真实位置开始,这个偏差还有机会被纠正;如果接下来只能拿刚才预测的位置继续算,偏差就成了下一步的起点。
连续预测十步,并不等于把“预测一步”独立做十次。前一步的输出会影响后一步的输入,这叫自回归滚动。V-JEPA 2 的论文明确指出,自回归预测中的误差积累会限制长时规划。题目中的一秒和十秒只是直观对照,不是所有模型共同的失效阈值。
来源:原始报告 ↗
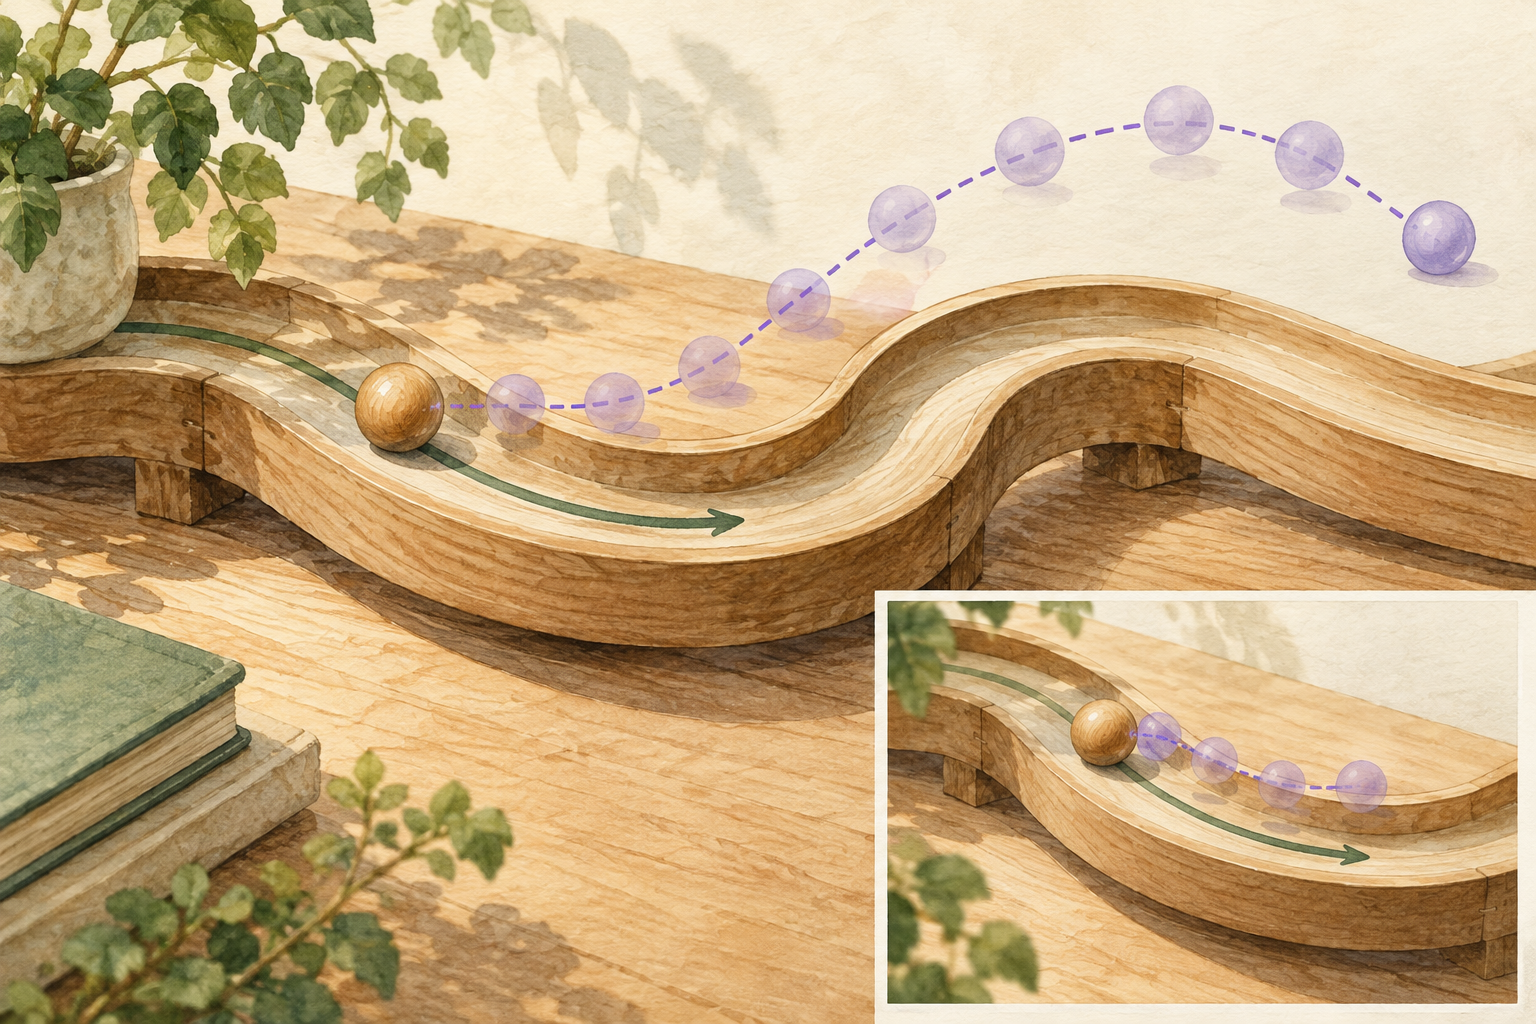
概念示意:透明球代表模型预测,实心球代表环境状态。偏差可能在连续推演中传播;新观测提供重新校正的起点。AI 生成插画,不表示实测误差曲线。
训练时的下一步,与使用时的下一步
训练数据通常提供一整段已经发生的轨迹。用真实历史状态去预测下一状态,模型每一次都能得到较可靠的起点,这类做法常称为教师强制(teacher forcing)。DINO-WM 明确用教师强制训练世界模型。
来源:原始报告 ↗
使用时却可能需要从某个起点向前推演很多步。第一步之后,程序拿到的是模型自己的预测;这些状态可能偏离训练轨迹里的状态。于是,同一个预测器面对的输入条件发生了变化。单步误差小,仍然不保证长串预测准确。
来源:原始报告 ↗
V-JEPA 2-AC 同时使用教师强制项和自回归项来训练,让模型不仅接触真实历史,也接触自己的滚动预测。论文中的多步训练项是在处理这个差别;它没有消除长时规划的全部限制。
为什么一个小误差会变成另一条未来
若误差只是沿着平稳轨迹传递,后续偏差可能变化不大;若它把状态推到了另一种情形,后果就会放大。球从轨道边缘落下、夹爪从接触变成没有接触、车辆从车道内变成压线,都是帮助理解的设想。模型随后预测的是这条错误分支上的后续。
还有一种情况:模型被规划程序带到了不熟悉的区域。离线训练轨迹覆盖了一部分状态和行动组合,优化器却可能找出数据中少见的组合,并利用预测器的缺陷得到很高的分数。《World Models》讨论的模型利用问题,说明对“高分行动”的检验不能只停在模型内部。
来源:原始报告 ↗
这里并没有“误差必然每步增加”的定律。有的系统会稳定下来,有的误差会抵消,有的预测目标根本不使用逐步滚动。要知道哪种情况发生,必须看具体模型和多个预测长度上的验证。
预测错了,和本来就有多种可能
另一颗球从遮挡后滚出来,你没有看见它之前受到的力。即使模型本身很强,仅凭当前画面也可能无法确定它下一刻的唯一位置。环境的随机性、遮挡和缺失观测,会使未来有多个合理结果;这与模型没学好动态是不同问题。
一个模型可以输出单点、分布或多条采样未来。只看其中一条与实际录像是否完全重合,有时会把合理的不确定性也算成错误;反过来,生成许多可能画面,也不能证明概率、物理约束和行动后果已经正确。
《World Models》用概率模型表达下一潜在状态,并通过采样构造虚拟环境。理解这类模型时,需要同时问预测允许多少种未来,以及不同未来怎样影响控制器。把预测分散简单理解成“模型乱了”,会丢掉这层区别。
来源:原始报告 ↗
画面连续,不一定能选出好动作
如果模型预测的是图像,最容易看到的错误是物体消失、形状变化或运动跳跃。如果模型预测的是特征,画面甚至不会被直接生成。DINO-WM 与 V-JEPA 2-AC 都利用表征预测来规划;可视化只是理解预测的一种手段,不能替代控制实验。
行动选择还有另一个检验:相同起点下,换一个候选动作,模型有没有把后果区分对?几种行动的预测画面都很漂亮,但风险排序错了,规划仍可能失败。相反,某些与任务无关的视觉细节预测得不精确,也未必妨碍短程控制。
因此,比较长预测时要注明测的是什么:像素、潜在特征、物体位置,还是实际任务完成率。它们分别回答不同问题。不能用一个视觉分数替所有行动任务给出结论。
闭环纠偏,把很长的任务拆成较短的决定
一种实用办法是减少一次计划被盲目执行的长度:先规划一段,执行其中的一部分,再观察并重新规划。这是模型预测控制的核心做法之一。它把每次决策的起点拉回新观测,而不是要求一条预测从头准确延伸到终点。
来源:原始报告 ↗
纠偏也有条件。摄像头可能被遮挡,观测延迟可能很大,刚执行的动作也可能无法撤回。V-JEPA 2-AC 对相机位置敏感,原作者在实验前手动尝试不同机位;重新观察并不会自动补上相机坐标与行动坐标之间的歧义。
另一条思路是用子目标或不同时间尺度组织任务。V-JEPA 2-AC 的拾取放置演示使用连续的图像子目标,原论文把更长时程、无需人工给定子目标的规划列为未来工作。完成长任务的系统,可以依靠很多次短程修正;这与一次预测很长未来,需要分别评价。
读长时预测实验时,追踪这几个条件
- 起点和后续输入:给了多少真实历史帧?中途有没有再喂入真实观测?
- 行动条件:未来行动已知,还是也需要模型或策略决定?有没有比较不同动作的后果?
- 预测长度:预测了多少步、采样频率是多少、实际覆盖多久?“64 步”本身不等于“64 秒”。
- 评测目标:比较画面、特征、状态还是任务结果?是否同时报告短程与长程情况?
- 任务组织:是否给了中间子目标、人工机位调整或失败后的重新开始?这些条件应与结果一起读。
DreamerV3 的视频预测展示会明确说明上下文帧、后续行动和不再接收中间画面的长度;V-JEPA 2 则分别介绍预测时程、闭环控制和子目标。这样的实验条件比单看一段“像真的”视频更能说明模型用了哪些信息。
需要预测多远,由行动决定
能预测更长的未来当然有价值,但“越长越好”还不够具体。眼前需要避免碰撞的行动,可能主要依赖近处结果;需要把物体搬到另一个房间的任务,则还需要路径、阶段和较长时间尺度上的判断。合适的预测长度要与任务、重新观测的机会和误差容忍度一起看。
下一次看到长时预测演示,可以把问题改成:它从哪里开始推演,多久能得到新的观测,哪些误差会改变动作选择,最终有没有在模型之外验证。这些条件能帮助区分可用的预见能力与一段暂时连贯的未来画面。