
版本与译文说明
原题:Mastering diverse control tasks through world models(通过世界模型掌握多样的控制任务)。作者:Danijar Hafner、Jurgis Pasukonis、Jimmy Ba、Timothy Lillicrap。本文依据 Nature 2025 年 4 月 2 日发表的正式版本,Nature 640,647–653,DOI:10.1038/s41586-025-08744-2。它介绍第三代 Dreamer,即 DreamerV3;本译稿不将 2023 年预印本与 2025 年正式版混用。译者:世界模型图谱。
翻译范围为摘要、正文、Methods(方法)、数据与代码可用性、致谢和作者声明,以及正式 PDF 中的全部 Extended Data:2 幅扩展图、7 张扩展表。保留正文 6 幅原图和全部数学定义。独立的 Supplementary Information 文件、完整参考书目及逐任务附加学习曲线不在本译稿范围,仍可从文末 Nature 原文入口阅读。文中的“我们”指原作者;“首个”“最佳”等结论保留为作者发表时的判断,本站没有独立复现实验。
Nature 正式版采用 CC BY 4.0;许可说明将图片及第三方材料纳入同一许可,除非材料署名行另有说明。本稿使用的图版未见独立排除声明,图像使用出版社完整原文件,只转换为无损 WebP,图内英文不改。中文译文为翻译及排版改编,亦采用 CC BY 4.0;作者、来源、许可和改编说明集中在文末。
译注:本文所说“同一配置”指跨任务使用相同算法超参数,并不表示一个训练后的智能体同时掌握全部任务。环境预算、回放比、并行环境数量及模型尺寸的实验设置详见方法和扩展表;Minecraft 实验还采用抽象合成动作和加快破坏方块等环境设定。
摘要
开发一种通用算法,能够学习解决广泛应用中的任务,一直是人工智能的基本挑战。现有强化学习算法容易用于与其设计目标相近的任务,但将它们配置到新的应用领域,需要大量人工专业知识和试验[1,2]。我们提出第三代 Dreamer:一种采用单一配置、在超过 150 项多样任务上优于专门方法的通用算法。
Dreamer 学习环境模型,通过想象未来情景改善行为。基于归一化、平衡和变换的稳健性技术,使跨领域学习保持稳定。据我们所知,直接采用默认配置的 Dreamer,是首个无需人类数据或课程安排、从零学会在 Minecraft 收集钻石的算法。这被视为人工智能的重要挑战,需要从像素和稀疏奖励出发,在开放世界探索长远策略[3]。我们的工作使解决困难控制问题不再依赖大量试验,从而拓宽强化学习的适用范围。
正文
强化学习使计算机能通过交互完成任务,例如在围棋和 Dota 中超越人类[4,5];它也是让大语言模型超越预训练数据所示行为的重要组件[6]。近端策略优化(PPO)[7]已成为标准算法,但更高表现往往依赖专门方法,针对连续控制[8]、离散动作[9,10]、稀疏奖励[11]、图像输入[12]、空间环境[13]、棋盘游戏[14]等领域的独特困难。
然而,把强化学习用于足够不同的新任务,例如从电子游戏转到机器人,需要投入大量精力、专业知识与计算资源调整超参数[1]。这种脆弱性阻碍它解决新问题,也限制了计算昂贵或无法承担调参成本的模型与任务。无需重新配置就能学会新领域的通用算法,一直是人工智能的核心挑战,将使强化学习走向广泛实际应用。
我们提出 Dreamer,在广泛领域以固定超参数超过专门专家算法,使强化学习容易用于新问题。其基础是学习世界模型,给予智能体丰富感知与想象未来的能力[15–17]。图 1 中,世界模型预测候选动作的结果,critic 神经网络判断结果价值,actor 神经网络选择通向最佳结果的动作。这个思想直观,但如何稳健地学习和利用世界模型以取得高性能,长期尚未解决[18]。Dreamer 以归一化、平衡和变换应对这些困难;在图 2 所概括领域的 150 多项任务,以及不同模型尺寸和训练预算下,我们都观察到稳健学习。更大模型不仅得分更高,也需要更少交互,为实践者提高表现和数据效率提供了可预期的方法。
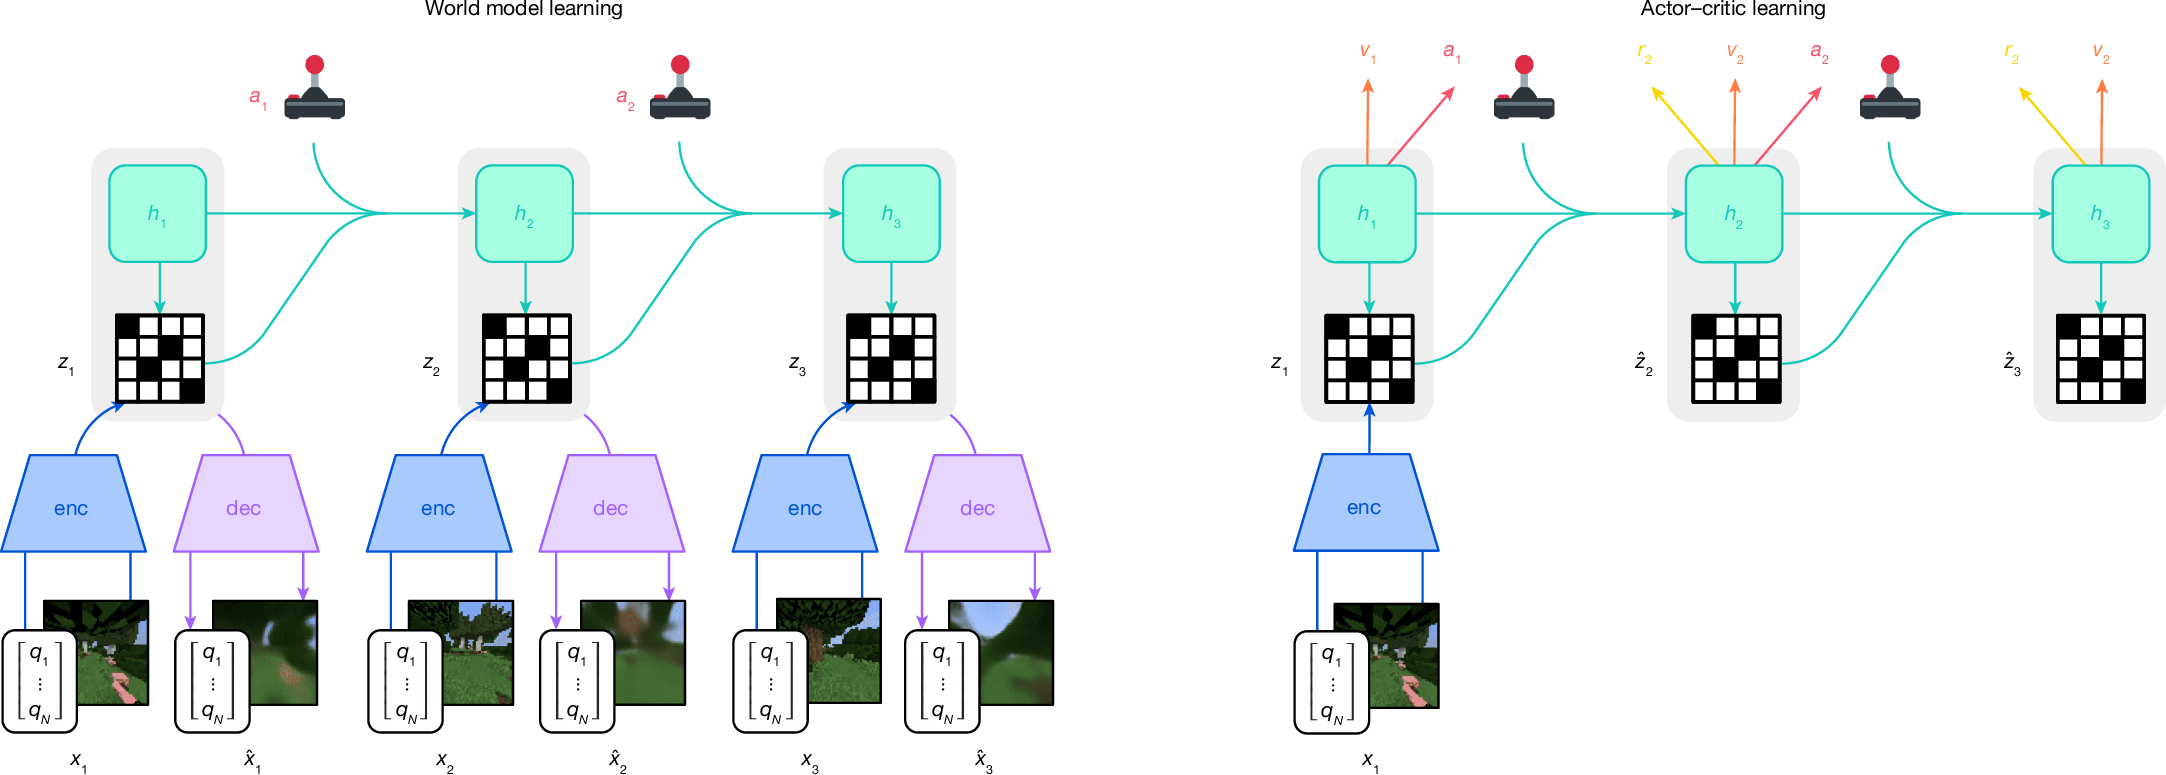
图 1:Dreamer 的训练流程。编码器 enc 将感官输入 xₜ 转为离散表征 zₜ;带循环状态 hₜ 的序列模型在动作 aₜ 条件下预测表征。解码器 dec 重建输入 x̂ₜ,以塑造表征。Actor 与 critic 预测动作及价值,并从世界模型预测的抽象表征 ẑₜ 和奖励 rₜ 轨迹学习。
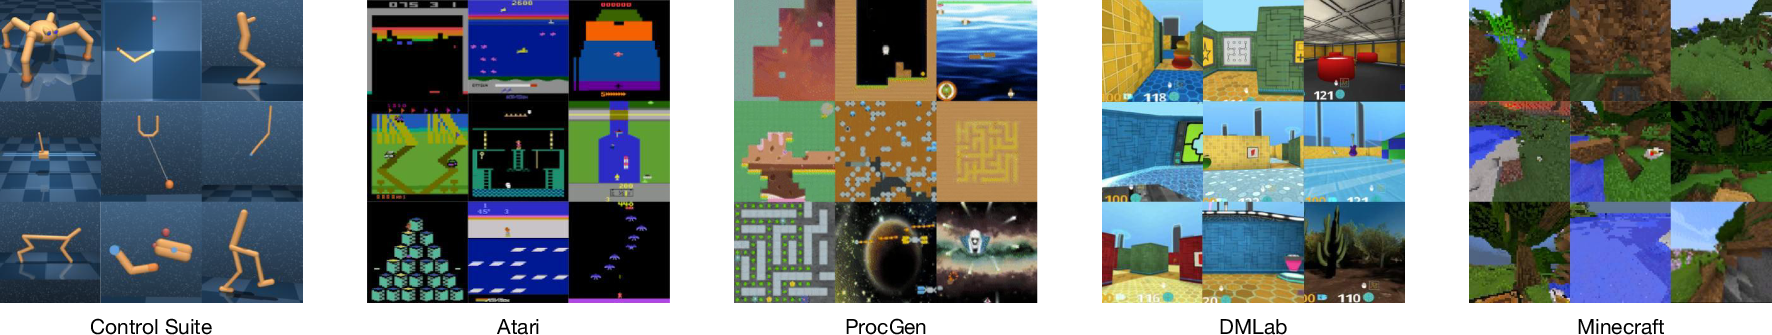
图 2:实验中的多样视觉领域。从机器人运动与操作、Atari 游戏、程序生成的 ProcGen 关卡,到需要时空推理的 DMLab,以及复杂、无限的 Minecraft 世界,Dreamer 均取得成功。我们也在非视觉领域评估。
为推进强化学习边界,我们考察近年成为研究焦点的 Minecraft[19–21]。国际竞赛鼓励开发能自主学习收集钻石的算法[3]。在没有人类数据的情况下解决此问题,被广泛认为很困难:奖励稀疏、探索困难、时间跨度长,开放世界又存在程序生成的多样性[19]。此前方法因而使用专家数据和领域专用课程[20,21]。据我们所知,直接使用默认配置的 Dreamer 首次实现了从零收集钻石。
学习算法
我们介绍 Dreamer 的第三代算法[22,23]。它有三个神经网络:世界模型预测潜在动作的结果,critic 评估价值,actor 选择通往最有价值结果的动作。智能体与环境交互的同时,各组件从回放经验并行训练。要跨领域成功,三者都需要适应不同信号尺度,并稳健平衡各自目标中的项。困难在于,我们追求的并非同领域相似任务,而是固定超参数下的多样领域。以下介绍各组件及稳健损失。
世界模型学习
世界模型通过自编码[24]学习感官输入的紧凑表征,并根据候选动作预测未来表征和奖励,以支持规划。我们采用图 1 的 RSSM[25]:编码器先把每个时间步的 xₜ 映射到随机表征 zₜ;带循环状态 hₜ 的序列模型在过去动作 aₜ₋₁ 条件下预测表征序列。拼接 hₜ 与 zₜ 得到模型状态,用它预测奖励 rₜ、回合继续标志 cₜ ∈ {0, 1},并重建输入以保证表征包含信息:
序列模型:hₜ = fϕ(hₜ₋₁, zₜ₋₁, aₜ₋₁);编码器:zₜ ∼ qϕ(zₜ | hₜ, xₜ);动力学预测器:ẑₜ ∼ pϕ(ẑₜ | hₜ);奖励预测器:r̂ₜ ∼ pϕ(r̂ₜ | hₜ, zₜ);继续预测器:ĉₜ ∼ pϕ(ĉₜ | hₜ, zₜ);解码器:x̂ₜ ∼ pϕ(x̂ₜ | hₜ, zₜ)。
符号 ∼ 表示从对应分布采样随机变量。图 3 展示长期视频预测,扩展图 1 提供更多示例。图像编码与解码使用卷积网络,向量输入使用多层感知机(MLP);动力学、奖励和继续预测器也是 MLP。表征从一组 softmax 分布采样,并在采样步骤使用直通梯度[23]。给定长度为 T、包含输入、动作、奖励及继续标志的序列批,端到端优化参数 ϕ,以最小化预测、动力学和表征损失,权重分别为 β_pred = 1、β_dyn = 1、β_rep = 0.1:
ℒ(ϕ) ≔ E_qϕ[Σₜ₌₁ᵀ (β_pred ℒ_pred(ϕ) + β_dyn ℒ_dyn(ϕ) + β_rep ℒ_rep(ϕ))],其中 E_qϕ 表示期望。
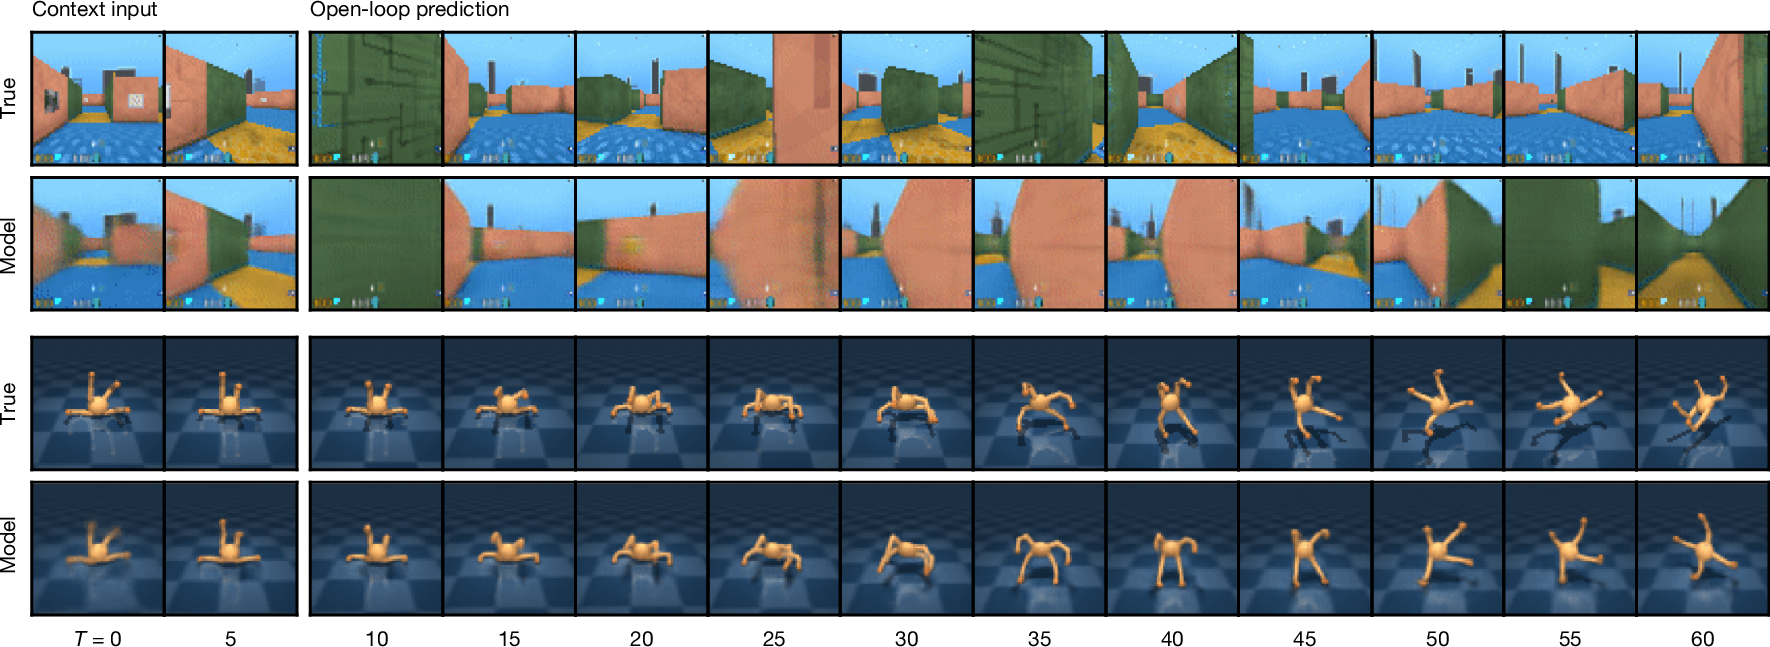
图 3:世界模型的视频预测。展示程序生成的迷宫和四足机器人。给定未见视频的 5 张上下文图像及完整动作序列,Dreamer 在无法访问中间图像的情况下预测未来 45 帧;从像素观察学习各环境的底层结构。
预测损失用后文的 symlog 平方损失训练解码器和奖励预测器,用逻辑回归训练继续预测器。动力学损失最小化预测器 pϕ(zₜ | hₜ) 与下一随机表征 qϕ(zₜ | hₜ, xₜ) 之间的 KL 散度,使序列模型学会预测。表征损失则让表征更容易预测,以便想象训练时通过因子化动力学预测器快速采样。两者区别在停止梯度算子 sg(·) 和损失尺度。为避免“容易预测却不含输入信息”的退化解,我们采用 free bits[26],把动力学与表征损失的下限截为 1 nat ≈ 1.44 bits;当它们已足够小时便停止进一步降低,让学习集中于预测损失:
ℒ_pred(ϕ) ≔ −log pϕ(xₜ | zₜ, hₜ) − log pϕ(rₜ | zₜ, hₜ) − log pϕ(cₜ | zₜ, hₜ)。
ℒ_dyn(ϕ) ≔ max(1, KL[sg(qϕ(zₜ | hₜ, xₜ)) ∥ pϕ(zₜ | hₜ)]);ℒ_rep(ϕ) ≔ max(1, KL[qϕ(zₜ | hₜ, xₜ) ∥ sg(pϕ(zₜ | hₜ))])。
先前世界模型需依环境视觉复杂度调整表征损失[22]。复杂场景有大量控制无关细节,需要更强正则来简化;简单图像中的单个像素可能影响任务,需要更弱正则以提取细节。我们发现,将 free bits 与较小表征损失权重结合能解决这一矛盾,使跨领域固定超参数成为可能。把向量观察通过后文的 symlog 变换,可避免巨大输入和重建梯度,进一步稳定与表征损失的权衡。
早期实验偶尔出现 KL 损失尖峰,与深层 VAE 的报告相符[27]。为避免它,我们把编码器及动力学预测器的类别分布参数化为 1% 均匀分布与 99% 神经网络输出的混合,避免分布变成确定性的,从而保持良好 KL 损失。更多细节和超参数见 Supplementary Information。
Critic 学习
Actor 与 critic 完全从世界模型预测的抽象表征轨迹学习行为[15]。与环境实际交互时,我们直接从 actor 网络采样动作,不做向前搜索。它们作用于模型状态 sₜ ≔ {hₜ, zₜ},利用循环世界模型学到的马尔可夫表征 hₜ。Actor 希望最大化回报 Rₜ ≔ Σ_τ₌₀∞ γ^τ rₜ₊τ,γ = 0.997,τ 表示想象中的未来时间步。为考虑预测跨度 T = 16 之外的奖励,critic 近似当前 actor 行为下各状态的回报分布[28]:
Actor:aₜ ∼ πθ(aₜ | sₜ);critic:vψ(Rₜ | sₜ)。θ、ψ 分别是两网络参数。
从回放输入的表征出发,世界模型与 actor 生成想象状态、动作、奖励和继续标志的轨迹。Critic 输出分布,我们取其期望 vₜ ≔ E[vψ(· | sₜ)] 作为价值。为估计预测跨度以外的奖励,计算结合预测奖励和价值的自举 λ 回报,再用最大似然训练 critic 预测其分布:
ℒ(ψ) ≔ −Σₜ₌₁ᵀ ln pψ(Rₜ^λ | sₜ);Rₜ^λ ≔ rₜ + γcₜ[(1−λ)vₜ + λRₜ₊₁^λ];R_T^λ ≔ v_T。
虽然可把输出参数化为正态分布,但回报可能多峰,各环境尺度也相差多个数量级。我们用指数间隔分箱的类别分布,解耦梯度尺度与目标尺度,以稳定并加速学习。对奖励难预测的环境,critic 损失既用于想象轨迹(β_val = 1),也用于回放轨迹(β_repval = 0.3)。回放损失把想象展开起始状态的 Rₜ^λ 作为当前策略价值标注,再沿回放奖励计算 λ 回报。
回归目标依赖 critic 自身预测,因此我们正则化 critic,使其接近自身参数指数移动平均模型的输出。这与强化学习中的目标网络相似[9],但允许使用当前 critic 计算回报。训练开始时,随机初始化的奖励及 critic 网络可能给出很大奖励,延迟学习;因此把两者输出权重矩阵初始化为零,缓解问题并加快早期学习。
Actor 学习
Actor 选择最大化回报的动作,并通过熵正则探索。正则的合适尺度同时依赖奖励大小和频率。理想情况是奖励稀疏时多探索,奖励密集或近在眼前时多利用已有知识,而探索程度不受任意奖励缩放影响。这需要归一化回报尺度,同时保留奖励频率的信息。
为跨领域使用固定熵尺度 η = 3 × 10⁻⁴,我们将回报近似归一到 [0, 1]。减去偏移不改变 actor 梯度,因此除以范围 S 即可。为避免稀疏奖励下放大函数逼近噪声,我们只缩小较大回报,低于阈值 L = 1 的小回报保持原样。离散及连续动作均用 REINFORCE 估计器[29],得到替代损失,H 表示策略熵:
ℒ(θ) ≔ −Σₜ₌₁ᵀ sg[(Rₜ^λ − vₜ)/max(1, S)] log πθ(aₜ | sₜ) + ηH[πθ(aₜ | sₜ)]。
译注:熵项前的正号按 Nature 正式版显示公式保留,原文有关熵正则促进探索的描述也原样翻译;本文不自行改变符号或推定代码实现。
回报分布可能多峰并有离群值,尤其随机环境中某些回合的可达回报更高。用最小值和最大值归一化会过度缩小回报,导致次优收敛。我们使用批次维度上第 5–95 百分位的范围,并用指数移动平均平滑:S ≔ EMA(Per(Rₜ^λ, 95) − Per(Rₜ^λ, 5), 0.99)。
此前工作通常归一化优势而非回报[7],不论显著回报是否可达,都同等强调回报和熵。稀疏奖励时放大优势,会让噪声压过熵正则、阻碍探索。用标准差归一化奖励或回报,也会在标准差近零时过度放大、造成不稳定。约束优化使跨状态平均熵固定[30,31],虽稳健,却在稀疏奖励下探索慢、密集奖励下收敛较低。我们未找到这些方法跨领域稳定的超参数。带分母下限的回报归一化克服上述困难,在稀疏奖励下迅速探索,在多样领域达到高表现。
稳健预测
输入重建、奖励和回报预测都面临跨领域尺度变化。对巨大目标用平方损失可能发散;L1 和 Huber 损失[9]会让学习停滞;基于滚动统计的归一化[7]引入非平稳性。我们提出 symlog 平方误差:网络 f(x, θ) 学习变换后的目标 y,读取预测时再作逆变换:
ℒ(θ) ≔ ½[f(x, θ) − symlog(y)]²;ŷ ≔ symexp(f(x, θ))。
普通对数不能处理负目标,所以采用双对称对数函数族[32]的一种变换,称为 symlog,逆函数为 symexp:symlog(x) ≔ sign(x)log(|x|+1);symexp(x) ≔ sign(x)[exp(|x|)−1]。
Symlog 压缩正负大值,让优化过程在必要时迅速把预测移向大值;在原点附近近似恒等,不影响足够小目标的学习。此前用于 critic 的一种非对称变换[33],我们发现跨领域平均效果较差。
对于奖励、回报等可能有噪声的目标,我们再引入 symexp two-hot 损失。网络输出指数间隔分箱 bᵢ ∈ B 的 softmax logits,读取时取位置按预测概率的加权平均:ŷ ≔ softmax(f(x))ᵀB;B ≔ symexp([−20, …, +20])。加权平均可以落在分箱之间,因此网络能输出支持区间内任意连续值。
训练采用 two-hot 目标[10,28],即 one-hot 对连续值的推广。向量共有 |B| 项,仅最接近标量目标的 k 和 k+1 两个分箱非零,权重和为 1,越接近目标权重越大,且线性变化。网络最小化软目标分类交叉熵:ℒ(θ) ≔ −twohot(y)ᵀ log softmax(f(x, θ))。损失仅依赖分箱概率,不依赖分箱对应的连续值,从而完全解耦梯度大小与信号尺度。
Dreamer 因而对编码器输入和解码器目标中的向量观察使用 symlog,对奖励预测器及 critic 使用 symexp two-hot 损失。我们发现这些技术使许多不同领域的学习稳健而迅速。
译注:原文在这一总结句将 symexp 拼为 synexp;其前后定义、公式及方法部分均为 symexp,本译稿据上下文统一为 symexp。世界模型小节先以 symlog 平方损失说明预测项,后文和实现部分再明确奖励头使用 two-hot;以上保留原文两处描述。
评估与基准
我们以固定超参数,在 8 个领域、150 多项任务上评估 Dreamer 的通用性,与文献中针对各基准专门设计、调优的最佳方法比较,也与高质量 PPO 实现[7]比较。PPO 使用为跨领域表现选出的固定超参数,能复现其在 ProcGen 上已发表的强结果[34]。此外,将 Dreamer 用于困难的 Minecraft,并与强基线比较。每个 Dreamer 智能体在单张 Nvidia A100 GPU 上训练,许多实验室可以复现;公开实现能复现全部结果。
八个领域涵盖连续和离散动作、视觉和低维输入、密集和稀疏奖励、不同奖励尺度、二维和三维世界及程序生成。图 4 汇总比较:Dreamer 在专家算法各自适用的领域达到或超过最佳方法,无论基于模型还是无模型,并在全部领域超过 PPO。
Atari:57 个 Atari 2600 游戏,预算 2 亿帧,挑战多样[35]。使用 sticky actions 模拟器设定。Dreamer 仅用 MuZero[10]一部分计算资源便超过它,也超过 Rainbow[36]和 IQN[37]。
ProcGen:16 个游戏,通过随机关卡及视觉干扰测试稳健性和泛化[38]。在 5,000 万帧预算内,Dreamer 超过调优的 PPG[34]和 Rainbow[38];固定超参数的 PPO 与高度调优官方实现的已发表分数相当。
DMLab:30 个三维任务测试时空推理[39]。Dreamer 在 1 亿帧时超过 IMPALA、R2D2+[33]在 10 亿环境步时的表现,数据效率提升超过 1,000%。这些基线不是为数据效率设计的,但为此前大规模可达表现提供比较点。
Atari100k:26 个游戏,预算仅 40 万帧,即约 2 小时游戏时间[18]。EfficientZero[40]结合在线树搜索、优先回放及超参数调度达到最佳,但还通过提前重置关卡增加数据多样性,使比较困难。无需这种复杂性,Dreamer 超过其余最佳方法,包括基于模型的 IRIS、TWM、SimPLe,以及无模型 SPR[41]。
本体感觉 Control Suite:20 个模拟机器人连续动作任务,本体感觉向量输入,预算 100 万环境步[42]。涵盖经典控制、运动和操作,奖励有密集也有稀疏。Dreamer 与 DMPO[31]、TD-MPC2[43]等最佳方法相当。
视觉 Control Suite:同样 20 个连续控制任务,但仅接收高维图像[42]。Dreamer 创下这一基准的最佳表现,超过利用数据增强、专为视觉环境设计的 DrQ-v2[44]和 TD-MPC2[43]。
BSuite:23 个环境、共 468 种配置,专门测试信用分配、奖励尺度及随机性稳健性、记忆、泛化与探索[45]。Dreamer 超过 Boot DQN 等方法[46],达到最佳表现;对尺度稳健性的改善尤为明显。
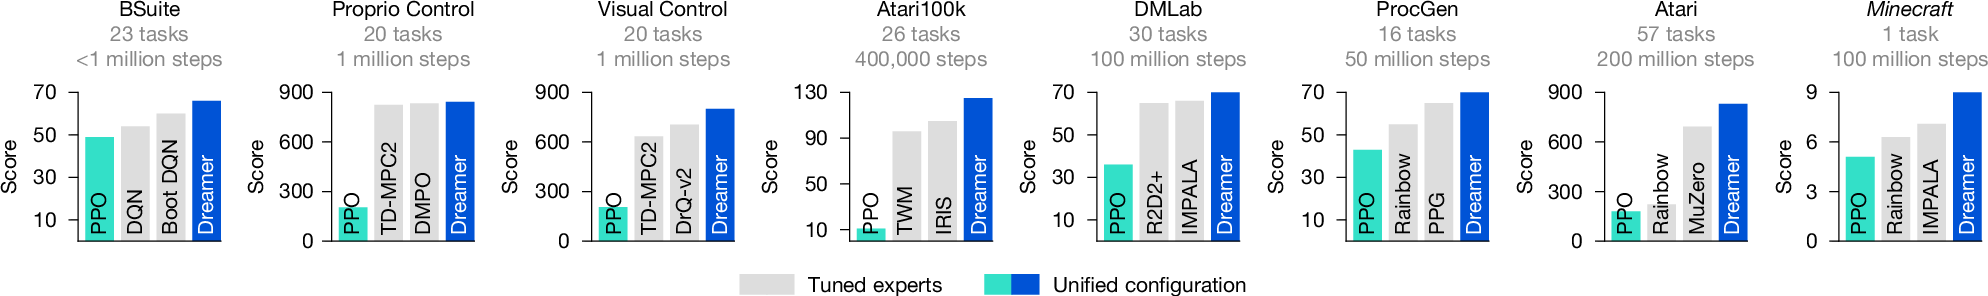
图 4:基准分数。跨领域固定超参数的 Dreamer,在广泛基准及数据预算下超过调优专家算法,也显著超过高质量 PPO。DMLab 中,IMPALA 与 R2D2+ 使用的数据量为 Dreamer 的 10 倍。
Minecraft 实验
在 Minecraft 收集钻石长期是人工智能挑战[19–21]。每回合位于独特、随机生成、无限的三维世界,到死亡或 36,000 步结束,相当于 30 分钟。玩家要寻找资源、制作工具,从稀疏奖励发现 12 种物品的序列;熟练玩家约需 20 分钟取得钻石[21]。我们将 MineRL 竞赛提供的动作转成类别动作空间,其中包含抽象合成动作。遵循此前工作,加快破坏方块,因为随机策略难以学会连续数百步按住按钮[20],使研究聚焦 Minecraft 的核心困难。更多细节及与 VPT、Voyager 的比较见 Supplementary Information[21,47]。
复杂环境训练昂贵,广泛调参困难,因此我们直接使用 Dreamer 默认超参数。据我们所知,它首次无需 VPT 所用人类数据[21]或自适应课程[20],从零收集钻石。全部 Dreamer 智能体都在 1 亿环境步内发现钻石,各物品成功率见扩展图 2。若干强基线能获得铁镐等高级物品,却都未发现钻石。
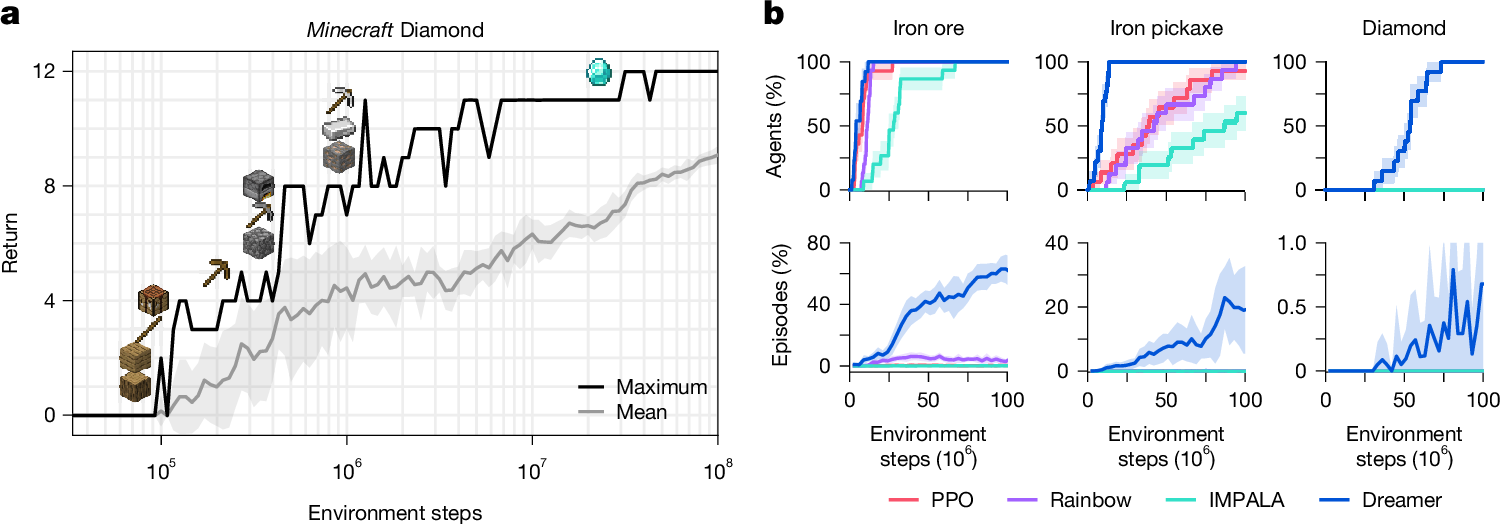
图 5:Minecraft Diamond 挑战表现。(a)直接使用默认配置的 Dreamer,据作者所知首次从稀疏奖励完成通往钻石的全部 12 个里程碑,无需人类数据或课程。(b)训练出的智能体中发现最后三种物品的比例,以及获得各物品的回合比例。此前算法可到铁镐,比较中只有 Dreamer 发现钻石,且每次训练均成功。阴影为一个标准差。
消融与扩展规律
图 6 在多样的 14 个任务上消融稳健性技术和学习信号;逐任务曲线见 Supplementary Information。所有稳健性技术平均都有贡献,最显著的是世界模型目标中的 KL 平衡与 free bits,其次是回报归一化,以及奖励和价值的 symexp two-hot 回归。单项技术可能仅对部分任务关键,对其他任务无明显影响。
为考察世界模型,我们分别停止任务相关的奖励及价值梯度、或任务无关的重建梯度对表征的影响。此前强化学习通常只依赖任务相关信号[9,10],Dreamer 却主要依赖世界模型的无监督目标。这可能支持未来借助无监督数据预训练的算法变体。
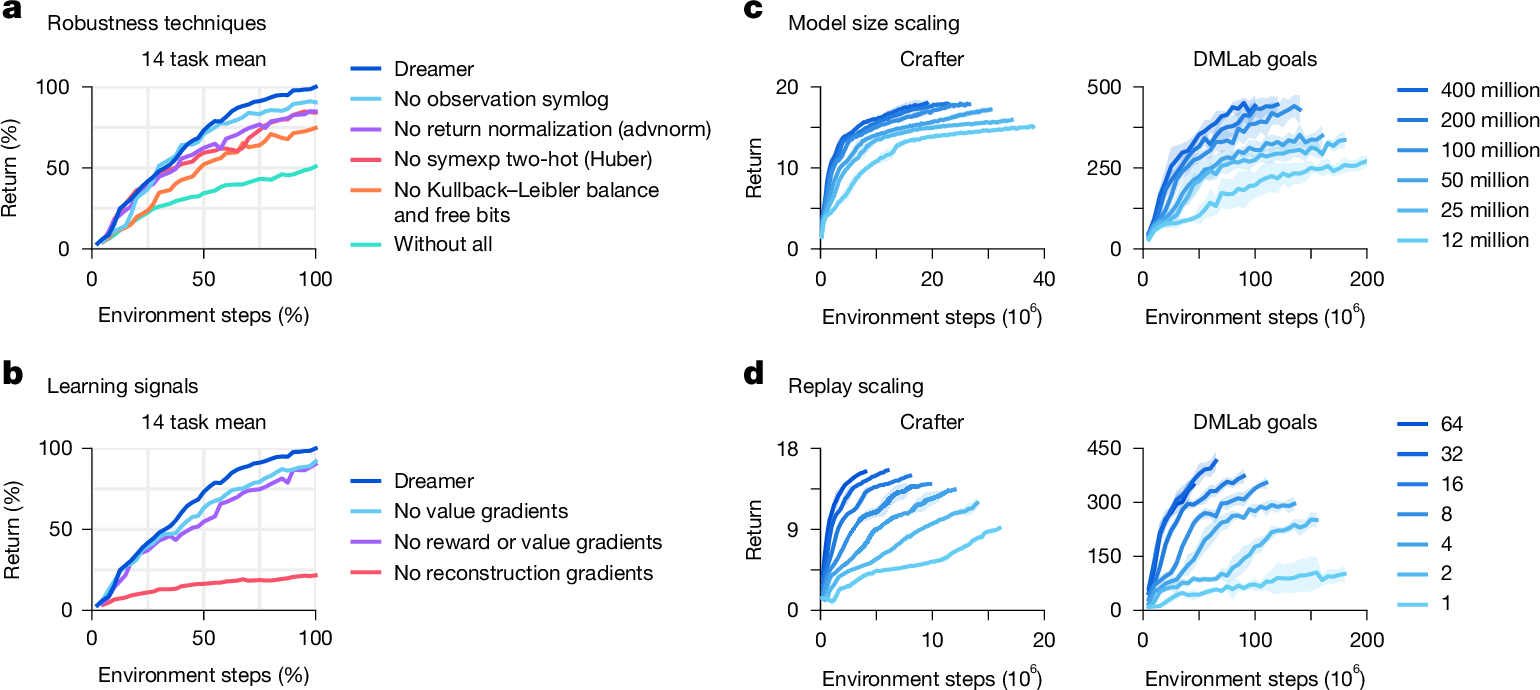
图 6:消融和稳健扩展。(a)全部稳健性技术平均有贡献,单项可能只影响部分任务;advnorm 为优势归一化。(b)表现主要依赖世界模型无监督重建损失,与主要依赖奖励及价值梯度的既有方法不同[7,9,10]。(c)从 1,200 万到 4 亿参数,表现随模型增大单调提高,而且所需交互减少。(d)更高回放比可预期地提高表现,连同模型尺寸,使更多计算资源能改善表现及数据效率。
我们在 Crafter[48]和一个 DMLab 任务[39]上训练 6 种 1,200 万至 4 亿参数的模型,以及不同回放比。回放比影响梯度更新次数。固定超参数下,所有尺寸和回放比均稳健学习;更大模型直接带来更高表现和更低数据需求,更多梯度步也减少学会行为所需交互。结果提供了通过计算扩展提高表现的可预期途径。
既有研究与结论
通用算法一直是强化学习目标。PPO[7]广泛使用且稳健,但需要大量经验,往往不如专门方法。MuZero[10]用价值预测模型对离散动作规划,但作者未发布实现,多个复杂组件使复现困难。Gato[49]从多个任务的专家示范拟合一个模型,却不能自主改进。Dreamer 则以固定超参数掌握多样环境,不需要专家数据,且实现开源。
Minecraft 是近期研究重点。MineRL 提供竞赛环境与多样人类数据,支持技能探索和学习[19]。VPT[21]记录承包人员游戏及键鼠动作,先行为克隆再强化学习,用 720 张 GPU 训练 9 天取得钻石。Voyager 让语言模型调用游戏专门设计的 MineFlayer 脚本层,使用高层动作[47]。Dreamer 使用包含抽象合成动作的 MineRL 竞赛动作空间,单张 GPU 训练 9 天,纯从稀疏奖励自主收集钻石,无需人类数据。
译注:上述 GPU 数量是作者对不同研究的比较;动作空间、环境处理和训练资料均不同,不是相同设置下的算力效率对照实验。关于 MuZero 作者未公开实现的陈述,也保留为论文历史语境。
从未知环境学习动力学并用于强化学习[15],早期已有 PILCO、E2C、Visual Foresight[16]。PlaNet 引入准确到足以从像素规划的潜在动力学[25];IRIS、TWM[41]使用 Transformer,R2I 用结构化状态空间模型处理长期记忆[50]。TD-MPC2[43]学习确定性动力学,将策略网络与经典连续动作规划结合,并采用 Dreamer 的百分位回报归一化等稳健技术。
结论。第三代 Dreamer 以固定超参数掌握广泛领域,不仅在 150 多项任务表现出色,也在不同数据及计算预算下稳健学习,推动强化学习走向实际应用。据我们所知,它直接采用默认配置、首次从零在 Minecraft 收集钻石,是人工智能的重要里程碑。作为高性能的世界模型算法,它为未来研究铺路,包括从互联网视频教授世界知识,以及学习跨领域的单一世界模型,让人工智能体积累更通用的知识和能力。
方法:基线
PPO。我们用标准 PPO[7]比较所有基准上的固定超参数 Dreamer。公开 PPO 实现很多,任务性能差异显著[2]。为代表固定超参数跨领域的高性能,我们选择 Acme[51]的高质量实现,依建议[1,2]选择扩展表 6 的超参数,并调节 epoch 批大小以满足复杂环境[38],以及学习率与熵权重。折扣因子与 Dreamer 相同,因为跨领域有效且文献常用[10,33]。采用表现优于替代方案的 IMPALA 架构[38],小批大小取单张 A100 能容纳的最大值。
我们在 ProcGen 上验证该实现和配置,PPO 作者此前报告过高度调优的实现[34];结果与参考相当或略高。同等回放比下,训练时间与 Dreamer 相近。由于 PPO 内在的经验复用较低,与回放比 32 的 Dreamer 相比约快 10 倍,除非受环境速度限制。
其他基线。Minecraft 尚无文献报告端到端从零成功学习[19],因此我们额外调优 IMPALA 和 Rainbow,使用 Acme 实现[51],同样的 IMPALA 网络,并调学习率及熵正则。连续控制运行 TD-MPC2[43]官方实现,分别输入本体感觉与图像。其代码对视觉输入采用数据增强和帧堆叠,论文未说明,但对表现至关重要。本体输入训练需 1.3 天,像素输入需 8.0 天。另与文献中广泛的调优专家方法比较[9,10,33,36,41,44,52–54]。
方法:基准协议
各基准汇总分数见扩展表 1,逐任务分数和学习曲线见独立补充材料。扩展表 2 汇总设定;有公认协议时我们遵循它。Atari 有 57 个任务、使用 sticky actions[35,55]。随机和人类归一化参考值在文献中不同,我们选最常见的值,并在补充材料复列。
DMLab 有 30 个任务[39,52],使用修正的动作空间[33,56]。因无法承担部分既有工作 100 亿步的成本,我们在 1 亿步评估。基线在此预算表现差,故与其 10 亿步表现比较,给予基线 10 倍数据优势。ProcGen 使用困难难度和无限关卡集[38];不同既有工作步数预算不同[34,38],我们因无动作重复及计算成本,在 5,000 万步比较。
Minecraft Diamond 纯稀疏奖励协议以 1 亿环境步时的回合回报为指标,相当于约 100 天游戏时间。Atari100k[18]有 26 个任务,预算 40 万环境步,重复动作后为 10 万决策步。此前各环境设定不同,见扩展表 3;我们选择最初提出时的环境。视觉与本体控制为相同的 20 项任务[22,42],预算 100 万步。除文献规定外,各基准不用动作重复。
环境实例。早期实验发现,Dreamer 和 PPO 对实例数量都较稳健。依据训练机器的 CPU 资源,默认采用 16 个。BSuite 要求单实例;Atari100K 也用单实例,因为总预算 40 万环境步,而单回合原则上可达 432,000 步。Minecraft 环境较慢,使用远程 CPU 工作进程运行 64 个实例以加速。
种子与误差条。Dreamer 与 PPO 每个基准各运行 5 个种子;BSuite 按要求 10 个;Minecraft 用 10 个以可靠报告取得钻石的运行比例。所有曲线为种子均值,阴影为一个标准差。
计算选择。每个 Dreamer 和 PPO 智能体均使用单张 Nvidia A100。Dreamer 默认 2 亿参数;回放比权衡计算成本与数据效率,如图 6,并依据各基准步数预算选择。
译注:默认尺寸与环境例外均按原文保留:扩展表 2 中 DMC 本体感觉的模型为 100 万参数。正文 critic 小节的 T = 16 和扩展表 5 的想象跨度 H = 15 采用不同记号,本译稿分别保留其原值。
方法:Dreamer 的代际变化
这是 Dreamer 系列第三代;需要区分时称 DreamerV3。DreamerV1[22]限于连续控制,DreamerV2[23]在 Atari 超过人类,DreamerV3 可直接采用默认配置学习多样基准。主要改动如下。
- 稳健性:观察 symlog、KL 平衡与 free bits 结合、RSSM 和 actor 类别分布的 1% unimix、百分位回报归一化、奖励头及 critic 的 symexp two-hot 损失。
- 网络:分块门控循环单元(block GRU)、RMSNorm 归一化、SiLU 激活。
- 优化器:自适应梯度裁剪、LaProp(先 RMSProp,再动量)。
- 回放缓冲区:更大容量、在线队列、保存及更新潜在状态。
方法:模型、网络与分布
模型尺寸。为适应计算预算并分析尺寸稳健性,我们定义扩展表 4 的模型。模型维度大致按 1.5 倍增加,交替采用 2 的幂和其 1.5 倍,使张量尺寸为硬件高效所需的 8 的倍数。MLP 隐藏单元数等于模型维度;序列模型循环单元为其 8 倍,分为 8 块,每块与 MLP 同宽。最靠近数据的卷积编解码层通道数为维度的 1/16;每个潜变量的代码数也是 1/16。隐藏层数量、潜变量数量固定,学习率、批大小等超参数也不随尺寸改变。
超参数。扩展表 5 的相同设定用于本体和视觉输入、连续及离散动作、二维及三维领域。没有退火、优先回放、权重衰减或 dropout。
网络。图像以步幅 2 卷积编码到 6 × 6 或 4 × 4,再展平;以步幅 2 转置卷积解码,输出使用 sigmoid。向量先 symlog 变换,再用三层 MLP 编解码;actor、critic 也是三层 MLP,奖励和继续预测器为一层 MLP。序列模型是 GRU[57],循环权重为 8 块的分块对角矩阵[58],增加记忆单元却不使参数与计算平方增长。每步输入为采样潜变量 zₜ、动作 aₜ 与循环状态的线性嵌入,以允许各块间信息混合。
分布。编码器、动力学预测器和 actor 的分布为 99% 预测 softmax、1% 均匀分布的混合[59],避免零概率及无穷对数概率。奖励和 critic 输出指数间隔分箱上的 softmax,以 two-hot 目标训练:
twohot(x)ᵢ ≔ |b_k₊₁ − x|/|b_k₊₁ − b_k|(i = k);|b_k − x|/|b_k₊₁ − b_k|(i = k+1);其余为 0。其中 k ≔ Σⱼ₌₁^|B| δ(bⱼ < x),δ 为指示函数。
Two-hot 输出权重初始化为零,以免初始时凭空产生奖励和价值。分箱跨多个数量级时,计算期望的求和顺序很重要:正负分箱应各自从小到大求和,再相加。实现详见源码。
方法:优化与经验回放
优化器。自适应梯度裁剪[60]在各张量梯度超过对应权重矩阵 L2 范数的 30% 时裁剪,采用默认 ε = 10⁻³。这样裁剪阈值与损失尺度解耦,改变损失或权重无须调整阈值。用 LaProp[61]更新,ε = 10⁻²⁰,默认 β₁ = 0.9、β₂ = 0.99。LaProp 先经 RMSProp 归一梯度,再用动量平滑;Adam[62]则对原始梯度分别计算动量和归一量。这项简单变化允许更小 epsilon,避免我们在 Adam 下偶尔遇到的不稳定。
经验回放。采用带在线队列的均匀回放缓冲区[63]。每个小批先放不重叠的在线轨迹,再用缓冲区均匀抽样轨迹补满。收集时存潜在状态,用来初始化回放轨迹的世界模型;训练展开得到的新潜在状态再写回缓冲区。一些专家算法用优先回放[64],我们也发现它能改善 Dreamer,但为实现简单,实验选择均匀回放。
训练量用回放比表示:每个采集时间步训练的时间步数之比,不计动作重复。将回放比除以小批时间步数,再除以动作重复,即梯度步与环境步之比。例如 Atari 的回放比 32、动作重复 4、批形状 16 × 64,对应每 128 环境步一次梯度更新,2 亿环境步约 150 万次更新。
方法:Minecraft 的环境设定
游戏描述。原文称 Minecraft 有 1 亿月活用户,是最流行游戏之一。其三维世界程序生成,包含平原、森林、丛林、山地、沙漠、针叶林、雪原、冰刺、沼泽、稀树草原、恶地、海滩、石岸、河流与海洋。世界由 1 米方块组成,可破坏和放置;约 30 种生物可交互或战斗。玩家收集资源,用 350 多种配方制作物品,沿技术树发展,同时保障安全和食物。研究首先聚焦获取钻石:地下深处稀有物品,需要逐步推进技术树。
译注:用户数量和游戏内容数字均为论文的历史描述,并非本站核实的当前游戏统计。
学习环境。Minecraft Diamond 建于 MineRL v0.4.4[19],使用 Minecraft 1.11.2 和抽象合成动作。我们公开这个忠实于 MineRL、动作空间标准化且适合强化学习的版本,定义平坦类别动作,并通过人工试玩修复错误。例如破坏钻石矿后,物品有时直接进背包、有时落地需拾取;原环境立即结束,导致很多成功回合未收到物品奖励。我们取消这一提前结束,改为死亡或 36,000 步结束,即 20 Hz 下 30 分钟。游戏有时漏掉迅速按下又释放的跳跃键,所以保持按键 200 ms。相机俯仰限制为 120°,以避免奇异情况。
观察与奖励。智能体观察 64 × 64 × 3 第一人称图像、400 多种物品的背包计数、从回合开始至今各物品最大计数、已装备物品的 one-hot,以及生命、饥饿和呼吸标量。沿用 MineRL 的稀疏奖励结构[19]:原木、木板、木棍、工作台、木镐、圆石、石镐、铁矿石、熔炉、铁锭、铁镐、钻石,共 12 个里程碑。每种每回合只奖一次;智能体仍须学会重复收集某些物品,才能到下一里程碑。为使回报易解释,每个里程碑统一 +1,而非按价值缩放;失去一颗心 −0.01、恢复一颗心 +0.01,但我们没有调查这是否有帮助。
动作空间。MineRL 竞赛环境是文献标准[3,19,20],但复杂字典动作空间需要额外连接工作,包括鼠标相机移动、键盘移动、鼠标采矿和交互,以及抽象背包合成、装备动作。我们尽可能简单地将其变为扩展表 7 的 25 类动作。跳跃同时按跳跃和前进,因为类别空间一次只允许一个动作,单独跳跃只能原地跳,不能跳上物体。文献中的 Minecraft 课程学习用过类似但更复杂的空间[20]。
破坏速度。Minecraft 破坏方块需要连续按鼠标左键数秒,即 20 Hz 下数百步。初始均匀 25 类策略,破坏面前木块的概率约为 (1/25)⁴⁰⁰ ≈ 10⁻⁵⁶⁰;若没有人类使用计算机方式的先验,从零发现这种行为几乎不可能。可以用学到的动作重复等归纳偏置[65]克服,但我们认为连续数百步保持同一按键,不是 Minecraft 对人工智能有趣的核心。因而遵循已有工作[20]加快破坏,按材料仅需几个时间步。调优基线结果表明,环境仍然很有挑战。
其他环境。Voyager 使用高层 MineFlayer 脚本库,动作抽象程度更高:例如预定义探索直到找到资源,或自动挖掘 32 米内指定材料[47];观察也是高层语义而非图像。MineRL 竞赛仍需视觉及低层移动与相机控制,例如跳上方块、转相机面对采矿目标。VPT[21]用鼠标制作物品,不加快破坏,比 MineRL 动作空间更难,却更容易取得对应人类数据。其作者用大量领域知识设计层级空间,包括 121 种注视区鼠标移动和 4,230 种有意义按键组合。我们推荐:偏好简单设置时用本稿 MineRL 类别空间;无需感知和低层控制、只提示语言模型时用 Voyager;使用人类数据时用 VPT 空间。
数据、代码与作者声明
数据可用性。算法运行时通过与模拟环境交互自行生成经验数据,不使用外部数据集。训练曲线的数据点可在代码仓库取得。
代码可用性。Dreamer 及本文全部实验源码,在 github.com/danijar/dreamerv3 以开源许可提供。
致谢。感谢 M. Norouzi、J. Lin、A. Abdolmaleki、J. Schulman、M. Rowland、A. Kosiorek、O. Rybkin 的讨论;B. Shahriari、D. Yarats、K. Cobbe、H. Soyer 分享基线训练曲线;D. Furrer、A. Chen、D. Garambha 支持 Google Cloud 基础设施。
作者单位:Danijar Hafner、Jurgis Pasukonis、Timothy Lillicrap 来自美国旧金山 Google DeepMind;Jimmy Ba 来自加拿大多伦多大学。通讯作者为 Danijar Hafner。
作者贡献。D.H. 设计、实现算法,完成多数实验、绘图并写论文;J.P. 参与算法设计并进行基线实验;J.B. 提供思想和反馈;T.L. 参与算法设计、建议实验并提供大量反馈。作者声明不存在竞争性利益。
同行评审。Nature 感谢 Hao Su 及其他匿名审稿人的贡献。出版方说明:Springer Nature 对地图及机构隶属关系中的管辖权主张保持中立。
扩展数据图
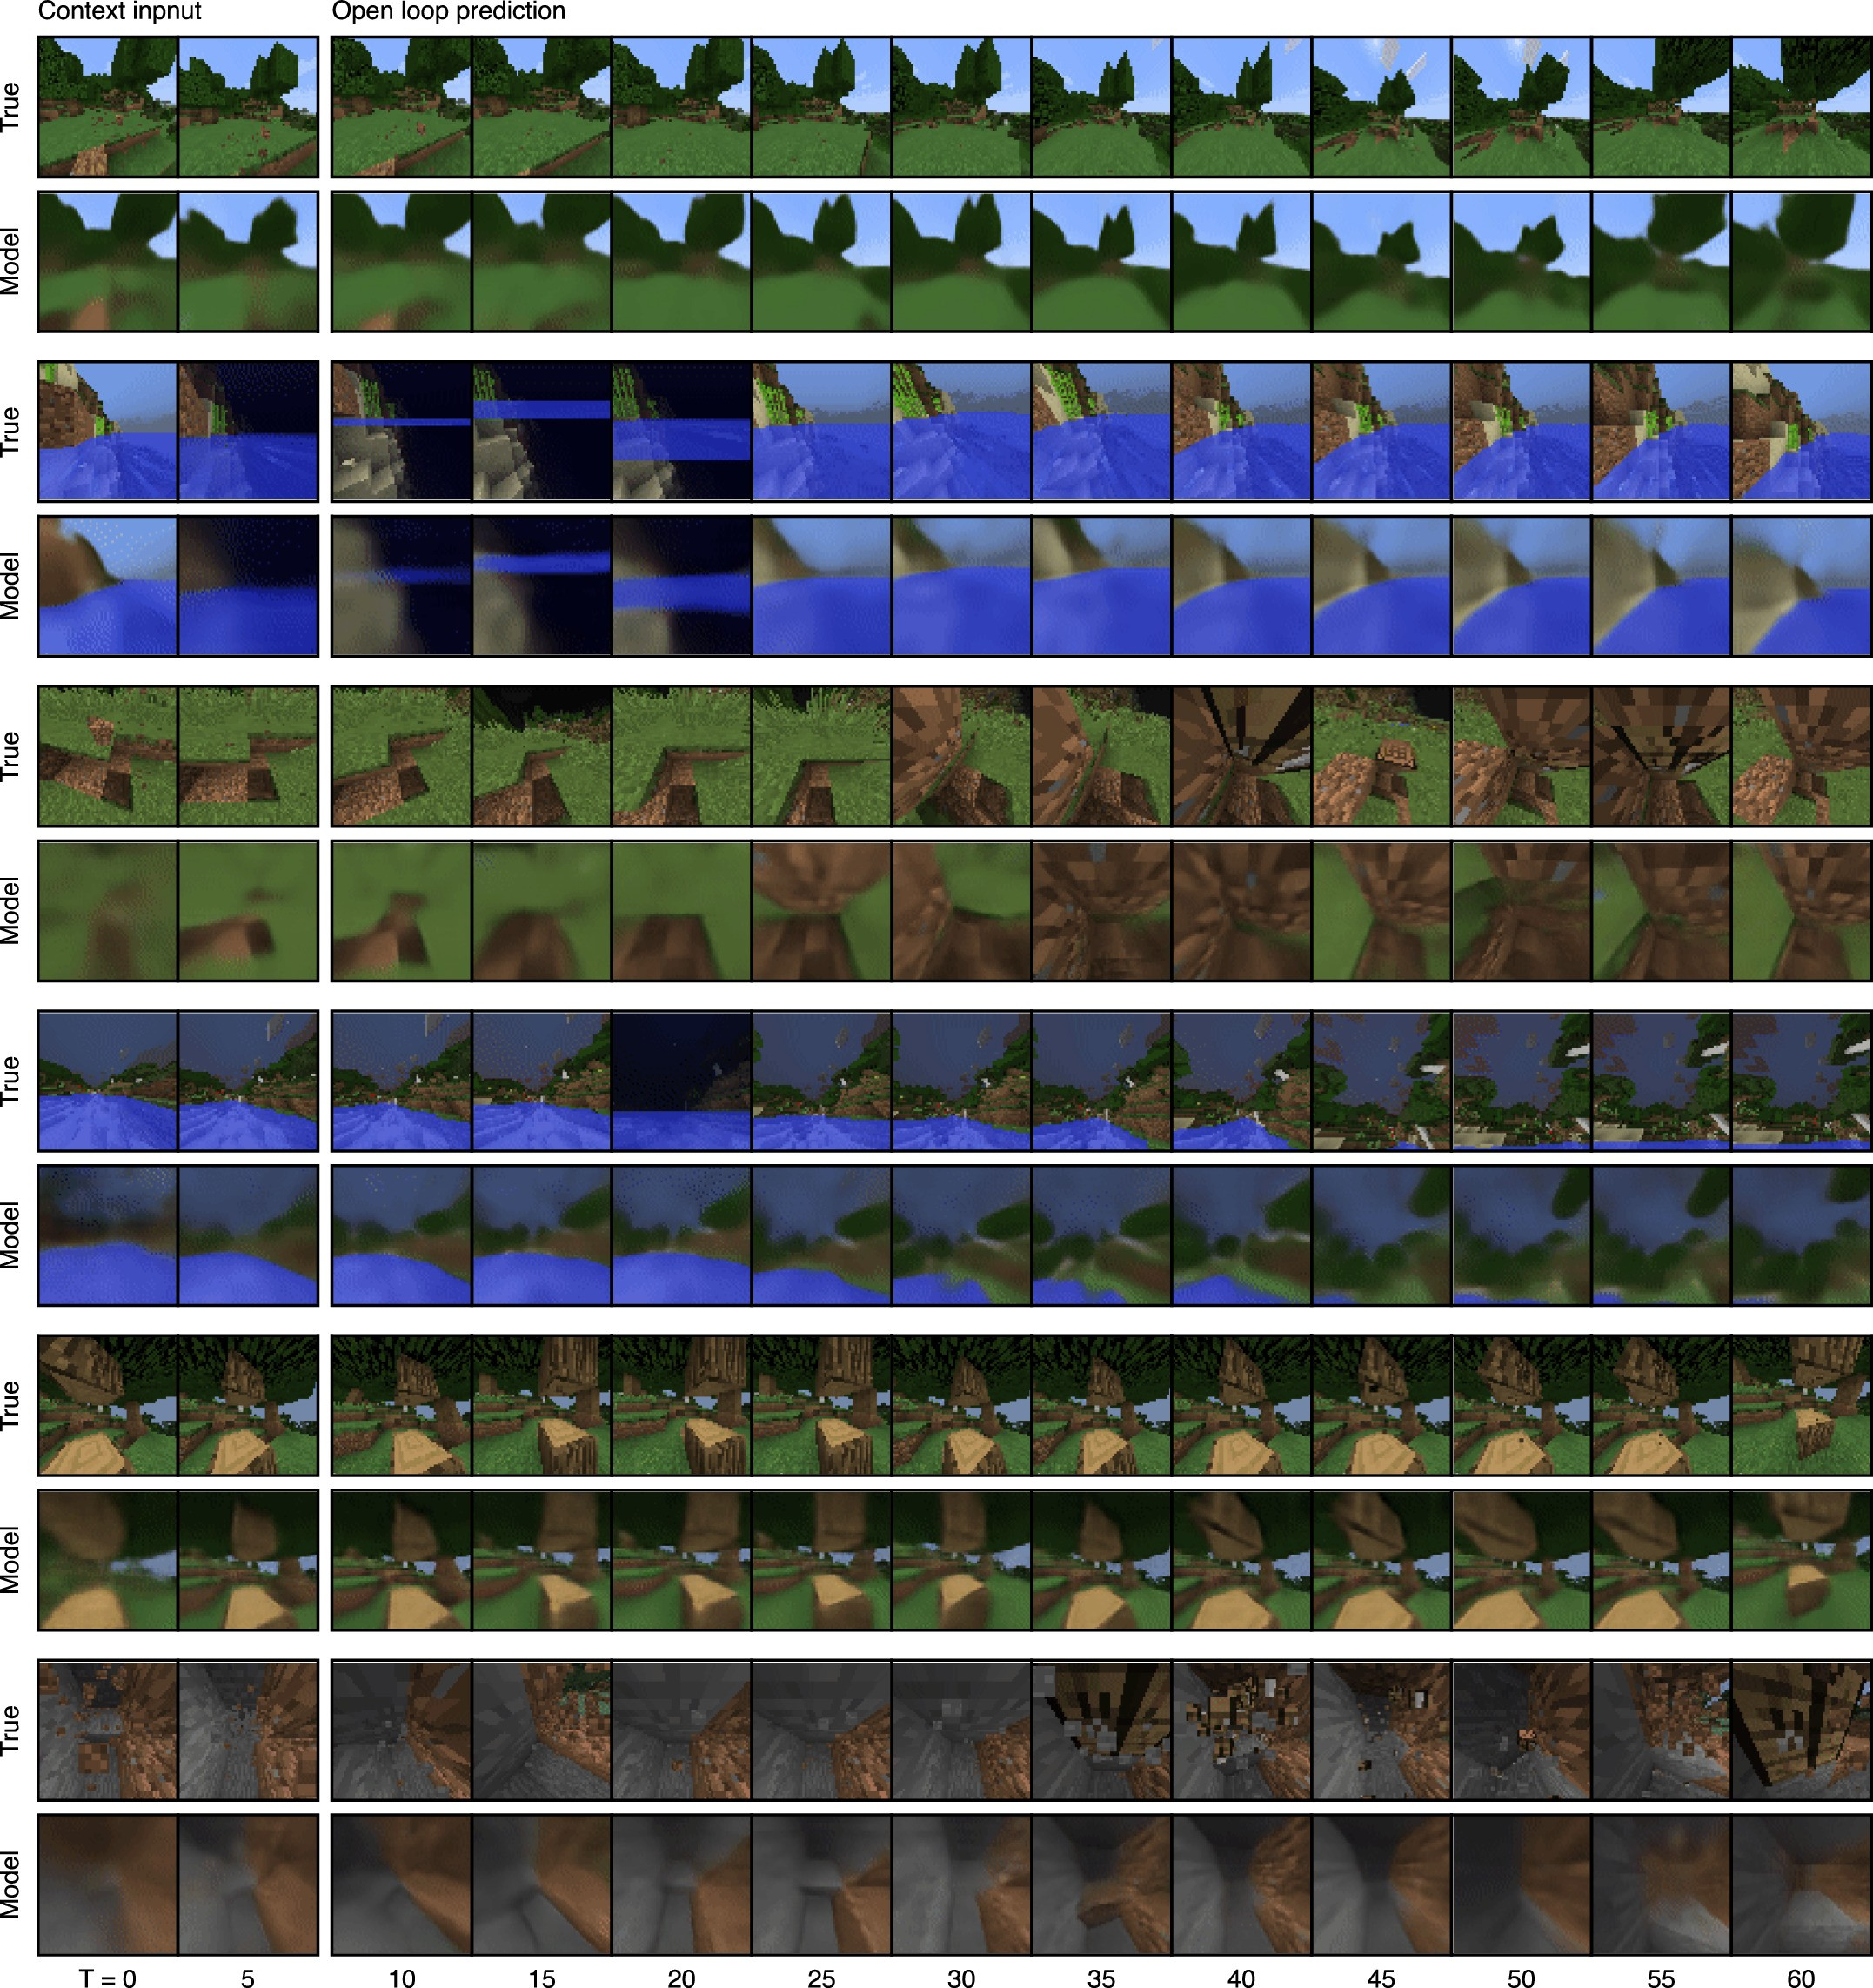
扩展图 1:Minecraft 视频预测。给定未见视频前 5 帧及动作序列,世界模型在不访问中间图像的情况下预测未来 45 步。
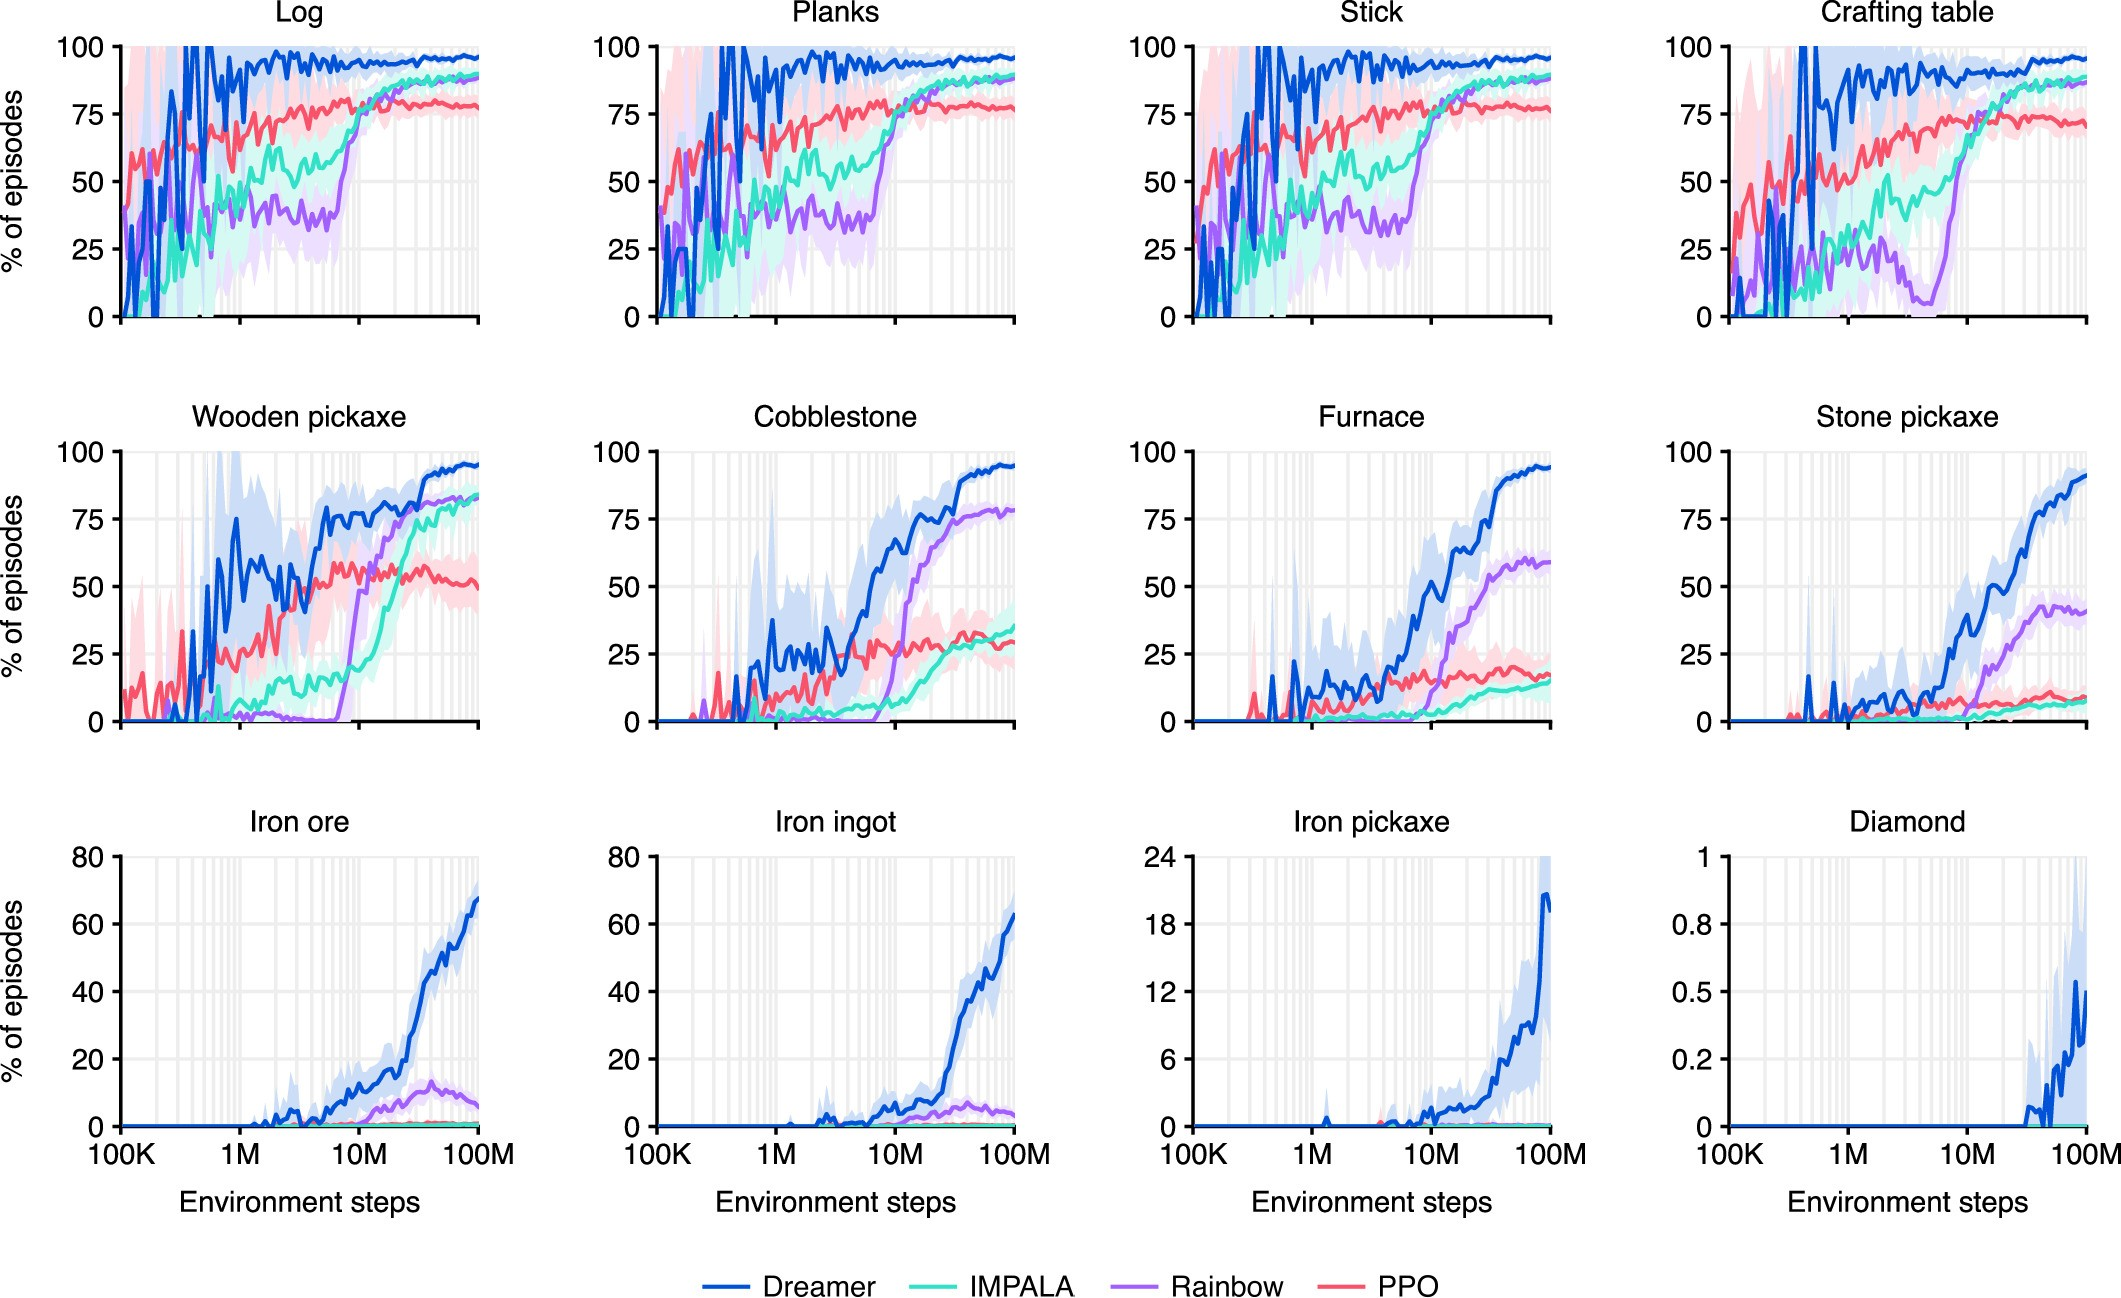
扩展图 2:Minecraft 物品成功率。Dreamer 取得物品的比例显著高于基线,训练过程中仍持续改善难获取物品的成功率。
扩展表 1. 基准分数
| 基准 | 评分 | Dreamer | PPO | 调优专家 1 | 专家 1 分数 | 调优专家 2 | 专家 2 分数 |
|---|---|---|---|---|---|---|---|
| Minecraft | 回报 | 9.1 | 5.1 | IMPALA | 7.1 | Rainbow | 6.3 |
| DMLab | 截顶均值 | 71 | 36 | IMPALA(10倍数据) | 66 | R2D2+(10倍数据) | 65 |
| ProcGen | 归一化均值 | 72 | 43 | PPG | 65 | Rainbow | 55 |
| Atari | 玩家归一化中位数 | 830 | 180 | MuZero | 693 | Rainbow | 223 |
| Atari100K | 玩家归一化均值 | 125 | 11 | IRIS | 105 | TWM | 96 |
| BSuite | 任务均值 | 66 | 49 | BootDQN | 60 | DQN | 54 |
| DMC 视觉 | 任务均值 | 802 | 206 | DrQ-v2 | 705 | TD-MPC2 | 634 |
| DMC 本体感觉 | 任务均值 | 843 | 205 | DMPO | 834 | TD-MPC2 | 825 |
扩展表 2. 基准设置
| 基准 | 任务 | 环境步 | 动作重复 | 环境实例 | 回放比 | GPU 天数 | 模型参数 |
|---|---|---|---|---|---|---|---|
| Minecraft | 1 | 100M | 1 | 64 | 32 | 8.9 | 200M |
| DMLab | 30 | 100M | 4 | 16 | 32 | 2.9 | 200M |
| ProcGen | 16 | 50M | 1 | 16 | 32 | 8.3 | 200M |
| Atari | 57 | 200M | 4 | 16 | 32 | 7.7 | 200M |
| Atari100K | 26 | 400K | 4 | 1 | 128 | 0.1 | 200M |
| BSuite | 23 | — | 1 | 1 | 1024 | 0.5 | 200M |
| DMC 视觉 | 20 | 1M | 1 | 16 | 256 | 1.2 | 200M |
| DMC 本体感觉 | 20 | 1M | 1 | 16 | 1024 | 1.5 | 1M |
扩展表 3. 与 SimPLe 原始 Atari100k 协议的差异
| 项目 | SimPLe | EffMuZero | SPR | IRIS | TWM | Dreamer |
|---|---|---|---|---|---|---|
| 玩家归一化分数(%) | 33 | 190 | 62 | 105 | 96 | 125 |
| 玩家归一化中位数(%) | 13 | 109 | 40 | 29 | 51 | 49 |
| 计算(A100 天) | 5.0 | 0.6 | 0.1 | 3.5 | 0.4 | 0.1 |
| 在线规划 | — | × | — | — | — | — |
| 数据增强 | — | — | × | — | — | — |
| 非均匀回放 | — | × | × | — | × | — |
| 独立超参数 | — | — | — | × | — | — |
| 提高分辨率 | — | × | × | — | — | — |
| 使用生命信息 | — | × | × | × | × | — |
| 提前重置 | — | × | — | × | — | — |
| 独立评测回合 | × | × | × | × | × | — |
译注:表内 × 表示采用该项设置,— 表示未采用。协议差异本身不是性能排名;它提醒读者比较分数时同时检查环境、数据与评测条件。
扩展表 4. Dreamer 模型尺寸
| 组件 | 1M | 12M | 25M | 50M | 100M | 200M | 400M |
|---|---|---|---|---|---|---|---|
| 隐藏宽度 d | 64 | 256 | 384 | 512 | 768 | 1024 | 1536 |
| 循环单元 8d | 512 | 2048 | 3072 | 4096 | 6144 | 8192 | 12288 |
| 基础卷积通道 d/16 | 16 | 16 | 24 | 32 | 48 | 64 | 96 |
| 每个潜变量的代码数 d/16 | 4 | 16 | 24 | 32 | 48 | 64 | 96 |
译注:100 万参数列的基础卷积通道原表为 16,按表保留,不根据列名 d/16 改成 4。正文扩展实验的六种尺寸从 1,200 万起;本表另含本体感觉实验使用的小模型。
扩展表 5. Dreamer 超参数
| 分组 | 名称 | 符号 | 值 |
|---|---|---|---|
| 通用 | 回放容量 | — | 5 × 10⁶ |
| 通用 | 批大小 | B | 16 |
| 通用 | 批长度 | T | 64 |
| 通用 | 激活 | — | RMSNorm + SiLU |
| 通用 | 学习率 | — | 4 × 10⁻⁵ |
| 通用 | 梯度裁剪 | — | AGC(0.3) |
| 通用 | 优化器 | — | LaProp(ε = 10⁻²⁰) |
| 世界模型 | 重建损失尺度 | β_pred | 1 |
| 世界模型 | 动力学损失尺度 | β_dyn | 1 |
| 世界模型 | 表征损失尺度 | β_rep | 0.1 |
| 世界模型 | 潜变量 unimix | — | 1% |
| 世界模型 | free nats | — | 1 |
| Actor–critic | 想象跨度 | H | 15 |
| Actor–critic | 折扣跨度 | 1/(1−γ) | 333 |
| Actor–critic | 回报 lambda | λ | 0.95 |
| Actor–critic | critic 损失尺度 | β_val | 1 |
| Actor–critic | critic 回放损失尺度 | β_repval | 0.3 |
| Actor–critic | critic EMA 正则 | — | 1 |
| Actor–critic | critic EMA 衰减 | — | 0.98 |
| Actor–critic | actor 损失尺度 | β_pol | 1 |
| Actor–critic | actor 熵正则 | η | 3 × 10⁻⁴ |
| Actor–critic | actor unimix | — | 1% |
| Actor–critic | actor 回报归一化范围 | S | Per(R,95) − Per(R,5) |
| Actor–critic | actor 回报归一化下限 | L | 1 |
| Actor–critic | actor 回报归一化衰减 | — | 0.99 |
扩展表 6. PPO 超参数
| 参数 | 值 |
|---|---|
| 观察归一化 | 是 |
| 奖励归一化 | 是 |
| 奖励裁剪(标准差) | 10 |
| 每个 epoch 的批 | 64 × 256 |
| epoch 数 | 3 |
| 小批大小 | 8 |
| 小批长度 | 256 |
| 策略信赖域 | 0.2 |
| 价值信赖域 | 否 |
| 优势归一化 | 是 |
| 熵惩罚尺度 | 0.01 |
| 折扣因子 | 0.997 |
| GAE lambda | 0.95 |
| 学习率 | 3 × 10⁻⁴ |
| 梯度裁剪 | 0.5 |
| Adam epsilon | 10⁻⁵ |
扩展表 7. Minecraft 类别动作空间
| 编号 | 动作标识 | 中文说明 |
|---|---|---|
| 0 | noop | 不操作 |
| 1 | attack | 攻击/采矿 |
| 2 | turn_up | 视角向上 |
| 3 | turn_down | 视角向下 |
| 4 | turn_left | 视角向左 |
| 5 | turn_right | 视角向右 |
| 6 | walk_forward | 前进 |
| 7 | walk_back | 后退 |
| 8 | walk_left | 向左移动 |
| 9 | walk_right | 向右移动 |
| 10 | jump_forward | 向前跳 |
| 11 | place_dirt | 放置泥土 |
| 12 | craft_planks | 合成木板 |
| 13 | craft_stick | 合成木棍 |
| 14 | craft_crafting_table | 合成工作台 |
| 15 | place_crafting_table | 放置工作台 |
| 16 | craft_wooden_pickaxe | 合成木镐 |
| 17 | craft_stone_pickaxe | 合成石镐 |
| 18 | craft_iron_pickaxe | 合成铁镐 |
| 19 | equip_stone_pickaxe | 装备石镐 |
| 20 | equip_wooden_pickaxe | 装备木镐 |
| 21 | equip_iron_pickaxe | 装备铁镐 |
| 22 | craft_furnace | 合成熔炉 |
| 23 | place_furnace | 放置熔炉 |
| 24 | smelt_iron_ingot | 冶炼铁锭 |
译注:动作标识保留原实现字符串;中文列用于解释,不改变程序动作名称。
原文与来源
- DreamerV3:Nature 2025 正式版全文、Methods 与许可说明 ↗
- Creative Commons:CC BY 4.0 许可条款 ↗
- DreamerV3:Nature 正式 PDF,含全部扩展数据图表 ↗
图片:Danijar Hafner、Jurgis Pasukonis、Jimmy Ba、Timothy Lillicrap · Nature(2025)· CC BY 4.0 · 完整原图,图内内容未改