
手还没伸出去,先试几种走法
桌上的小球要放进托盘,中间却挡着一块积木。机械臂可以直接伸过去,撞上障碍后再改;也可以先估计几种动作的结果:向前推会碰到什么,往侧面绕是否还有空间,夹起小球后能不能落到托盘里。这个场景是帮助理解的设想,不对应某一篇论文的实验。
世界模型让后一种做法有了计算上的实现:用已有观测和行动经验,学习一个预测器;再让行动选择程序在预测器中试探后果。“想象”在这里指模型推演出来的状态序列,可能是画面,也可能只是一串压缩特征。它不等于人类的主观体验。
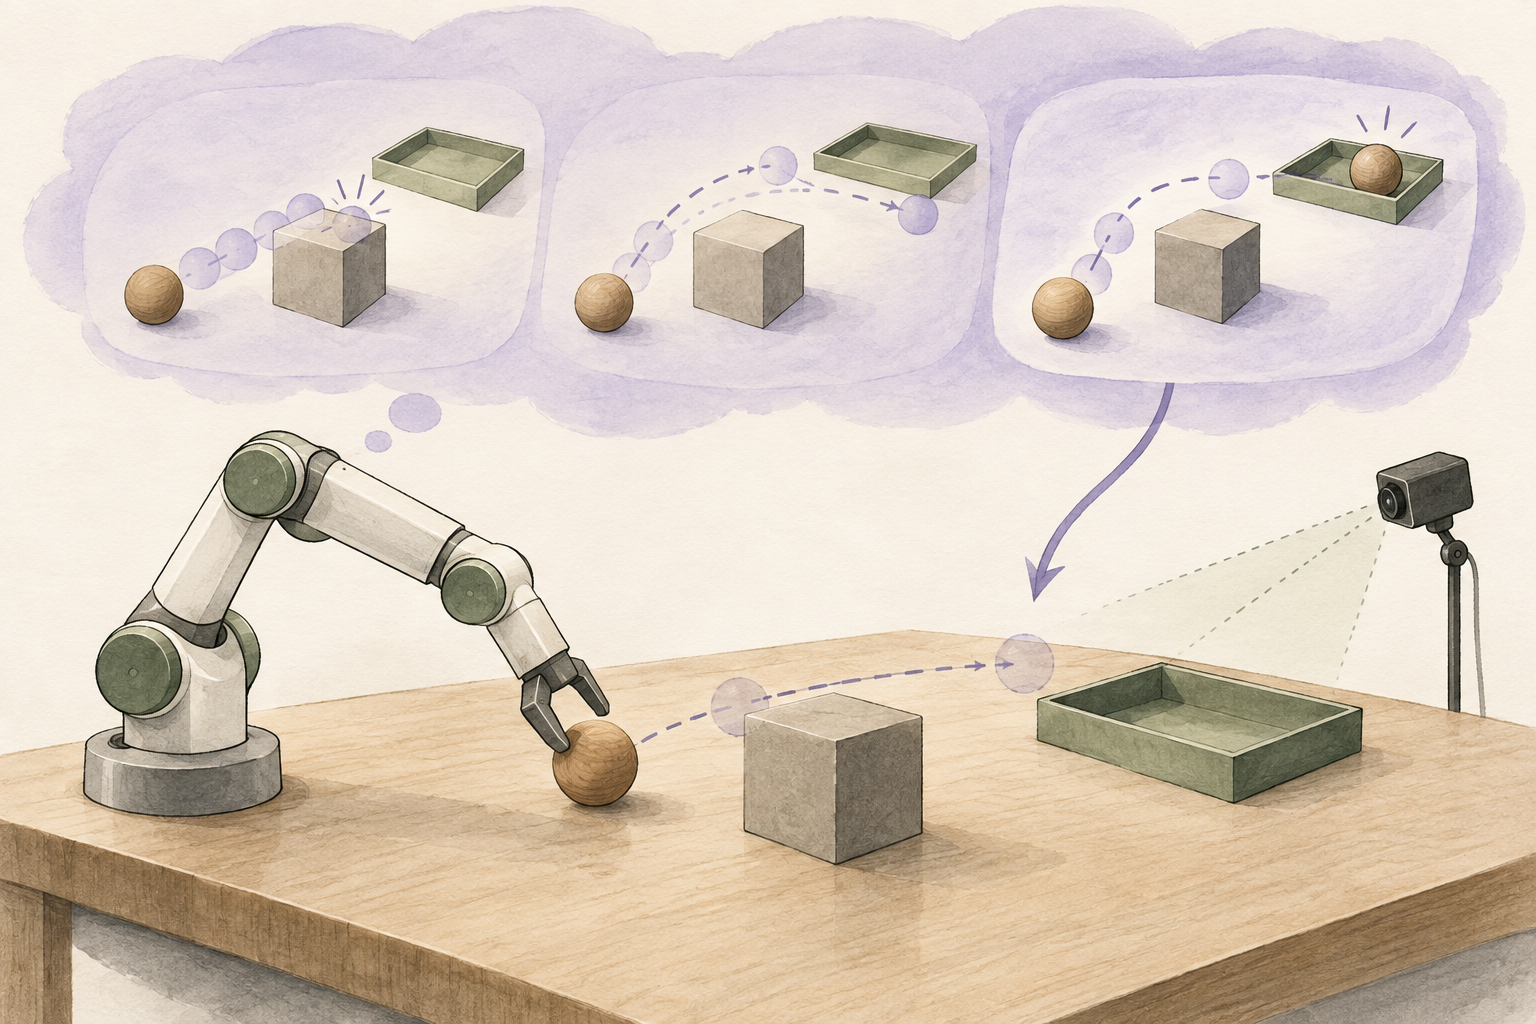
概念示意:同一个起点可以推演出不同结果,再选一个动作交给环境检验。图为 AI 生成插画,不是论文实验截图。
想象的材料来自经验
预测器需要知道“做了什么”与“接下来发生了什么”的关系。在有交互数据的设置中,一段经验会记录观测、行动以及后续观测;有些方法还记录奖励和任务是否结束。模型从这些序列中学习,预测执行某个动作后的状态或奖励。
来源:原始报告 ↗
这里的“状态”未必是环境中每件物体的精确三维位置。相机画面可以先被编码成较小的向量,动态模型随后在这些向量之间预测。压缩使反复推演更便宜,但如果表征丢掉了抓取所需的细节,后面的预测和行动也会受到限制。
观看普通视频与学习行动后果还隔着一层。V-JEPA 2 先利用无行动标签的视频学习表征,再用带行动和机器人状态的轨迹训练 V-JEPA 2-AC。不能把“看过大量视频”直接读成“已经知道任意一个控制指令会发生什么”。
来源:原始报告 ↗
在模型里练习,有两种常见用途
一种用途是训练策略。策略负责根据当前状态选动作;它在模型推演的轨迹中反复学习,逐渐偏向预期回报更高的选择。DreamerV3 用世界模型预测后果,用价值网络估计回报,再更新行动策略。策略真正与环境交互时,从策略网络取动作,并不需要每次都重新搜索整棵未来树。
来源:原始报告 ↗
另一种用途是在执行时规划。给定一个目标,程序试出多条候选行动序列,比较预测终点与目标的差距,选出较好的一条。DINO-WM 在冻结的 DINOv2 图像块特征上预测动态,用目标观测的特征来优化行动;这条路线可以在测试时针对目标求解,而不必先为每个目标训练一个专用策略。
来源:原始报告 ↗
两种用途都使用预测器,但“训练时在想象中学会怎么做”与“此刻在模型里搜索下一步”是不同过程。一段演示视频本身很难告诉你是哪一种,需要看论文的训练和执行环节。
预测结果好不好,要有明确的判断
回到小球的例子:一条预测轨迹画面很流畅,却停在托盘旁边;另一条画面粗糙,但预测小球能到达目标。行动选择要优化哪一条,取决于任务怎样定义。预测质量与任务完成程度有关,却不能互相替代。
在奖励驱动的方法里,模型预测奖励,价值网络估计后续回报,策略据此学习。在目标驱动的规划里,可以比较预测表征与目标表征的距离。DINO-WM 和 V-JEPA 2-AC 的相关实验采用图像目标;这不表示它们天然接受任意一句语言指令。
判断指标还决定了模型需要保留什么。想完成抓取,就需要对接触位置和物体状态足够敏感;如果一个特征距离对这些细节不敏感,分数变小也可能伴随实际任务失败。这是理解目标设计时应检查的条件,不是对某个系统成功率的额外结论。
执行之后,重新看一眼
模型推演的下一帧与摄像头真正拍到的下一帧,可能并不相同。物体滑了一点、夹爪没有闭合、遮挡让位置估计偏了,都会让原来那条计划失去依据。闭环执行会把新观测带回来,再更新状态、重新规划。
来源:原始报告 ↗
V-JEPA 2-AC 的模型预测控制会优化一个有限长度的行动序列,执行后利用新的视觉输入继续规划。论文还把较复杂的拾取放置任务拆成多个图像子目标。因此,看到它完成整段任务,不能据此推断它从第一帧起就准确预测了全程。
如果系统还在持续学习,新经验也可以进入经验池,用来改进预测器和策略。DreamerV3 的模型、价值网络与策略在环境交互期间利用回放经验并行训练。“先学习,再想象,最后执行”有助于理解职责;实际训练通常是不断重复的循环。
来源:原始报告 ↗
《World Models》把这件事做成了一个早期例子
2018 年的《World Models》用视觉模型压缩画面,用循环动态模型预测潜在状态,再让一个较小的控制器决定行动。在 DoomTakeCover 实验中,控制器可以在学到的虚拟环境里训练,然后放回原始游戏环境测试。
来源:原始报告 ↗
这里的“真实环境”是原始游戏模拟器,相对于学出来的梦境模型而言;不是把一个游戏里的控制器直接装进实体机器人。迁移是否有效,需要看目标环境上的测试,而不能只看梦境中的得分。
原报告也讨论了控制器利用模型漏洞的风险:若预测器漏掉危险,控制器可能在模型里学到看似有利、实际却会失败的行为。这使“想象中表现好”成为有待验证的假设。
节省试错,靠的是一个有边界的模型
在模型里试很多动作,通常比让实体设备执行同样多的动作更方便。但它只是在替代一部分试错成本。观测数据、模型训练、规划计算以及实际任务验证仍然需要投入;多少经验可以省下来,要由具体实验回答。
多步推演还会把前面的预测误差带到后面。V-JEPA 2 明确把误差积累列为长时规划的限制,并指出相机位置、单目观测的歧义和子目标设置会影响控制。能完成若干新物体上的操作,不等于掌握了所有物理环境。
来源:原始报告 ↗
判断一项“在想象中学习”的工作,可以顺着一次行动读下去:模型从什么经验学习,预测的究竟是什么,谁负责挑动作,执行后有没有再接收观测,最后在哪个环境里验证。把这条链看清,才知道模型里的进步如何走到环境中。