
版本与译文说明
原题:Learning Latent Dynamics for Planning from Pixels(学习潜在动力学,从像素进行规划)。原作者:Danijar Hafner、Timothy Lillicrap、Ian Fischer、Ruben Villegas、David Ha、Honglak Lee、James Davidson。本文译自 ICML 2019 正式会议版,刊于 Proceedings of Machine Learning Research 第 97 卷,2555–2565 页;附录采用该论文的正式补充 PDF。译者:世界模型图谱。
译文覆盖摘要、正文第 1–7 节、致谢及附录 A–J,保留全部 12 幅图、结果表和公式。算法 1、2 依原执行顺序写成步骤。完整参考书目及作者视频、代码请见文末原文入口。正文的“我们”指原作者;关于最佳表现、计算时间与数据效率的判断,保留为论文发表时的实验结论,本站没有独立复现。
PMLR 的出版协议将论文按 CC BY 4.0 向公众授权,要求保留原论文引用并链接到 PMLR 原文。本中文译文属于翻译及排版改编,亦采用 CC BY 4.0。原图从正式 PDF 提取完整图版,图内文字与各面板顺序保持原样;原 PDF、图版提取记录、署名与许可均已保留。
摘要
在环境动力学已知的控制任务中,规划一直十分成功。要在未知环境中利用规划,智能体需要通过与世界交互来学习动力学。然而,学到足够准确、能够用于规划的动力学模型,长期以来都是一个挑战,在基于图像的领域尤其如此。我们提出深度规划网络(Deep Planning Network,PlaNet):一个完全基于模型的智能体,从图像学习环境动力学,并在潜在空间中通过快速在线规划选择动作。
要取得高性能,动力学模型必须准确预测未来多个时间步的奖励。我们采用同时具有确定性和随机性转移组件的潜在动力学模型来处理这一问题。此外,我们提出名为潜在多步预测约束(latent overshooting)的多步变分推断目标。仅使用像素观察,我们的智能体就能解决包含接触动力学、部分可观测性及稀疏奖励的连续控制任务;这些任务比此前通过学习模型来规划所解决的任务更难。PlaNet 使用的轨迹回合显著更少,最终性能接近强大的无模型算法,有时还更高。
1. 引言
对于动力学已知的决策问题,例如博弈和模拟机器人控制,规划是一种自然且有力的方法(Tassa 等,2012;Silver 等,2017;Moravčík 等,2017)。要在未知环境中规划,智能体就必须从经验学习动力学。长期的难点包括模型不准确、多步预测误差累积、不能刻画多种可能的未来,以及对训练分布之外的情况作出过度自信的预测。
与无模型强化学习相比,使用学到的模型来规划有几项好处。基于模型的规划利用更丰富的训练信号,不必通过贝尔曼回溯逐步传播奖励,因而可能更节省数据。规划也有望仅通过增加动作搜索的计算预算来提高表现,Silver 等(2017)展示了这一点。最后,学到的动力学可以不依赖具体任务,因而可能迁移到同一环境中的其他任务。
近期研究在简单、低维环境的动力学学习上展现了潜力(Deisenroth 与 Rasmussen,2011;Gal 等,2016;Amos 等,2018;Chua 等,2018;Henaff 等,2018)。但这些方法通常假定能够访问世界的底层状态和奖励函数,而实际中未必可以。对于高维环境,我们希望在紧凑的潜在空间学习动力学,以便快速规划。此前这类潜在模型的成功主要限于平衡倒立摆、在密集奖励下控制双连杆机械臂等简单任务(Watter 等,2015;Banijamali 等,2017)。
本文提出 PlaNet:从像素学习环境动力学,再在紧凑潜在空间进行在线规划的智能体。转移模型兼有随机性与确定性组件;我们还试验了一种鼓励多步预测的广义变分目标。PlaNet 从像素解决的连续控制任务,比此前基于学到的模型进行规划所解决的任务更难。主要贡献如下。
- 潜在空间规划:在 DeepMind Control Suite 的多种任务上学习动力学并高效规划。最终性能显著超过无模型 A3C,在部分任务上超过 D4PG;平均所需环境交互减少约 200 倍,计算时间相近。
- 循环状态空间模型:设计同时具有确定性和随机性组件的潜在动力学模型(Buesing 等,2018;Chung 等,2015)。实验表明,两类组件对高性能规划都十分关键。
- 潜在多步预测约束:把标准变分下界推广到多步预测。只在潜在空间计算的项构成快速正则项,可以改善长期预测,并适用于任意潜在序列模型。
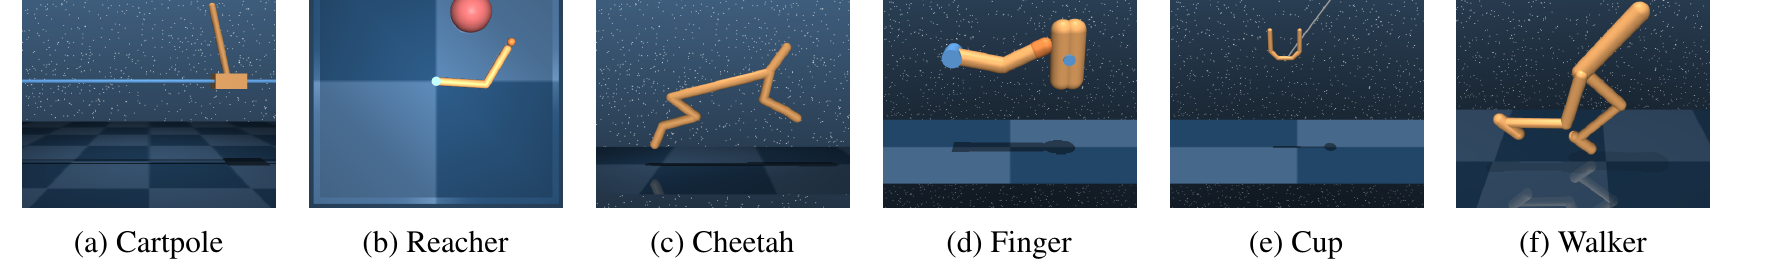
图 1:实验中的图像控制环境。画面为缩小到 64 × 64 × 3 像素之前的观察。(a)倒立摆摆起采用固定相机,小车可能移出视野。(b)机械臂触达只有稀疏奖励。(c)猎豹奔跑包含接触和较多关节。(d)手指旋转包含手指与物体的接触。(e)杯子接球仅在球被接住时给出稀疏奖励。(f)行走机器人需要保持平衡,并在倒地时预测与地面的复杂相互作用。
2. 潜在空间规划
要通过规划解决未知环境,我们需要从经验建立环境动力学模型。PlaNet 交替地通过规划收集数据、用所得数据训练模型。本节介绍环境记号与智能体的通用实现,暂时假定已经能访问学到的动力学模型;模型设计和训练目标将在第 3 节说明。
问题设定。单张图像一般不能揭示环境完整状态,因此我们考虑部分可观测马尔可夫决策过程(POMDP)。离散时间步为 t,隐藏状态为 sₜ,图像观察为 oₜ,连续动作向量为 aₜ,标量奖励为 rₜ,随机动力学为:
转移:sₜ ∼ p(sₜ | sₜ₋₁, aₜ₋₁);观察:oₜ ∼ p(oₜ | sₜ);奖励:rₜ ∼ p(rₜ | sₜ);策略:aₜ ∼ p(aₜ | o≤ₜ, a<ₜ)。(1)
不失一般性,初始状态 s₀ 固定。目标是实现策略 p(aₜ | o≤ₜ, a<ₜ),最大化期望累计奖励 Eₚ[Σₜ₌₁ᵀ rₜ],期望取遍环境及策略的分布。
基于模型的规划。PlaNet 从既往回合学习转移模型 p(sₜ | sₜ₋₁, aₜ₋₁)、观察模型 p(oₜ | sₜ) 和奖励模型 p(rₜ | sₜ)。原文以斜体记号表示学到的模型,以正体表示真实动力学。观察模型提供丰富训练信号,但不用于规划。我们还学习编码器 q(sₜ | o≤ₜ, a<ₜ),通过滤波从历史信息推断当前隐藏状态的近似信念。策略由搜索最佳未来动作序列的规划算法实现。
我们使用模型预测控制(MPC;Richards,2005),使智能体能依据新观察调整计划,也就是每一步都重新规划。与无模型及混合强化学习算法不同,我们不使用策略网络或价值网络。
经验收集。智能体初期可能无法到达环境的所有部分,因而需要反复收集新经验并改进动力学模型。算法 1 展示了如何用部分训练的模型规划:从随机动作收集的 S 个种子回合开始,每训练 C 步就向数据集增加一个回合。收集时向动作加入少量高斯探索噪声。与强化学习中的常见做法一致(Mnih 等,2015、2016),每个动作重复 R 次,以缩短规划跨度,并给模型更清楚的学习信号。
算法 1:深度规划网络。输入为动作重复次数 R、种子回合数 S、收集间隔 C、批大小 B、序列片段长度 L、学习率 α,以及转移模型、观察模型、奖励模型、编码器和探索噪声分布 p(ε)。
- 用 S 个随机动作回合初始化数据集 D,随机初始化模型参数 θ。
- 在尚未收敛时,先进行 C 次模型更新:每次从 D 均匀随机抽取 B 个长度为 L 的序列片段,按式(3)计算损失 ℒ(θ),执行 θ ← θ − α∇θℒ(θ)。
- 重置环境,取得 o₁。对 t = 1, …, ⌈T/R⌉,从历史推断当前状态信念 q(sₜ | o≤ₜ, a<ₜ),用附录算法 2 规划动作 aₜ,并加入 ε ∼ p(ε)。
- 执行该动作 R 次,累计这 R 次的奖励,以最后一次观察作为下一步观察。
- 把收集到的整段 (oₜ, aₜ, rₜ) 轨迹加入 D,再继续训练与收集。
译注:式(3)写的是需要最大化的变分下界;算法 1 写为对损失作梯度下降。实现这一执行方向时,损失对应下界的负值。这里保留两处原文各自的记号与方向。
规划算法。我们使用交叉熵方法(CEM;Rubinstein,1997;Chua 等,2018)搜索模型下的最佳动作序列,详见附录算法 2。选择它是因为其稳健性,以及在使用真实动力学时能解决所有考察的任务。CEM 是种群式优化算法,会推断使目标最大的动作序列分布。
我们把最优动作序列的信念初始化为随时间变化的对角高斯分布 aₜ:ₜ₊H ∼ Normal(μₜ:ₜ₊H, σ²ₜ:ₜ₊H I),其中 t 是当前时间,H 为规划跨度。从零均值、单位方差开始,反复采样 J 条候选序列,在模型中评估,然后对最好的 K 条重新拟合分布。经过 I 轮,返回当前时间步的均值 μₜ。收到下一张观察后,动作分布重新从零均值、单位方差开始,以免陷入局部最优。
评估候选动作时,我们从当前状态信念出发采样状态轨迹,累计沿途预测奖励的均值。由于采用种群式优化,我们发现每条动作序列只考察一条状态轨迹已经足够,可以把计算预算用于评估更多不同序列。奖励是潜在状态的函数,因此规划器完全在潜在空间运行,不必生成图像,能快速评估大批动作序列。下一节介绍规划器使用的潜在动力学模型。
3. 循环状态空间模型
每个环境时间步都要评估数千条动作序列,因此我们采用能完全在潜在空间向前预测的循环状态空间模型(RSSM),与近期的一些模型相似(Karl 等,2016;Buesing 等,2018;Doerr 等,2018)。它可视为非线性卡尔曼滤波器或序列 VAE。我们不对既有架构作广泛比较,而强调能指导未来设计的一点:实验表明,转移模型中的随机路径和确定性路径,对成功规划都至关重要。本节先回顾潜在状态空间模型,再介绍我们的模型。
潜在动力学。考虑序列 {(oₜ, aₜ, rₜ)}ₜ₌₁ᵀ。图 2b 的典型潜在状态空间模型具有类似 POMDP 的结构,以隐藏状态序列定义图像和奖励的生成过程:
sₜ ∼ p(sₜ | sₜ₋₁, aₜ₋₁),oₜ ∼ p(oₜ | sₜ),rₜ ∼ p(rₜ | sₜ)。(2)
初始状态 s₀ 固定。转移模型是均值和方差由前馈神经网络参数化的高斯分布;观察模型的均值由反卷积网络参数化,协方差为单位阵;奖励模型是均值由前馈网络参数化、方差为 1 的标量高斯分布。单位方差高斯分布的对数似然,与均方误差只相差常数。
变分编码器。模型非线性,不能直接计算参数学习所需的状态后验。我们用 q(s₁:ᵀ | o₁:ᵀ, a₁:ᵀ) = ∏ₜ₌₁ᵀ q(sₜ | sₜ₋₁, aₜ₋₁, oₜ),从过去的观察和动作推断近似后验。每个因子都是对角高斯分布,均值及方差由卷积网络接前馈网络参数化。我们最终要用模型规划,所以采用只以过去观察为条件的滤波后验;训练时也可以使用完整的平滑后验(Babaeizadeh 等,2017;Gregor 与 Besse,2018)。
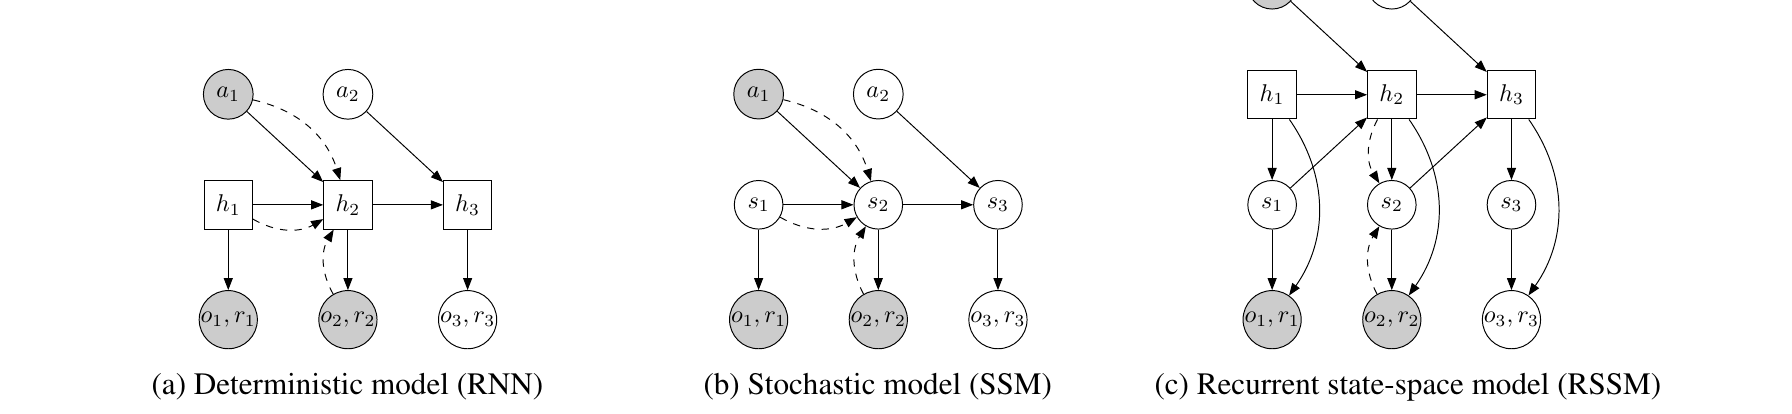
图 2:潜在动力学模型设计。模型观察前两个时间步,再预测第三步。圆形表示随机变量,方形表示确定性变量;实线为生成过程,虚线为推断过程。(a)RNN 的纯确定性转移难以捕捉多种未来,规划器容易利用模型误差。(b)SSM 的纯随机转移难以跨多步记忆信息。(c)RSSM 把状态拆成随机和确定性两部分,让模型能稳健地学习多种未来。
训练目标。通过编码器,我们构造数据对数似然的变分下界。为简洁,只写观察预测损失,奖励损失可类推。由 Jensen 不等式可得:
ln p(o₁:ᵀ | a₁:ᵀ) = ln ∫ ∏ₜ p(sₜ | sₜ₋₁, aₜ₋₁)p(oₜ | sₜ) ds₁:ᵀ ≥ Σₜ₌₁ᵀ {E_q(sₜ|o≤ₜ,a<ₜ)[ln p(oₜ | sₜ)] − E_q(sₜ₋₁|o≤ₜ₋₁,a<ₜ₋₁)[KL(q(sₜ | o≤ₜ, a<ₜ) ∥ p(sₜ | sₜ₋₁, aₜ₋₁))]}。(3)
第一项是重建,第二项是复杂度。推导见附录式(8)。用一个重参数化样本估计外层期望,可以得到高效的推断及学习目标,并用梯度上升优化非线性潜变量模型(Kingma 与 Welling,2013;Rezende 等,2014;Krishnan 等,2017)。
确定性路径。纯随机转移虽然通用,却让模型难以可靠地跨多步记忆。理论上,它可以把某些状态分量的方差学成零,但优化未必找到这个解。因此,我们引入确定性激活向量序列 {hₜ}ₜ₌₁ᵀ,使模型能确定地访问此前的所有状态,而不只上一状态(Chung 等,2015;Buesing 等,2018)。图 2c 的循环状态空间模型定义为:
确定性状态:hₜ = f(hₜ₋₁, sₜ₋₁, aₜ₋₁);随机状态:sₜ ∼ p(sₜ | hₜ);观察:oₜ ∼ p(oₜ | hₜ, sₜ);奖励:rₜ ∼ p(rₜ | hₜ, sₜ)。(4)
f 由 RNN 实现。直观上,状态拆成随机部分 sₜ 和确定性部分 hₜ,两者经 RNN 依赖上一时间步的随机与确定性部分。编码器 q(s₁:ᵀ | o₁:ᵀ, a₁:ᵀ) = ∏ₜ₌₁ᵀ q(sₜ | hₜ, oₜ) 参数化近似后验。所有观察信息都必须经过编码器的采样步骤,以防输入到重建之间出现确定性捷径。下一节指出标准潜在序列目标的一个限制,并提出改善长期预测的推广。
4. 潜在多步预测约束
上一节的标准变分下界包含观察重建项和近似后验的 KL 正则项,如图 3a。它的限制在于,转移函数的随机路径只通过单步预测的 KL 项训练:梯度穿过 p(sₜ | sₜ₋₁, aₜ₋₁) 直接进入 q(sₜ₋₁),却不会穿过连续多个转移函数。本节将下界推广为 latent overshooting,在潜在空间训练全部多步预测。若干模型能从中获益,但最终使用 RSSM 的智能体并不需要它,见附录 D。
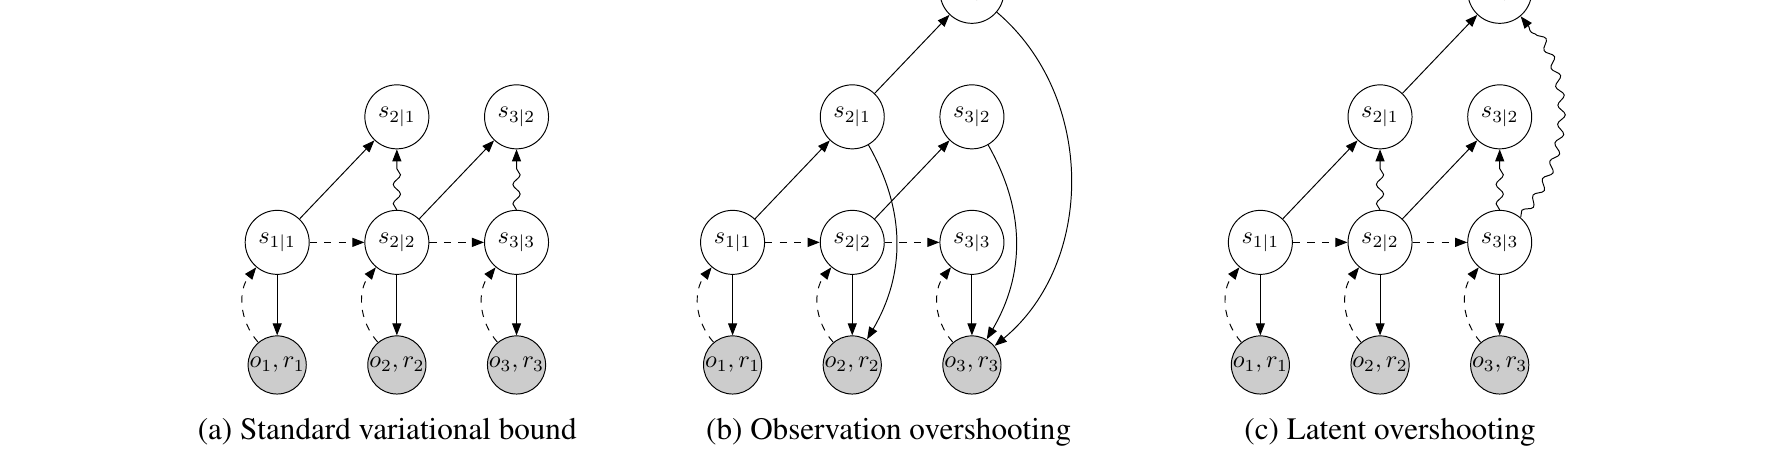
图 3:展开方式。sᵢ|ⱼ 表示以截至时间 j 的观察为条件的时间 i 状态;指向阴影圆的箭头为对数似然损失,波浪箭头为 KL 损失。(a)标准变分目标逐步解码后验计算重建,并逐步约束先验与后验,只训练单步转移。(b)观察空间 overshooting 解码所有多步预测并加入重建损失,图像领域通常代价过高。(c)潜在 overshooting 预测各跨度的先验,在潜在空间使其接近对应后验,以鼓励准确的多步预测。
有限容量。如果单步预测完美,多步预测也会完美。但模型容量有限、分布族受限时,仅把单步预测训练到收敛,通常不会得到多步预测最佳的模型。规划需要准确多步预测,因此我们受到 Amos 等(2018)及较早相关思想的启发(Krishnan 等,2015;Lamb 等,2016;Chiappa 等,2017),训练所有距离的多步预测。我们把这个思想推广到潜在序列模型,表明无需生成额外图像,潜在空间损失就能改善多步预测。
多步预测。先把式(3)从单步推广到固定距离 d。为简化记号,以下省略动作条件;所有关于 sₜ 的分布仍以 a<ₜ 为条件。反复应用转移模型并积分消去中间状态,得到:
p(sₜ | sₜ₋d) ≔ ∫ [∏ᵗ_τ₌ₜ₋d₊₁ p(sτ | sτ₋₁)] dsₜ₋d₊₁:ₜ₋₁ = E_p(sₜ₋₁|sₜ₋d)[p(sₜ | sₜ₋₁)]。(5)
d = 1 恢复原模型的单步转移。由此,多步预测分布 p_d 的变分下界为:
ln p_d(o₁:ᵀ) ≔ ln ∫ ∏ₜ₌₁ᵀ p(sₜ | sₜ₋d)p(oₜ | sₜ) ds₁:ᵀ ≥ Σₜ₌₁ᵀ {E_q(sₜ|o≤ₜ)[ln p(oₜ | sₜ)] − E_p(sₜ₋₁|sₜ₋d)q(sₜ₋d|o≤ₜ₋d)[KL(q(sₜ | o≤ₜ) ∥ p(sₜ | sₜ₋₁))]}。(6)
两项分别为重建与多步预测,推导见附录式(9)。最大化该目标会训练多步预测分布,符合规划时不能访问此前所有观察的情况。基于数据处理不等式,我们猜想式(6)也是 ln p(o₁:ᵀ) 的下界:潜在状态序列是马尔可夫的,对于 d ≥ 1,有 I(sₜ; sₜ₋d) ≤ I(sₜ; sₜ₋₁),从而 E[ln p_d(o₁:ᵀ)] ≤ E[ln p(o₁:ᵀ)]。因此,在对数据集取期望的意义下,多步预测分布的任一下界,也是单步预测分布的下界。详见附录式(10)。接下来解决每个 p_d 只训练一个距离的问题。
潜在 overshooting。规划需要从 1 到规划跨度的各个距离都预测准确。我们把标准变分下界推广到所有 1 ≤ d ≤ D 的多步预测:
(1/D)Σ_d₌₁ᴰ ln p_d(o₁:ᵀ) ≥ Σₜ₌₁ᵀ {E_q(sₜ|o≤ₜ)[ln p(oₜ | sₜ)] − (1/D)Σ_d₌₁ᴰ β_d E_p(sₜ₋₁|sₜ₋d)q(sₜ₋d|o≤ₜ₋d)[KL(q(sₜ | o≤ₜ) ∥ p(sₜ | sₜ₋₁))]}。(7)
它可理解为潜在空间正则项,鼓励单步与多步预测一致;在数据集期望意义上,两者应当等价。与 β-VAE(Higgins 等,2016)类似,我们引入权重 {β_d}。为简洁,所有 d > 1 的权重设为同一个值,也可以选择权重让模型更重视长期或短期。实际训练时,对 d > 1 的后验停止梯度,让多步预测接近包含观察信息的后验,而不反过来。
5. 实验
我们在六个从像素进行连续控制的任务上评估 PlaNet,考察动力学模型的随机及确定性路径、迭代规划、在线经验收集。超参数见附录 A,补充实验见附录 C–E。除了动作重复次数,各任务采用相同超参数。使用不足百分之一的回合,PlaNet 就超过 A3C(Mnih 等,2016),并达到接近强大无模型算法 D4PG(Barth-Maron 等,2018)的表现。在单张 Nvidia V100 GPU 上,训练依任务需要 10–20 小时,与 A3C 和 D4PG 相比具有优势。实现采用 TensorFlow Probability(Dillon 等,2017);代码及训练后智能体视频见作者项目页。
六项 DeepMind Control Suite 任务各有不同挑战:倒立摆摆起需要较长规划及记住视野外的小车;触达仅在手与目标区域重叠时奖励;手指旋转有接触动力学;猎豹的状态及动作空间更大;杯子接球仅接住球时奖励;行走机器人先站起再行走,与地面的碰撞难以预测。全部任务只观察第三人称相机的 64 × 64 × 3 图像。
与无模型方法比较。图 4 对比 Tassa 等(2018)报告的算法。100 个回合内,PlaNet 在所有任务上超过从本体状态训练 100,000 回合的 A3C。500 回合后,除手指任务外,表现接近从图像训练 100,000 回合的 D4PG。猎豹奔跑的最终表现较 D4PG 相对提高 26%。数值见表 1,其中也列出用模拟器真实动力学进行 CEM 规划的结果。
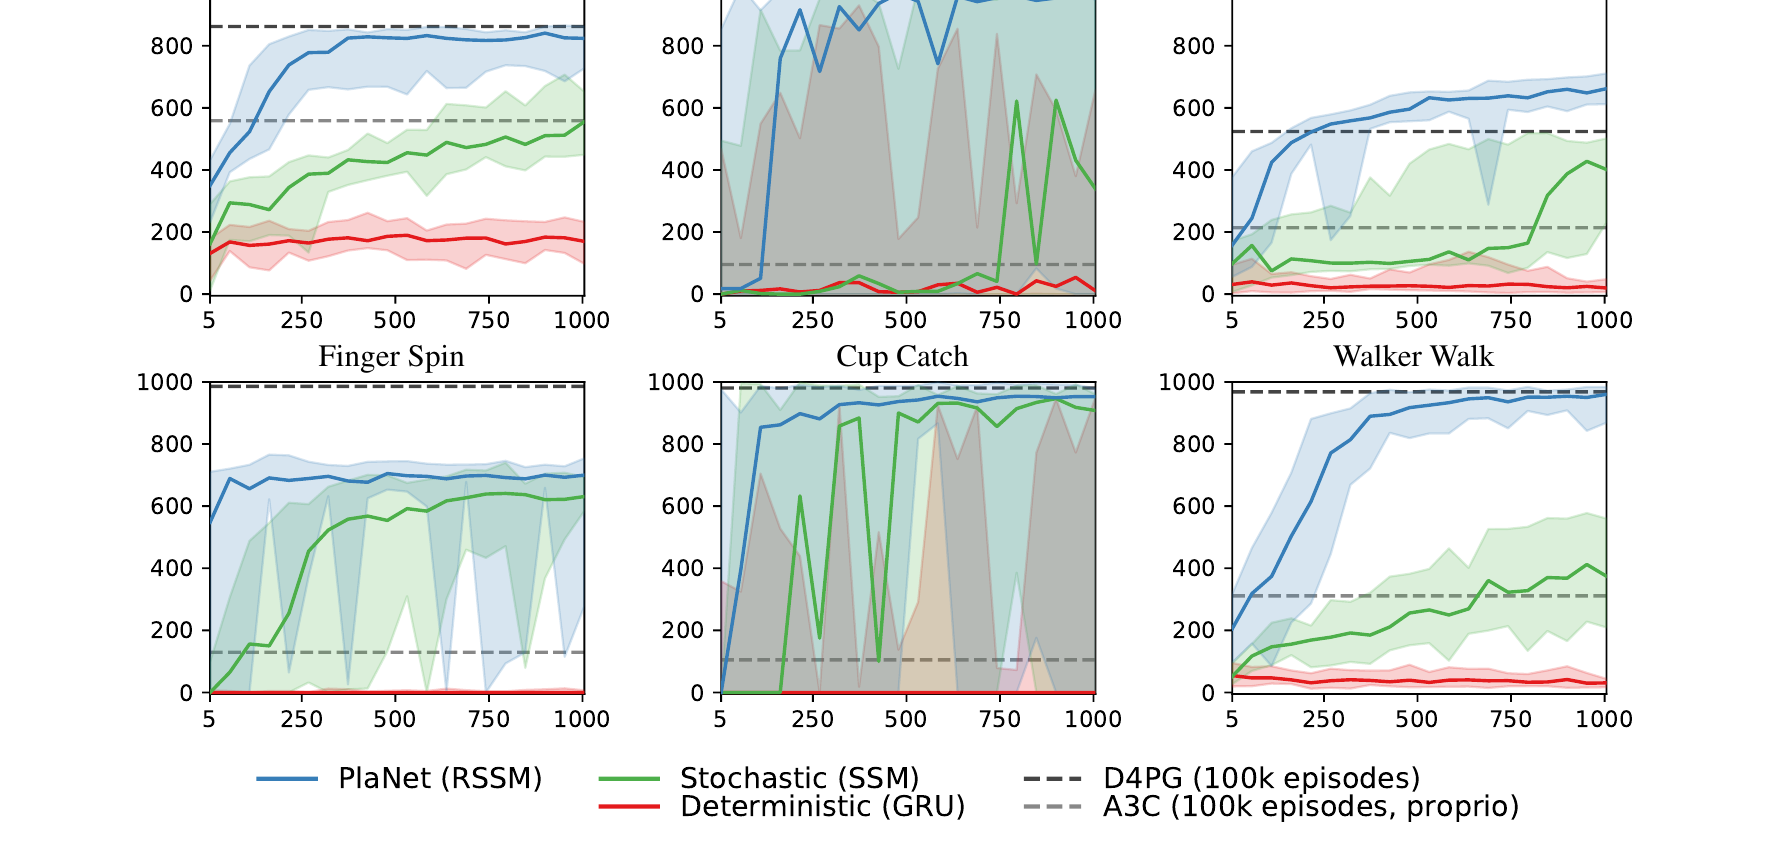
图 4:PlaNet、无模型算法及不同模型设计的比较。横轴是收集的回合数;比较 RSSM、纯确定性 GRU 和纯随机 SSM。RNN 没有随机潜变量,因此不用 latent overshooting。线为中位数,阴影为 5 个随机种子、10 条轨迹下的第 5–95 百分位;两个任务因奖励稀疏而阴影较大。
| 方法 | 输入 | 回合 | 倒立摆摆起 | 触达 | 猎豹奔跑 | 手指旋转 | 杯子接球 | 机器人行走 |
|---|---|---|---|---|---|---|---|---|
| A3C | 本体感觉 | 100,000 | 558 | 285 | 214 | 129 | 105 | 311 |
| D4PG | 像素 | 100,000 | 862 | 967 | 524 | 985 | 980 | 968 |
| PlaNet | 像素 | 1,000 | 821 | 832 | 662 | 700 | 930 | 951 |
| CEM + 真实模拟器 | 模拟器状态 | 0 | 850 | 964 | 656 | 825 | 993 | 994 |
| PlaNet 相对 D4PG 的数据效率倍数 | — | — | 250 | 40 | 500+ | 300 | 100 | 90 |
模型设计。图 4 也对比 RSSM、纯确定性 GRU(Cho 等,2014)和纯随机 SSM。所有任务都显示两类转移组件的重要性:确定性部分跨多步记忆,随机性部分更重要,缺少它时智能体无法学会任务。可能原因是初始状态部分可观测,从智能体视角看任务具有随机性;噪声也可能给规划目标加入安全余量,让动作序列更稳健。
智能体设计。图 5 比较 PlaNet、随机动作收集数据的版本,以及每步从 1,000 条序列直接选择最优、却不用 CEM 迭代改进的版本。在线收集对所有任务都有帮助,在倒立摆、手指和行走任务中更是必要。CEM 迭代搜索对所有任务都有改善。
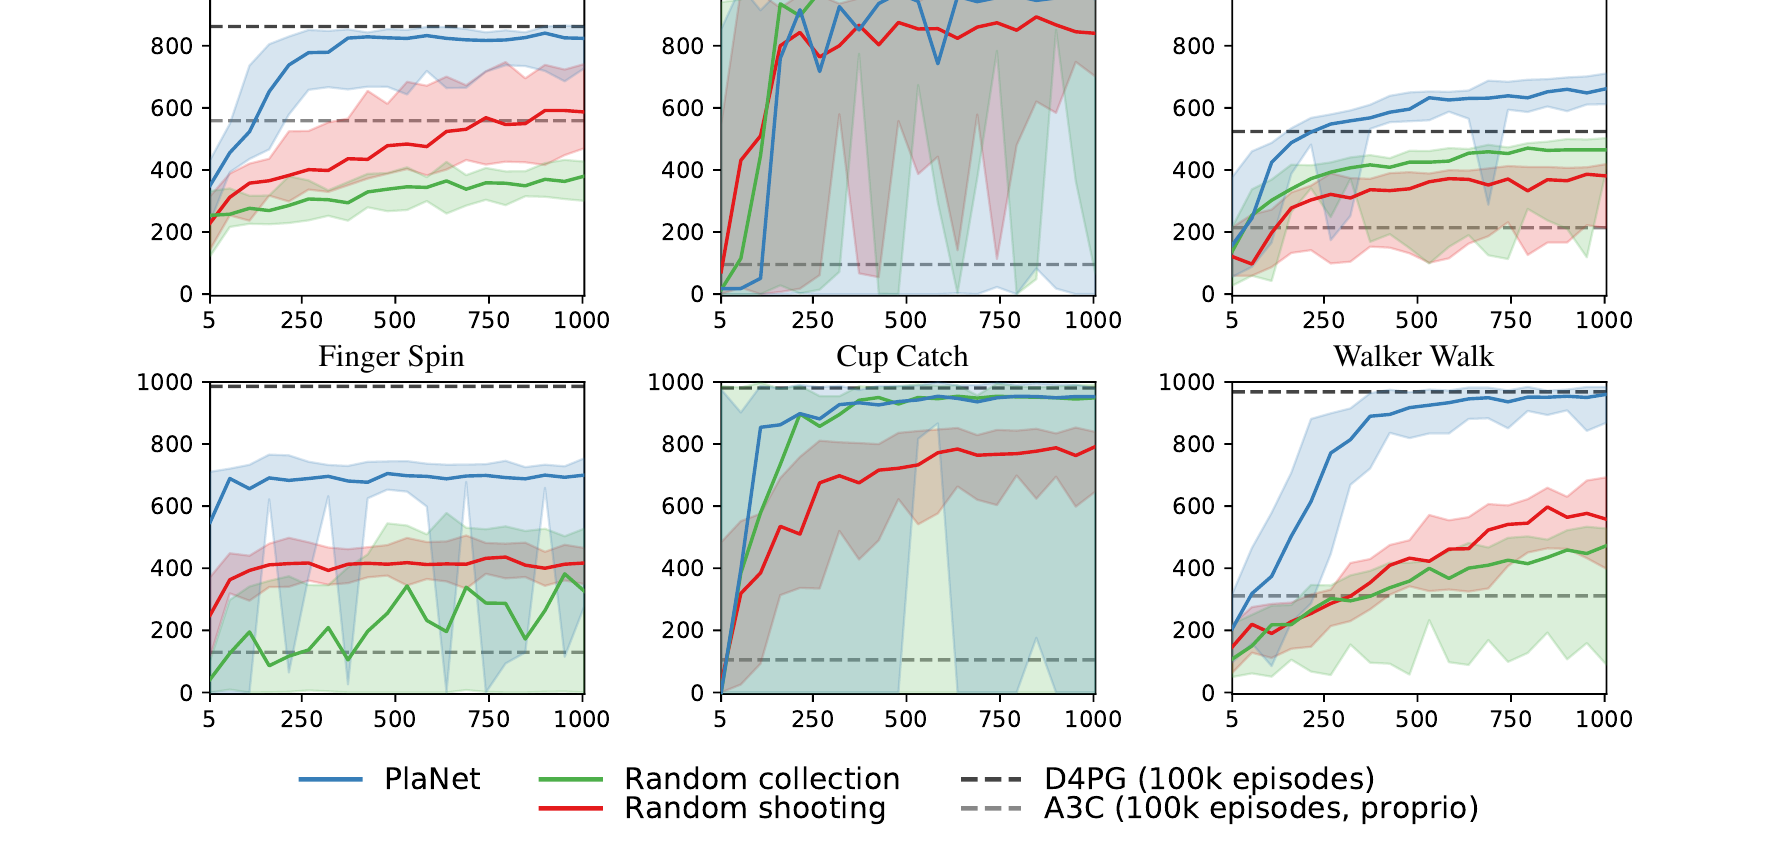
图 5:智能体设计比较。random collection 用随机动作收集数据;random shooting 每步从 1,000 条序列选择最好动作,不用 CEM 迭代细化。曲线为测试表现随回合数变化,线为中位数,阴影为 5 个种子、10 条轨迹的第 5–95 百分位。
一个智能体完成所有任务。附录图 7 展示同时训练六项任务的单个智能体。我们不告知任务身份,它必须从图像推断。动作空间补上不使用的分量,使各任务兼容;算法 1 改为每 C 次更新从每项任务收集一个回合,其他超参数与主实验相同。它能解决全部任务,只是比单独训练学习更慢。这说明即使视觉概念不同,模型也能学习多个领域的预测。
7. 讨论与致谢
PlaNet 从图像学习潜在动力学模型,通过潜在空间的快速规划选择动作。为准确长期预测,模型具有随机和确定性路径。它在多项图像连续控制任务上达到与当时最佳无模型算法相当的表现,回合数减少约 200 倍,计算时间相近或更少。结果表明,为图像领域规划学习潜在动力学,是一个有前景的方向。
未来可学习时间抽象来替代固定动作重复,例如使用分层模型。学习价值函数以估计规划跨度之后的奖励总和,可能提高最终表现。基于梯度的规划可能提升计算效率;无需重建的表征学习可能帮助处理视觉变化更多的任务。共享动力学模型也为多任务控制提供了起点。
致谢。感谢 Jacob Buckman、Nicolas Heess、John Schulman、Rishabh Agarwal、Silviu Pitis、Mohammad Norouzi、George Tucker、David Duvenaud、Shane Gu、Chelsea Finn、Steven Bohez、Jimmy Ba、Stephanie Chan、Jenny Liu 的有益讨论。
附录 A. 超参数
我们使用 Ha 与 Schmidhuber(2018)的卷积及反卷积网络,动力学中的确定性路径采用 200 单元 GRU(Cho 等,2014);其余函数采用两层全连接网络,每层 200 单元,激活为 ReLU(Nair 与 Hinton,2010)。潜在空间分布为 30 维对角高斯,预测均值与标准差。
图像预处理按 Kingma 与 Dhariwal(2018)将位深降到 5 位。使用 Adam(Kingma 与 Ba,2014),学习率 10⁻³,ε = 10⁻⁴,梯度范数裁剪上限 1,000;每批 B = 50 个长度 L = 50 的片段。我们不对 KL 项与重建项另作相对缩放,但把散度损失在 3 以下截断,给予 3 个 free nats。较早版本使用过 latent overshooting 和额外固定全局先验,后来发现并不需要。
CEM 的跨度 H = 12、迭代 I = 10、每轮候选 J = 1,000,对最优 K = 100 重拟合。初始 S = 5 个随机回合,每 C = 100 次更新再收集一回合,动作噪声 ε ∼ Normal(0, 0.3)。动作重复分别为倒立摆 8、触达 4、猎豹 4、手指 2、杯子 4、行走 2。重要超参数包括动作重复、KL 权重 β 和学习率。
附录 B. CEM 规划算法
算法 2 的输入为规划距离 H、优化轮数 I、每轮候选数 J、用于拟合的最佳候选数 K、当前状态信念 q(sₜ | o≤ₜ, a<ₜ)、转移模型与奖励模型。
- 初始化因子化动作序列信念 q(aₜ:ₜ₊H) ← Normal(0, I)。这里 I 在协方差位置表示单位阵。
- 对每轮 i = 1, …, I,从当前 q 采样 J 条候选动作序列 a⁽ʲ⁾ₜ:ₜ₊H。
- 每条候选从当前信念采样 s⁽ʲ⁾ₜ,再按 ∏_τ₌ₜ₊₁ᵗ⁺ᴴ⁺¹ p(sτ | sτ₋₁, a⁽ʲ⁾τ₋₁) 采样状态轨迹;计算 R⁽ʲ⁾ = Σ_τ₌ₜ₊₁ᵗ⁺ᴴ⁺¹ E[p(rτ | s⁽ʲ⁾τ)]。
- 按回报排序,选出最好的 K 条序列,索引集合记为 𝒦。计算 μₜ:ₜ₊H = (1/K)Σ_k∈𝒦 a⁽ᵏ⁾ₜ:ₜ₊H,以及 σₜ:ₜ₊H = [1/(K−1)]Σ_k∈𝒦 |a⁽ᵏ⁾ₜ:ₜ₊H − μₜ:ₜ₊H|。
- 更新 q(aₜ:ₜ₊H) ← Normal(μₜ:ₜ₊H, σ²ₜ:ₜ₊H I),继续下一轮。
- 返回当前时间步第一个动作的均值 μₜ。
译注:算法 2 的 σ 公式在正式 PDF 中确实使用绝对偏差求和,未写平方及平方根。本文按原式保留;它与通常的样本标准差公式不同,不据此推定代码实现。动作和状态范围的 H、H+1 也沿用原算法记号。
附录 C. 多任务学习
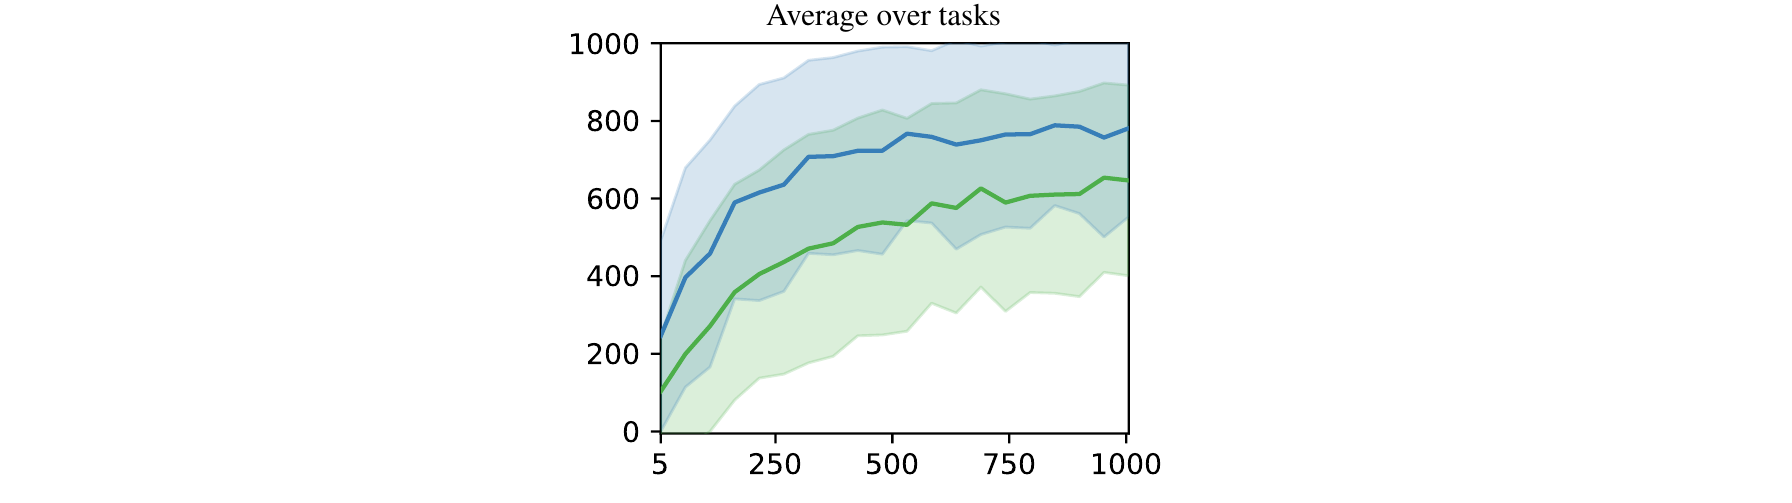
图 6:单个 PlaNet 同时学习全部任务,与各任务单独智能体的比较。横轴为每项任务收集的回合数。单个智能体学会全部任务,但学习更慢。线和阴影分别为 6 项任务、5 个种子、10 条轨迹的均值及一个标准差。
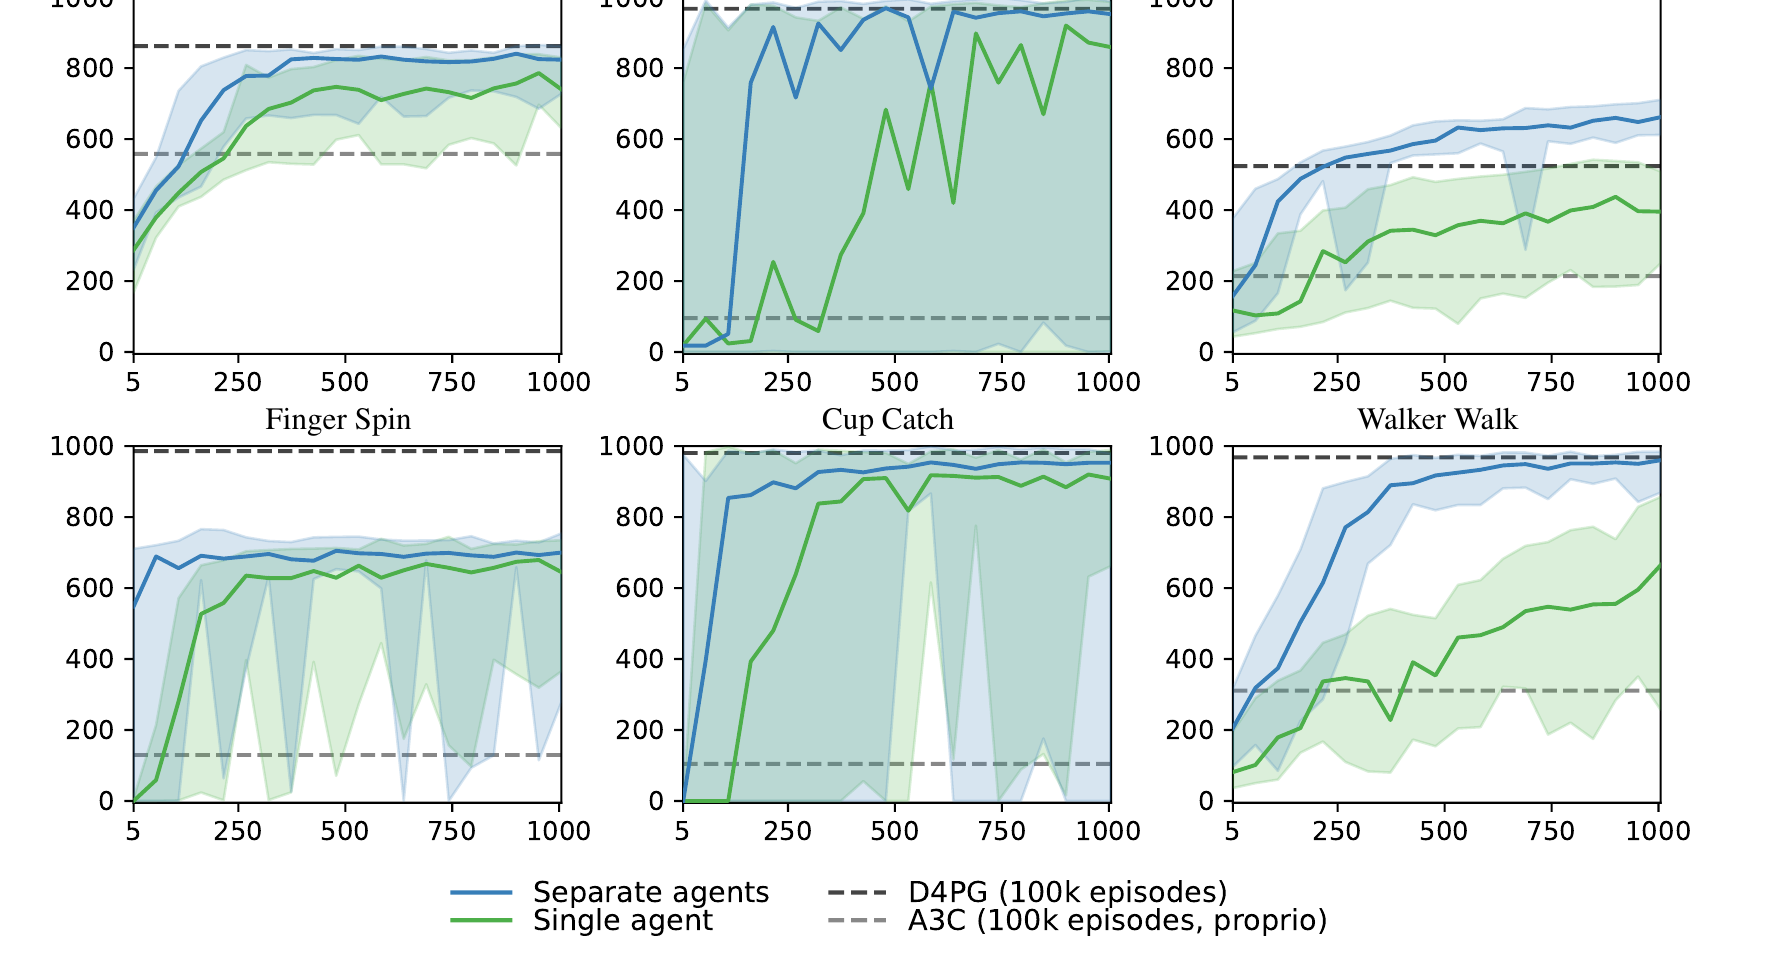
图 7:单个智能体学习六项任务时的逐任务表现。它未被告知任务身份,需从图像辨别任务;能够完成任务,学习速度适度降低。线为中位数,阴影为 4 个种子、10 条轨迹的第 5–95 百分位。
附录 D. 潜在多步预测约束
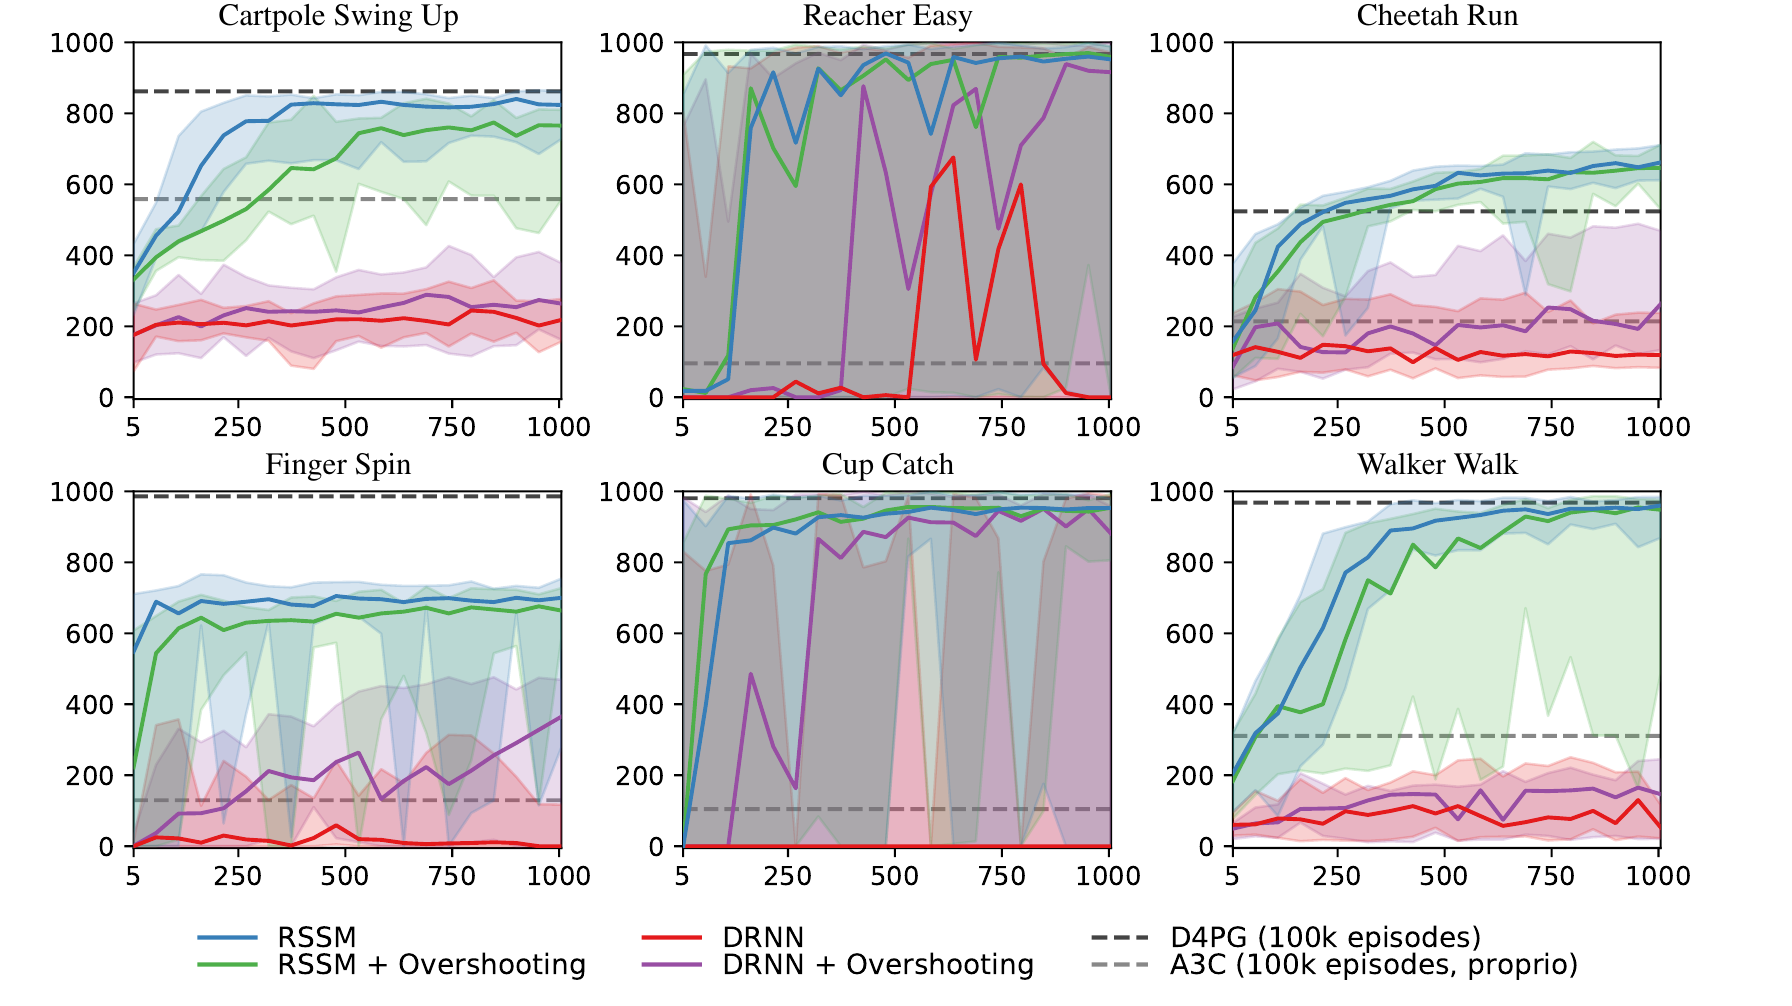
图 8:比较 RSSM 及另一种 DRNN 在标准变分目标与 latent overshooting 下的表现。DRNN 的编码器和解码器为两个 RNN,中间有随机状态序列。Overshooting 显著改善 DRNN 及其他试验过的模型(未展示),但略微降低 RSSM 表现。线为中位数,阴影为 5 个种子、10 条轨迹的第 5–95 百分位。
附录 E. 激活函数
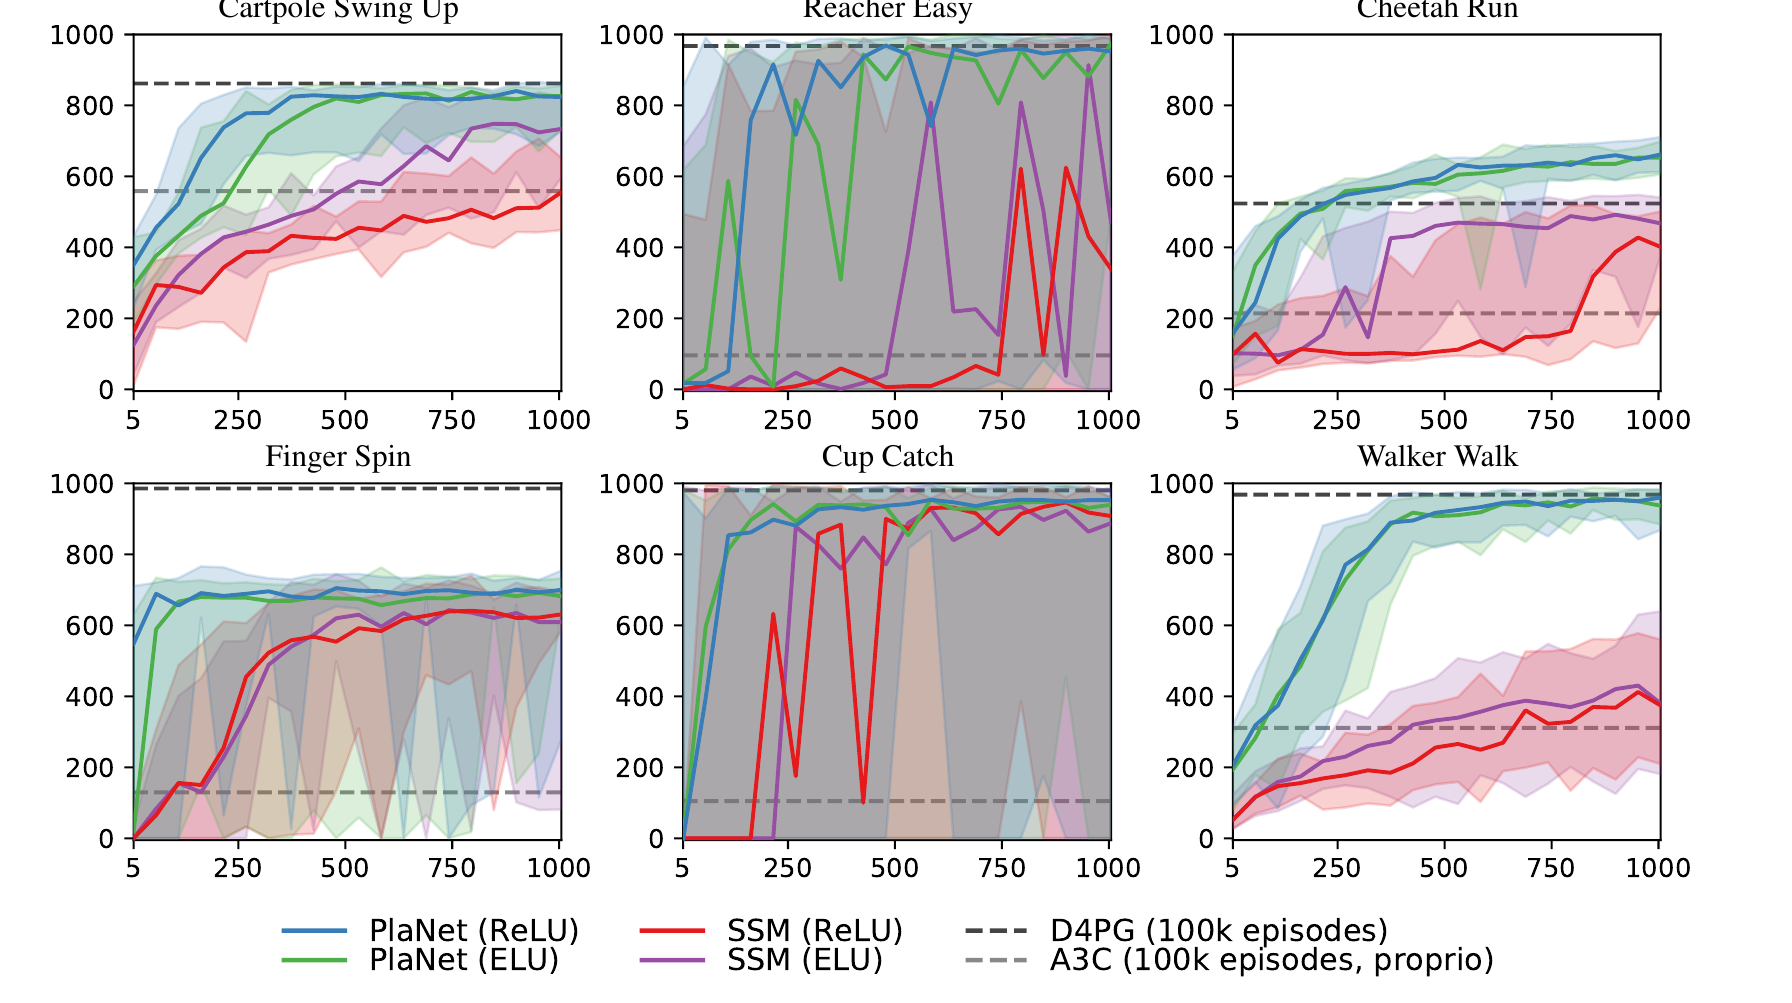
图 9:比较硬 ReLU(Nair 与 Hinton,2010)和光滑 ELU(Clevert 等,2015)。光滑激活有助于纯随机模型及纯确定性模型(后者未展示);RSSM 对激活函数选择较稳健。线为中位数,阴影为 5 个种子、10 条轨迹的第 5–95 百分位。
附录 F. 下界推导
单步预测分布。潜在动力学模型 p(o₁:ᵀ, s₁:ᵀ | a₁:ᵀ) = ∏ₜ p(sₜ | sₜ₋₁, aₜ₋₁)p(oₜ | sₜ),变分后验 q(s₁:ᵀ | o₁:ᵀ, a₁:ᵀ) = ∏ₜ q(sₜ | o≤ₜ, a<ₜ)。通过重要性加权与 Jensen 不等式可得:
ln p(o₁:ᵀ | a₁:ᵀ) ≔ ln E_p(s₁:ᵀ|a₁:ᵀ)[∏ₜ₌₁ᵀ p(oₜ | sₜ)] = ln E_q(s₁:ᵀ|o₁:ᵀ,a₁:ᵀ)[∏ₜ₌₁ᵀ p(oₜ | sₜ)p(sₜ | sₜ₋₁, aₜ₋₁)/q(sₜ | o≤ₜ, a<ₜ)]。
≥ E_q[Σₜ₌₁ᵀ {ln p(oₜ | sₜ) + ln p(sₜ | sₜ₋₁, aₜ₋₁) − ln q(sₜ | o≤ₜ, a<ₜ)}] = Σₜ₌₁ᵀ {E_q(sₜ|o≤ₜ,a<ₜ)[ln p(oₜ | sₜ)] − E_q(sₜ₋₁|o≤ₜ₋₁,a<ₜ₋₁)[KL(q(sₜ | o≤ₜ, a<ₜ) ∥ p(sₜ | sₜ₋₁, aₜ₋₁))]}。(8)
多步预测分布。对 d 步预测分布及同一变分后验,可以类似推导。第二次取下界来自把对数移入多步先验内,其递归关系为 p(sₜ | sₜ₋d, aₜ₋d₋₁:ₜ₋₁) = E_p(sₜ₋₁|sₜ₋d,aₜ₋d₋₁:ₜ₋₂)[p(sₜ | sₜ₋₁, aₜ₋₁)]。
ln p_d(o₁:ᵀ | a₁:ᵀ) ≔ ln E_p_d(s₁:ᵀ|a₁:ᵀ)[∏ₜ₌₁ᵀ p(oₜ | sₜ)] = ln E_q[∏ₜ₌₁ᵀ p(oₜ | sₜ)p(sₜ | sₜ₋d, aₜ₋d₋₁:ₜ₋₁)/q(sₜ | o≤ₜ, a<ₜ)]。
≥ E_q[Σₜ₌₁ᵀ {ln p(oₜ | sₜ) + ln p(sₜ | sₜ₋d, aₜ₋d₋₁:ₜ₋₁) − ln q(sₜ | o≤ₜ, a<ₜ)}] ≥ E_q[Σₜ₌₁ᵀ {ln p(oₜ | sₜ) + E_p(sₜ₋₁|sₜ₋d,aₜ₋d₋₁:ₜ₋₂)[ln p(sₜ | sₜ₋₁, aₜ₋₁)] − ln q(sₜ | o≤ₜ, a<ₜ)}]。
= Σₜ₌₁ᵀ {E_q(sₜ|o≤ₜ,a<ₜ)[ln p(oₜ | sₜ)] − E_p(sₜ₋₁|sₜ₋d,aₜ₋d₋₁:ₜ₋₂)q(sₜ₋d|o≤ₜ₋d,a<ₜ₋d)[KL(q(sₜ | o≤ₜ, a<ₜ) ∥ p(sₜ | sₜ₋₁, aₜ₋₁))]}。(9)
所有期望均在目标外层,因此把期望替换为样本平均,就容易得到下界的无偏估计。
单步与多步预测分布的关系。我们猜想,对数据集取期望时,同一潜在序列模型的多步预测分布 p_d(o₁:ᵀ) 下界于单步分布 p(o₁:ᵀ)。潜在状态序列为马尔可夫过程,对于 d ≥ 1,数据处理不等式给出:
I(sₜ; sₜ₋d) ≤ I(sₜ; sₜ₋₁);H(sₜ) − H(sₜ | sₜ₋d) ≤ H(sₜ) − H(sₜ | sₜ₋₁);E[ln p(sₜ | sₜ₋d)] ≤ E[ln p(sₜ | sₜ₋₁)];E[ln p_d(o₁:ᵀ)] ≤ E[ln p(o₁:ᵀ)]。(10)
所以多步预测分布的任何下界,包括式(9)和式(7),也构成单步预测分布的下界。
译注:这段关系在原文中以 conjecture(猜想)引入,以上保留作者论述,不将它另写成适用于任意学习模型的已证定理。原文式(9)动作条件的起始索引也按正式版保留。
附录 G. 更多相关工作
状态空间规划。环境提供低维状态时,智能体可直接在状态空间学习动力学。对于倒立摆、山地车等状态变量很少的控制任务,PILCO(Deisenroth 与 Rasmussen,2011)以高斯过程建模,取得出色数据效率。采用神经网络动力学的相近方法能够解决双连杆平衡(Gal 等,2016;Higuera 等,2018)和基于梯度的规划(Henaff 等,2018)。Chua 等(2018)用神经网络集成扩展到猎豹奔跑。其限制是访问系统低维马尔可夫状态,有时还要访问奖励函数。Amos 等(2018)在观察空间用 overshooting 训练确定性模型,驱动机器人手主动探索。我们超越低维状态,用潜在动力学从图像完成控制。
混合智能体。基于模型强化学习的困难推动了混合方法:用想象经验加速策略学习(Kalweit 与 Boedecker,2017;Nagabandi 等,2017;Kurutach 等,2018;Buckman 等,2018;Ha 与 Schmidhuber,2018),改善特征表征(Wayne 等,2018;Igl 等,2018),或直接利用模型包含的信息(Weber 等,2017)。Srinivas 等(2018)通过强化学习、无需预测损失,学习内部含规划计算的策略网络,但训练需要专家示范。
多步预测。用多步预测训练序列模型已经研究多年。Scheduled sampling(Bengio 等,2015)在训练期间改变模型展开距离;hallucinated replay(Talvitie,2014)把预测混进数据,间接训练多步预测;Venkatraman 等(2015)采用模仿学习。近期 Amos 等(2018)同时训练所有多步预测。我们把这一思想推广到通过变分推断训练的潜在序列模型。
潜在序列模型。经典工作研究了非马尔可夫观察序列,包括确定性隐藏状态 RNN 和概率状态空间模型。VAE 的思想(Kingma 与 Welling,2013;Rezende 等,2014)使通过变分推断训练非线性 SSM 成为可能(Krishnan 等,2015)。VRNN(Chung 等,2015)结合 RNN 与 SSM,但与 RSSM 不同,它将生成观察反馈进模型,使向前预测昂贵。Karl 等(2016)通过限制转移函数解决未来坍缩为一种的问题;Moerland 等(2017)研究多模态转移;Doerr 等(2018)稳定纯随机模型训练。Buesing 等(2018)提出类似模型,用于混合智能体,而非显式规划。
视频预测。这是深度学习的活跃方向。Oh 等(2015)与 Chiappa 等(2017)以确定性模型在 Atari 上得到视觉合理的预测。Kalchbrenner 等(2016)采用门控 CNN 与 LSTM 构造自回归视频预测。较新方法引入随机性以捕捉多种未来(Babaeizadeh 等,2017;Denton 与 Fergus,2018);Mathieu 等(2015)与 Vondrick 等(2016)用对抗损失提高真实感。Gemici 等(2017)在模拟环境用外部记忆保存长期上下文。van den Oord 等(2017)用最近邻查找替代采样,得到高保真图像预测。这些模型与我们的方法相互补充。
附录 H. 视频预测
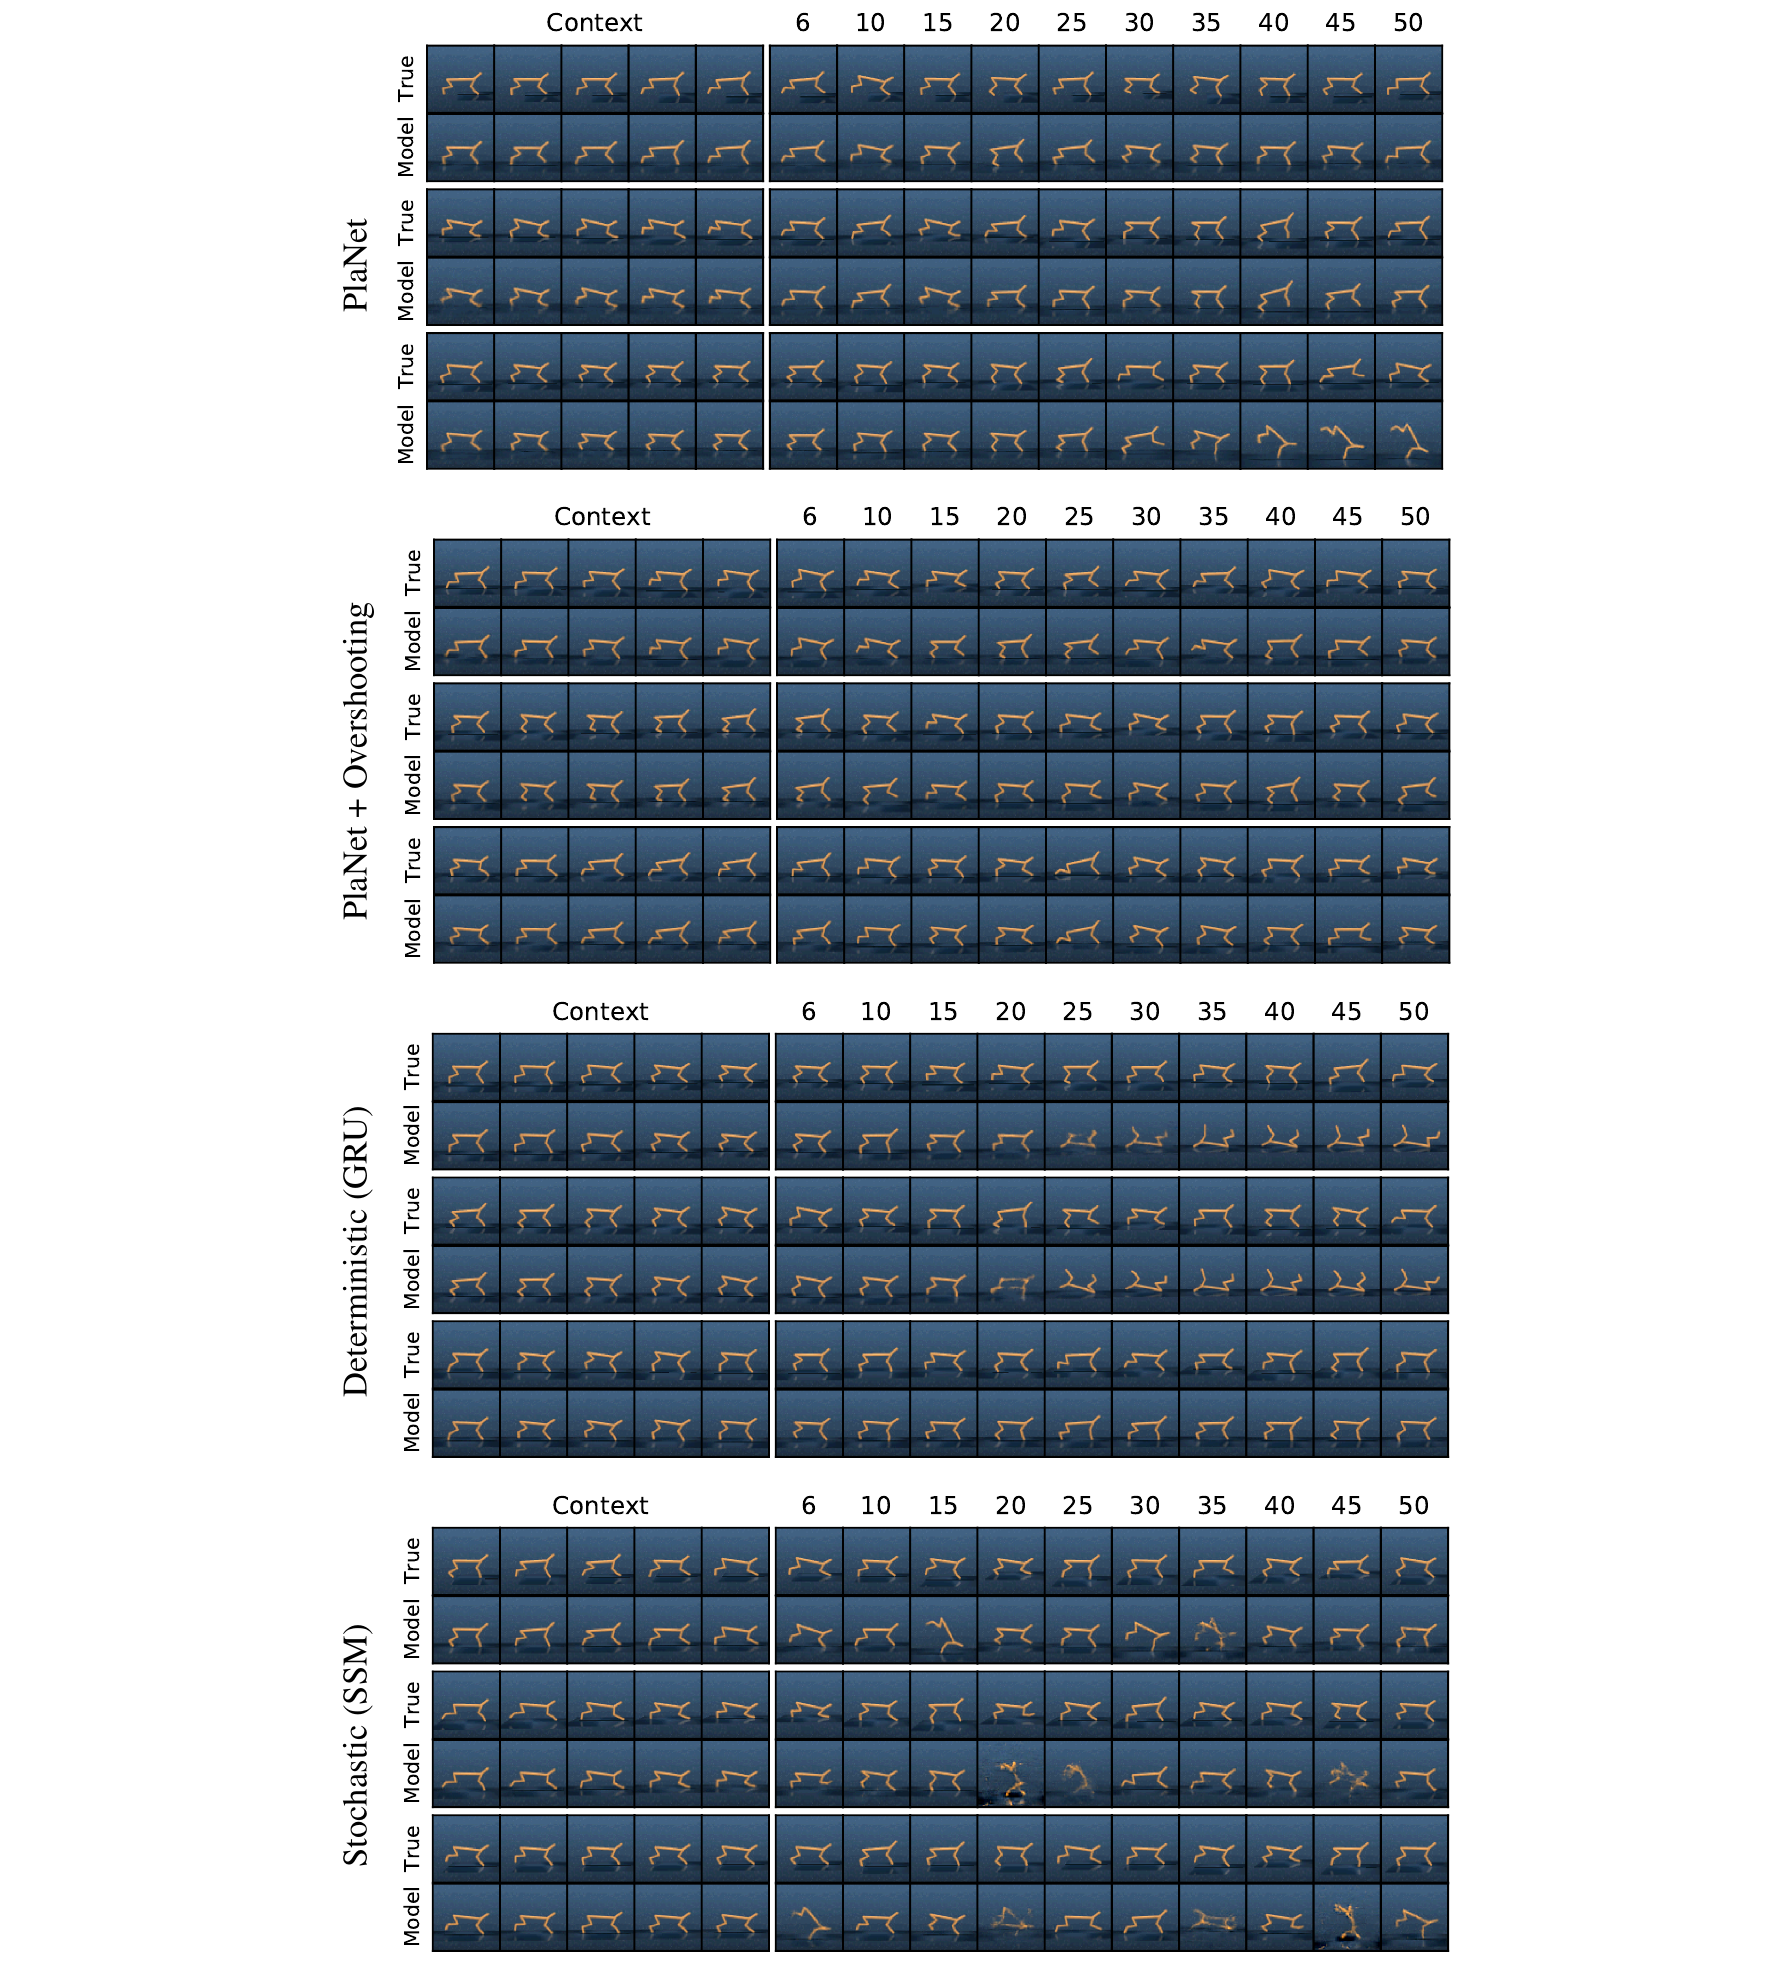
图 10:测试回合的开环视频预测。第 1–5 列为重建的上下文帧,后续图像为不再接收新观察的开环生成。RSSM 在猎豹环境能预测未来 50 步,并达到像素级准确。动作序列随机选自与训练回合一同收集、带动作噪声的测试回合。
附录 I. 状态诊断
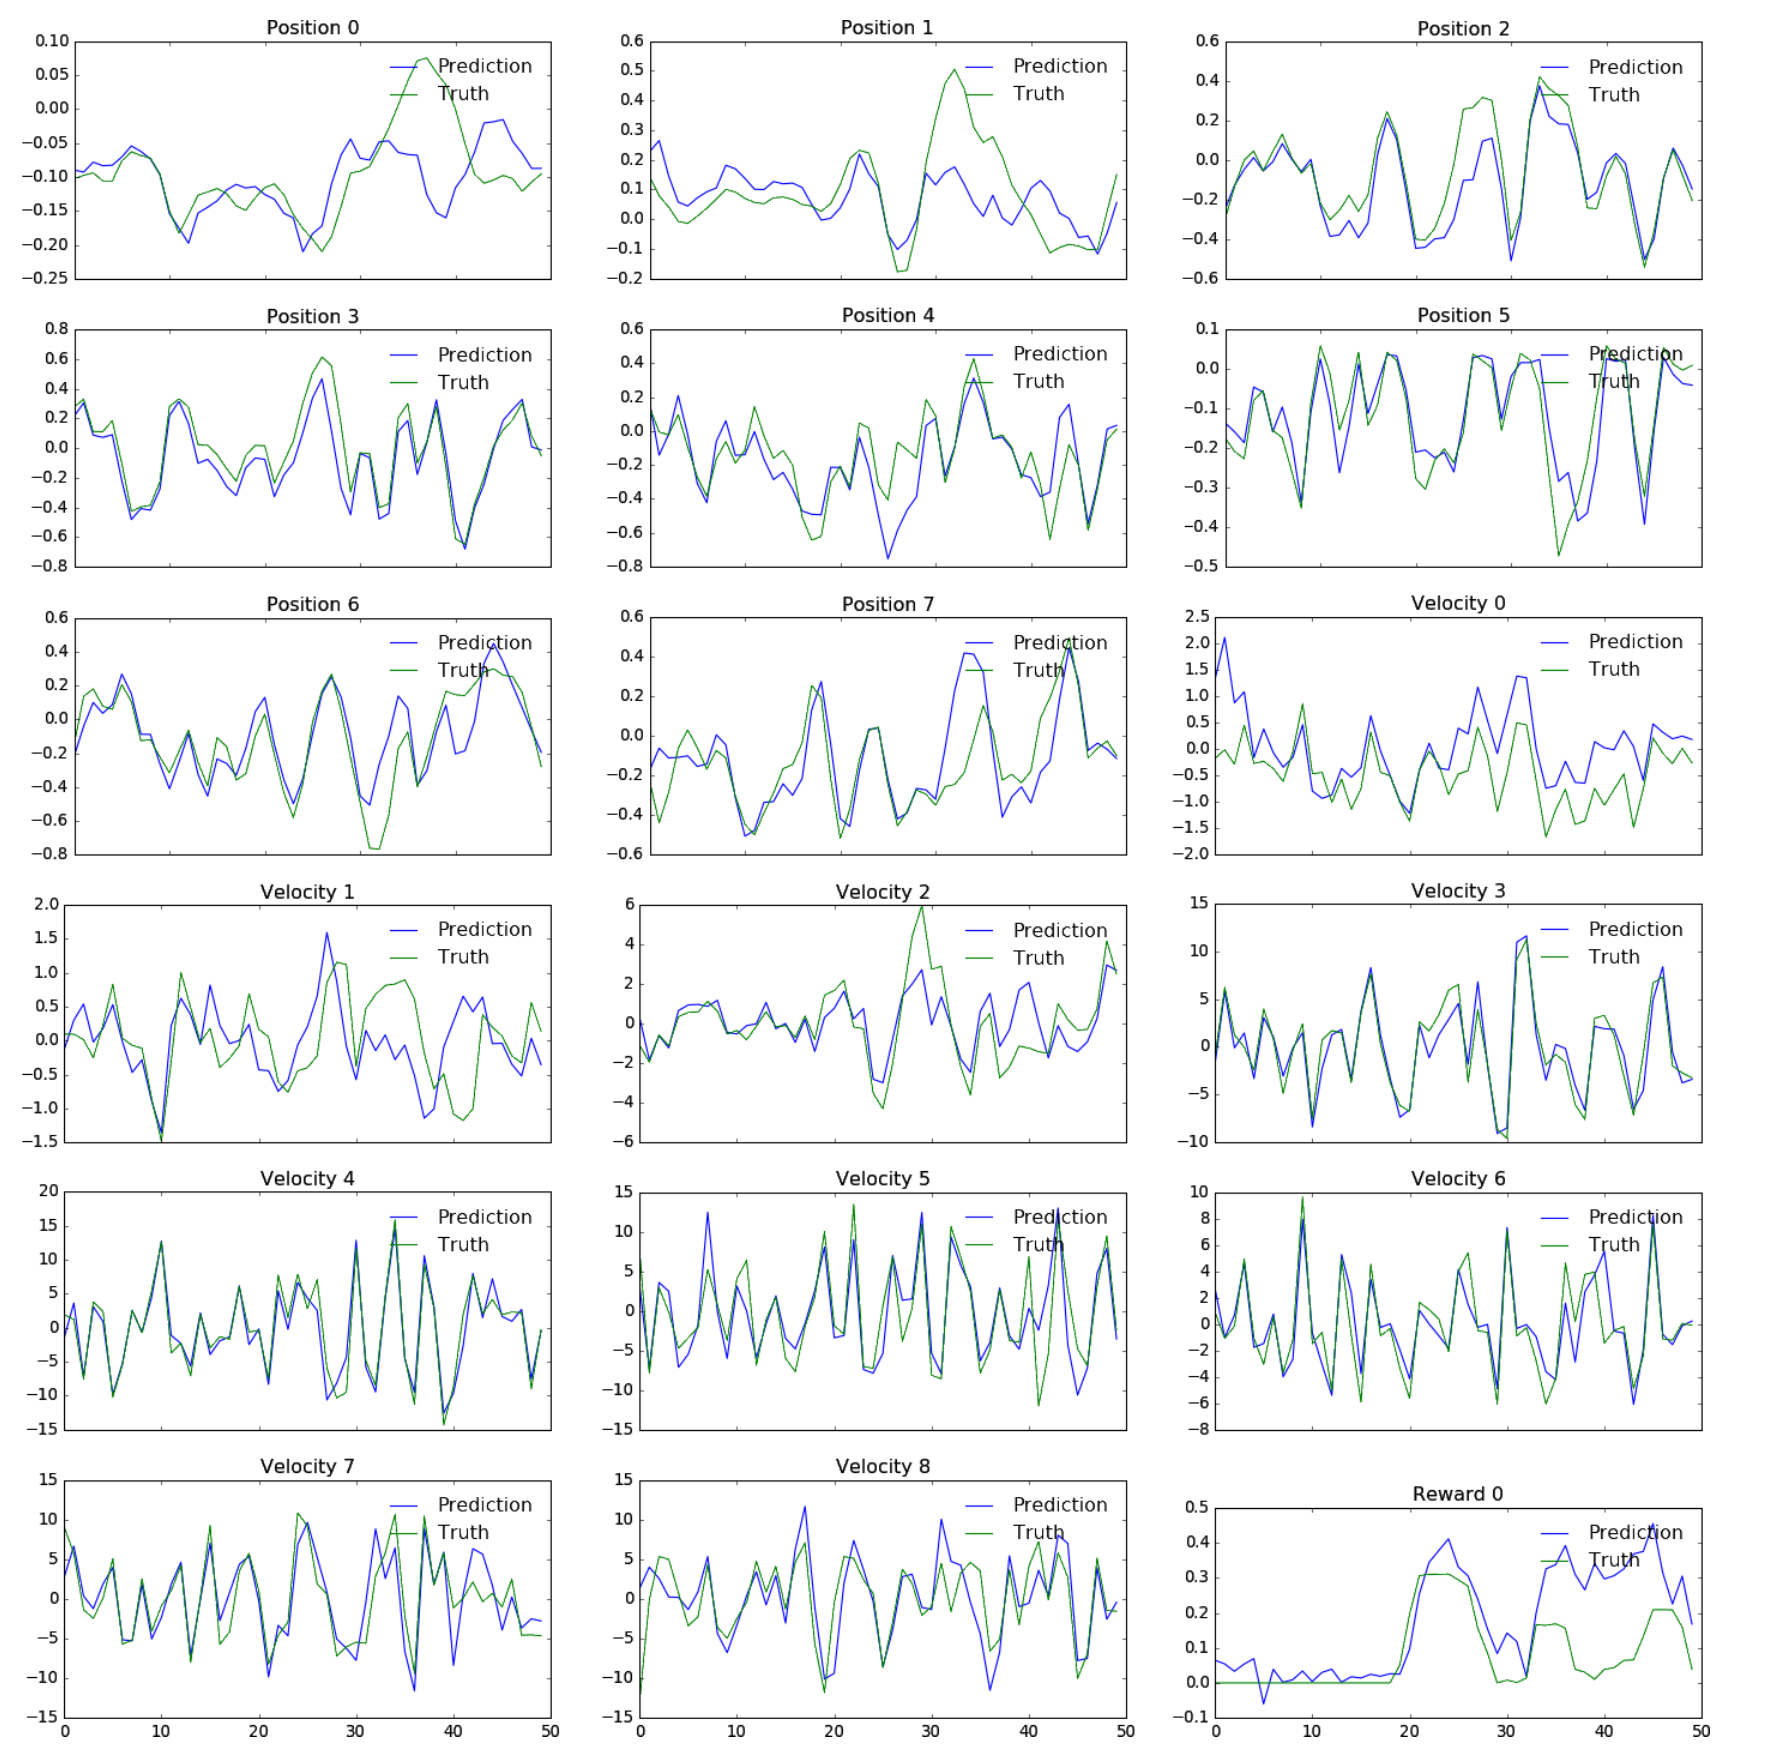
图 11:开环状态诊断。冻结 PlaNet 的动力学模型后,另训练小型神经网络预测模拟器真实位置、速度和奖励。这些量的开环预测表明,学到的潜在空间包含底层系统的大部分信息,能准确向前预测到超过本文规划跨度的位置。
附录 J. 规划参数
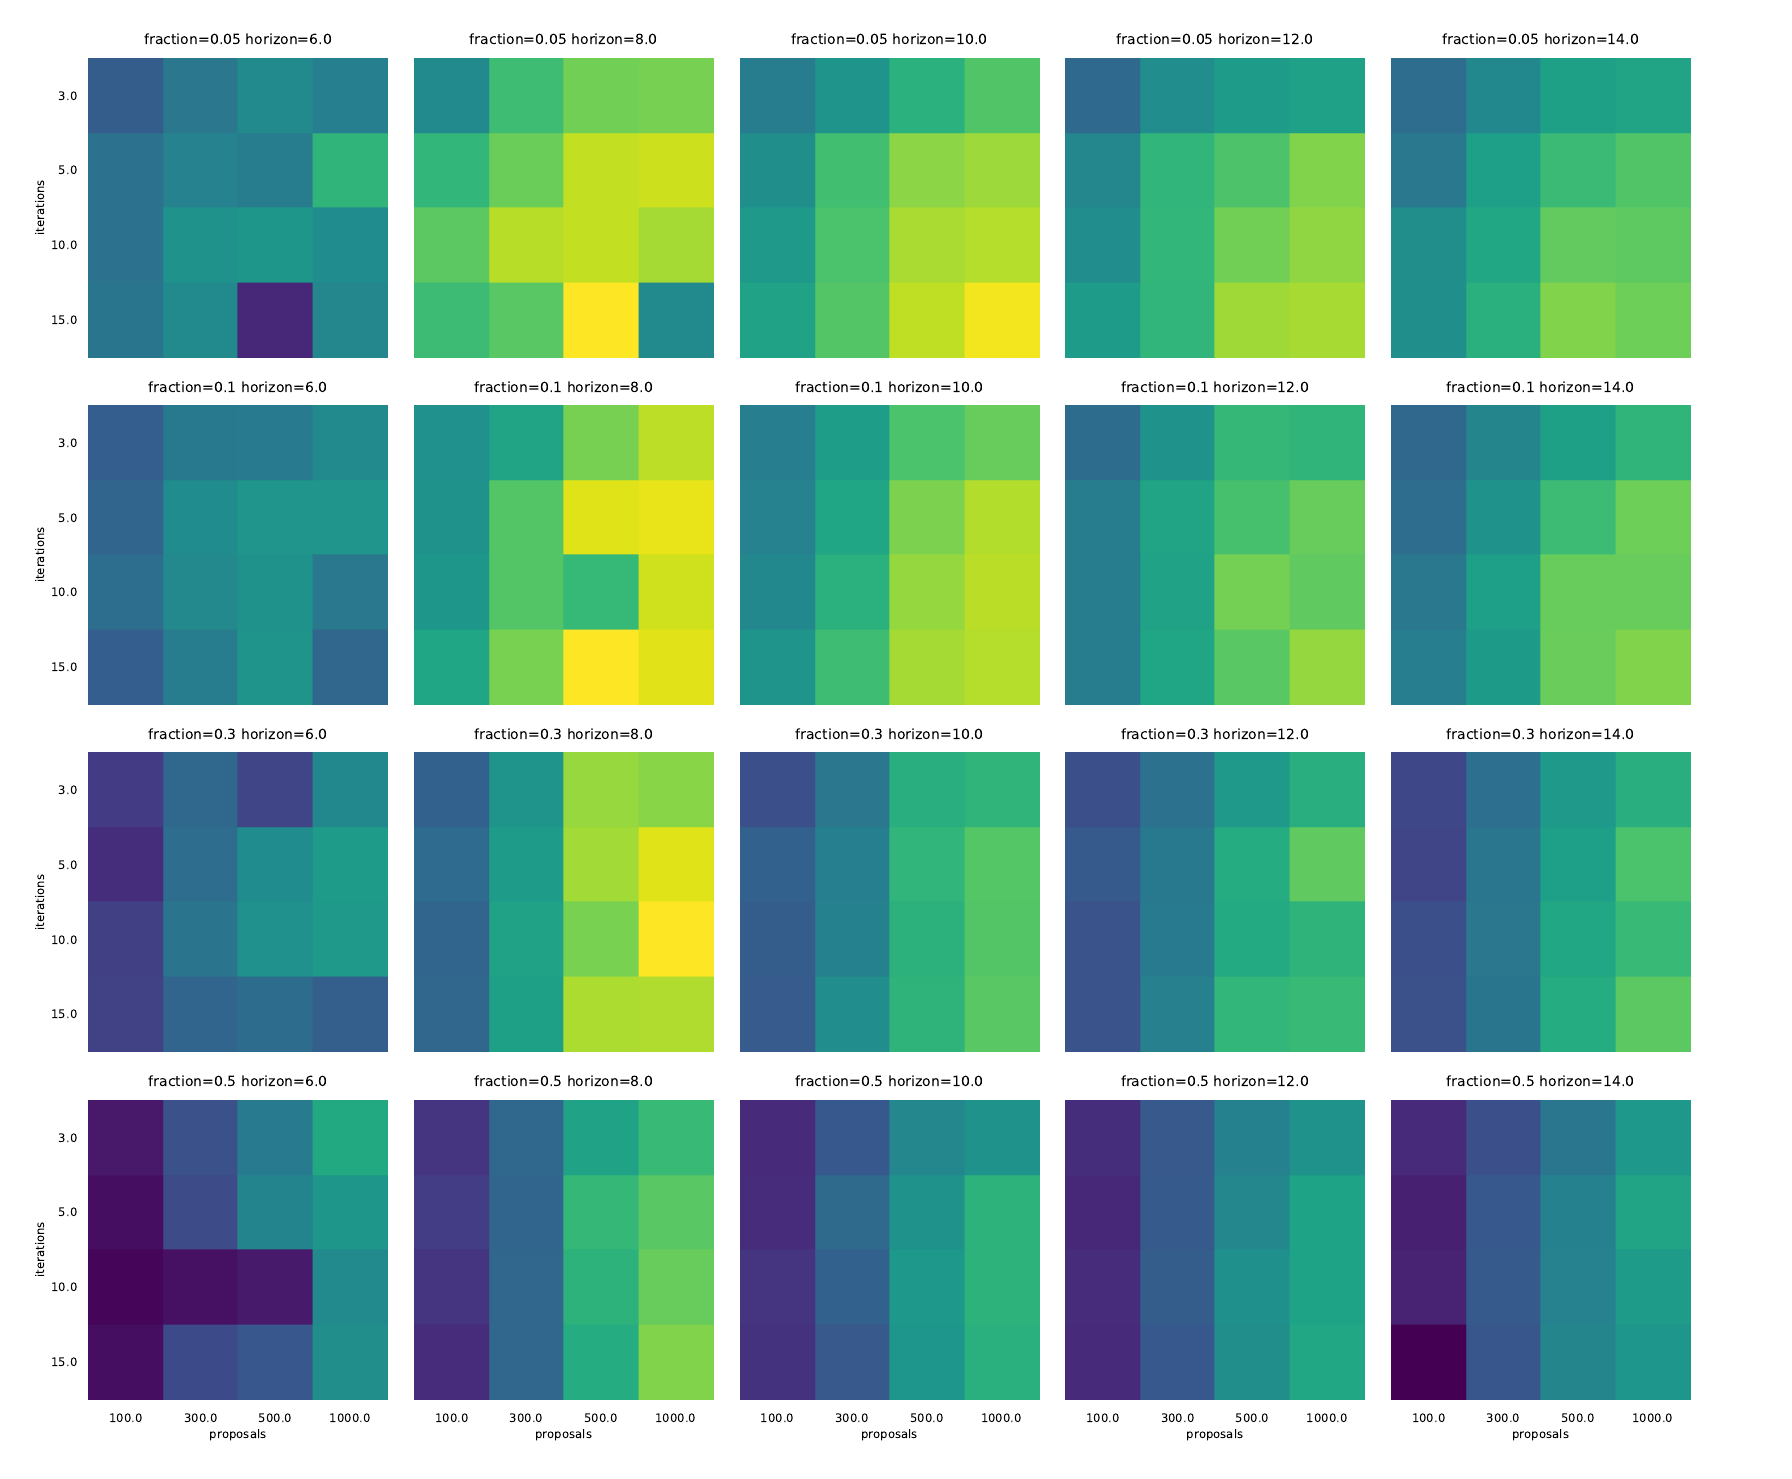
图 12:使用真实模拟器,在不同规划器参数下完成猎豹奔跑。表现从 132(蓝)到 837(黄)。更多候选、更长迭代、用更少最佳候选重拟合,通常提高表现。跨度 6 不够,结果较差;过长跨度因搜索空间增加而伤害表现。本环境的最佳规划跨度接近 8 步。
原文与来源
- PlaNet:ICML 2019 正式出版信息 ↗
- PlaNet:ICML 2019 正式论文全文 ↗
- PMLR 出版协议:CC BY 4.0 与原始出版链接要求 ↗
- Creative Commons:CC BY 4.0 许可条款 ↗
- PlaNet:正式补充 PDF,含附录 A–J ↗
图片:Danijar Hafner 等 · Learning Latent Dynamics for Planning from Pixels(ICML 2019)· CC BY 4.0 · 完整原图,图内内容未改