
版本与译文说明
原题:V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning。作者:Mahmoud Assran、Adrien Bardes、David Fan、Quentin Garrido、Russell Howes、Mojtaba Komeili、Matthew Muckley、Ammar Rizvi、Claire Roberts、Koustuv Sinha、Artem Zholus、Sergio Arnaud、Abha Gejji、Ada Martin、Francois Robert Hogan、Daniel Dugas、Piotr Bojanowski、Vasil Khalidov、Patrick Labatut、Francisco Massa、Marc Szafraniec、Kapil Krishnakumar、Yong Li、Xiaodong Ma、Sarath Chandar、Franziska Meier、Yann LeCun、Michael Rabbat、Nicolas Ballas。作者机构为 Meta FAIR,以及 Mila、蒙特利尔理工学院。作者署名以 PDF 为准。译者:世界模型图谱。
本译稿采用 arXiv:2506.09985v1,提交于 2025 年 6 月 11 日,PDF 首页注明日期为 2025 年 6 月 13 日。翻译摘要、正文 1–9 节、致谢及技术附录 A–E,保留全部 22 张数据表、19 张原图和公式。完整参考书目请阅原论文;图内英文标注不翻译,中文图注跟随正文,原文来源、署名和许可集中置于文末。
原文页面明确标注 CC BY 4.0,译文为翻译与排版改编。文中“我们”指原作者,性能比较保留发表时的版本和实验条件。“无标注机器人视频”不表示没有行动和本体状态数据;“零样本”指部署到新实验环境时未再收集训练数据,也不表示模型未经预训练和后训练。后续 V-JEPA 2.1 等版本不纳入本译稿。
摘要
现代 AI 的一大挑战,是主要通过观察学会理解世界并学会行动(LeCun, 2022)。本文探索一种自监督方法,将互联网规模视频与少量交互数据——机器人轨迹——结合,得到能够在物理世界中理解、预测和规划的模型。我们先在包含超过 100 万小时互联网视频的图像与视频数据集上,预训练不含行动条件的联合嵌入预测架构 V-JEPA 2。它在运动理解上取得较强表现,Something-Something v2 的 top-1 准确率为 77.3;在人类行动预判上达到当时最先进的表现,Epic-Kitchens-100 的 recall-at-5 为 39.7,超过此前专用模型。
把 V-JEPA 2 与大语言模型对齐后,我们在 80 亿参数规模的多个视频问答任务上达到当时最先进水平,例如 PerceptionTest 84.0、TempCompass 76.9。最后,我们展示自监督学习如何应用于机器人规划:利用 Droid 数据集中不足 62 小时的无标注机器人视频,后训练一个潜在空间的行动条件世界模型 V-JEPA 2-AC。它零样本部署在两个不同实验室的 Franka 机械臂上,通过图像目标规划实现物体拾取与放置;没有收集这两个环境里机器人的数据,也没有任务专用训练或奖励。这表明,网络规模自监督数据与少量机器人交互数据可以产生能在物理世界中规划的世界模型。
1. 引言
人类能够在新任务和陌生环境中适应、泛化。若干认知学习理论认为,人类整合底层感官输入,学习能够表征和预测未来状态的内部世界模型(Craik, 1967;Rao and Ballard, 1999),这种模型塑造即时知觉、帮助理解现实(Friston, 2010;Clark, 2013;Nortmann 等, 2015)。预测自身行动对未来状态的影响,也对目标导向规划至关重要(Sutton and Barto, 1981, 1998;Ha and Schmidhuber, 2018;Wolpert and Ghahramani, 2000)。从视频等感官数据学习世界模型,可能使人工智能体理解物理世界、预测未来并在新情形中规划,处理此前未遇到的任务。
以往工作从状态和行动序列等交互数据学习预测性世界模型,往往还依赖环境的显式奖励来推断目标(Sutton and Barto, 1981;Fragkiadaki 等, 2015;Ha and Schmidhuber, 2018;Hafner 等, 2019b;Hansen 等, 2022)。现实交互数据有限,制约其扩展。较新的工作把互联网视频与交互数据结合,训练用于机器人控制的行动条件视频生成模型,却只展示有限的模型控制结果(Hu 等, 2023;Yang 等, 2024b;Bruce 等, 2024;Agarwal 等, 2025)。这些研究常强调预测忠实度和视觉质量,较少评估规划能力,或与生成视频进行规划的计算成本有关。
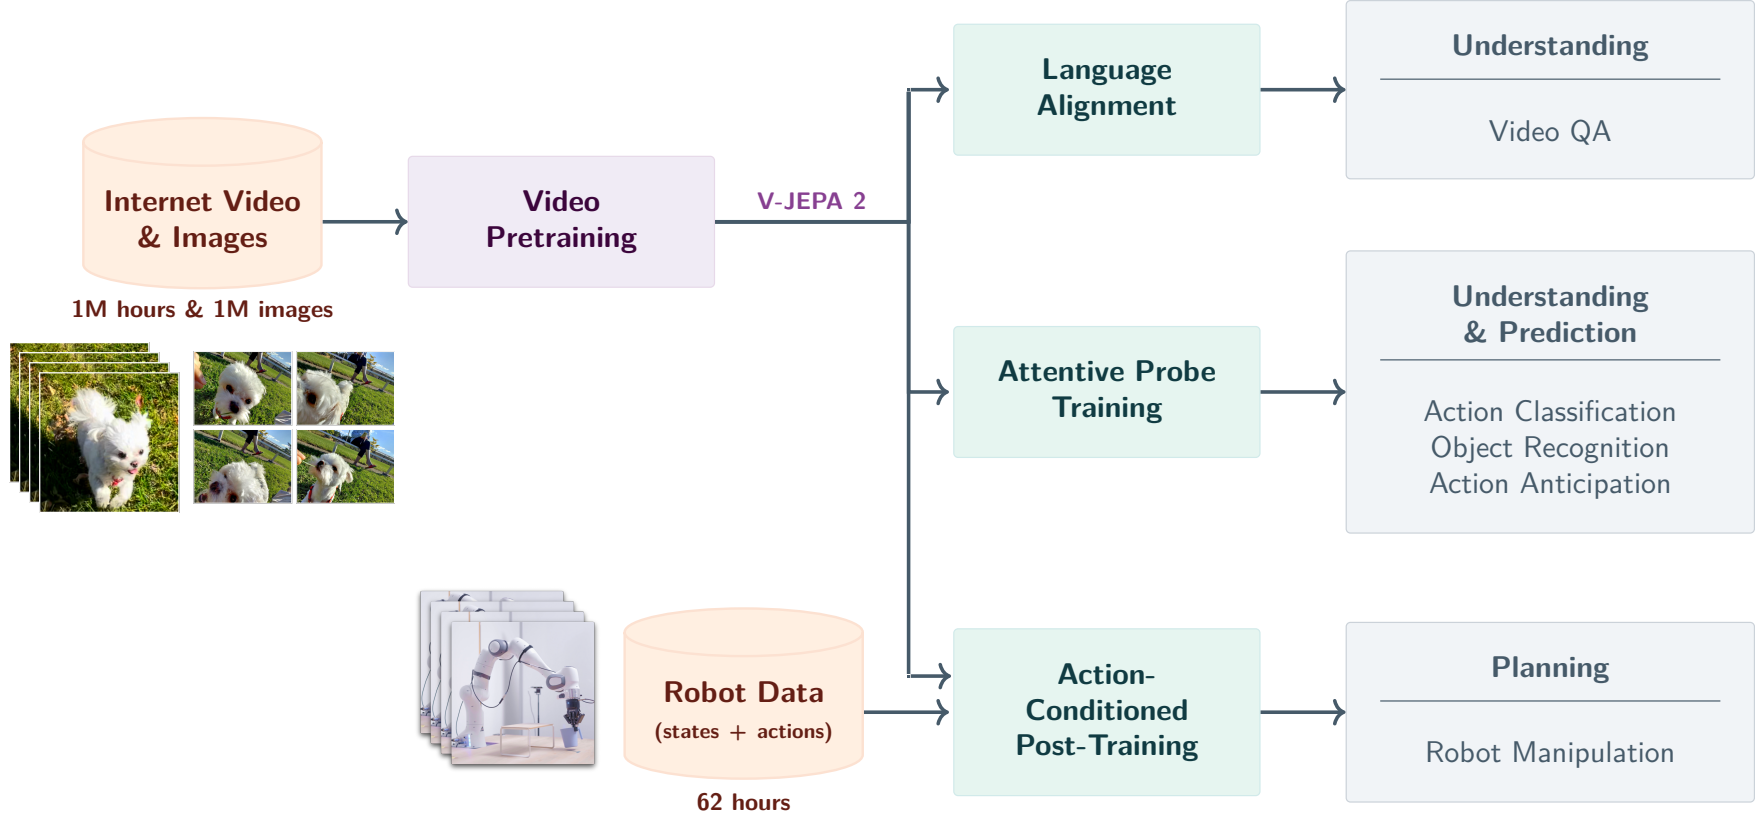
图 1:V-JEPA 2 概览。利用 100 万小时互联网视频和 100 万张图像,以视觉掩码去噪目标预训练视频模型,用于行动分类、物体识别、行动预判;与 LLM 对齐后用于视频问答。预训练后可冻结视频编码器,在少量机器人交互数据上训练新的行动条件预测器 V-JEPA 2-AC,在模型预测控制循环中完成机器人操作。
我们基于自监督假设,主要从观察学习捕捉世界背景知识的模型,采用联合嵌入预测架构 JEPA(LeCun, 2022),在学习到的表征空间中预测。互联网规模视频给出了状态序列,却通常没有直接观察到的行动;自监督学习可以用这些视频同时学习观测表征及表征空间中的世界动态。相较像素生成,JEPA 侧重可预测的场景方面,如运动物体的轨迹,忽略生成目标强调的不可预测细节,如草地里每片草叶和树上每片叶子的精确位置。扩大 JEPA 预训练规模,可获得具有较强理解与预测能力的视频表征,并用于行动条件模型和零样本规划。
V-JEPA 2 分阶段训练:先在互联网规模视频上进行无行动条件的预训练,再用少量交互数据后训练(图 1)。第一阶段在学习表征中预测被掩码的视频片段,编码器最多约 10 亿参数、训练数据超过 100 万小时。扩大自监督视频预训练,能够增强运动及外观识别,表现可通过探针评估,或与语言模型对齐后的视频问答来检验。
随后,在第一阶段表征上训练 V-JEPA 2-AC。它是约 3 亿参数、采用块因果注意力的 Transformer,根据行动及先前状态,自回归预测下一帧的表征。仅使用 Droid(Khazatsky 等, 2024)约 62 小时的无标注交互数据,我们就能训练出潜在世界模型:给定子目标,通过单目 RGB 相机,在新环境的 Franka 机械臂上零样本规划并完成抓持操作。
- 理解——探针分类:扩大预训练获得适用于多任务的表征。注意力探针在运动理解任务 Something-Something v2 上得到 77.3 top-1 准确率。
- 理解——视频问答:与 8B 语言模型结合,在 MVP(44.5 成对准确率)、PerceptionTest(84.0 测试集准确率)、TempCompass(76.9 选择题准确率)、TemporalBench(36.7 短问答多二元准确率)和 TOMATO(40.3 准确率)等任务上达到当时最先进水平。无语言监督预训练的视频编码器也能与语言模型对齐,取得领先结果,挑战已有看法。
- 预测:注意力探针在 Epic-Kitchens-100 行动预判上得到 39.7 recall-at-5,相较此前最佳模型相对提升 44%。
- 规划:仅用 Droid 约 62 小时的交互数据后训练 V-JEPA 2-AC,不使用实验室机器人的额外训练数据、任务专用训练或奖励,即可借助给定子目标,完成新物体和新环境中的抓取及拾取放置。
余下各节依次介绍预训练与扩展要素(第 2 节)、V-JEPA 2-AC(第 3 节)、机器人规划(第 4 节),以及依赖表征信息的理解(第 5 节)、预测(第 6 节)和视频问答(第 7 节),最后讨论相关工作。
2. V-JEPA 2:扩大自监督视频预训练/2.1. 方法
我们在超过 100 万小时视频的视觉数据集上预训练 V-JEPA 2。训练任务基于表征空间中的掩码去噪,扩展 V-JEPA 框架(Bardes 等, 2024):使用更大模型、更多预训练数据,并采用时空分辨率渐进训练,高效超越短 16 帧片段。
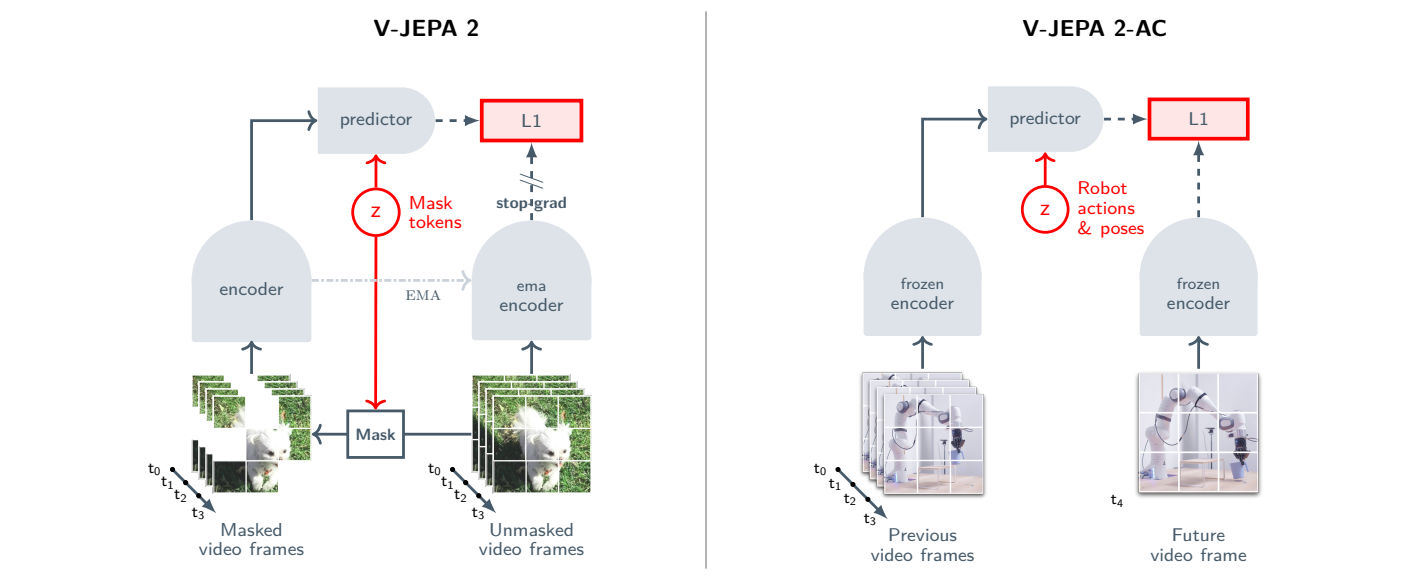
图 2:多阶段训练。左:片段切成 token,丢弃部分 token 实施掩码,编码器输出其余 token 的嵌入;与指定缺失位置的可学习掩码 token 拼接后送入预测器,用 L1 损失回归 EMA 编码器计算的目标。右:冻结视频编码器,训练 V-JEPA 2-AC,依据历史视频帧、行动及末端状态自回归预测未来帧表征。块因果注意力允许当前图像块读取本时刻及历史的特征、行动和末端状态。
表征空间中的掩码去噪。编码器 Eθ(·) 提取视频表征,预测器 Pφ(·) 根据掩码视图 x 预测视频 y 被遮去部分的表征。两者共同训练:
minimize[θ, φ, Δy] ‖Pφ(Δy, Eθ(x)) − sg(Eθ̄(y))‖₁。 (1)
Δy 是指示缺失图像块位置的可学习掩码 token。停止梯度 sg(·) 与编码器权重 θ 的指数滑动平均 θ̄ 用来防止表征坍塌;只对被掩码图像块的预测施加损失。
架构。编码器和预测器都为视觉 Transformer(ViT;Dosovitskiy 等, 2020)。我们用旋转位置嵌入 RoPE 代替 Bardes 等(2024)的绝对 sincos 嵌入。将特征维度近似均分为时间、高度、宽度三段,对每轴分别应用一维旋转,得到三维 RoPE(Su 等, 2024)。它有助于稳定最大模型的训练。视频先切为 2×16×16(时间×高度×宽度)的 tubelet,掩码沿用 V-JEPA 的多块策略。
- 数据扩展:由 200 万到 2200 万视频,增加来源并整理数据。
- 模型扩展:由约 3 亿参数 ViT-L 到超过 10 亿参数 ViT-g(Zhai 等, 2022)。
- 延长训练:使用预热—恒定—衰减学习率,简化调参,训练由 9 万到 25.2 万次迭代。
- 提高分辨率:预热和恒定阶段用较短、较低分辨率片段,最终衰减阶段再提高分辨率和片段长度。
评估流程。预训练旨在赋予编码器通用视觉理解,因此用六个运动及外观分类任务检验设计:SSv2、Diving-48、Jester、Kinetics、COIN、ImageNet。冻结编码器,针对每个任务训练 4 层注意力探针输出类别。本节主要看六任务平均准确率,详细流程和结果见第 5 节。
2.2. 扩大自监督视频学习
图 3 汇总四个要素对平均任务表现的影响,以在 200 万视频上用 V-JEPA 目标训练的 ViT-L/16 为基线。数据扩为 VM22M,提升 1.0 个百分点;模型由 3 亿到 10 亿参数,另增 1.5 点;训练由 90K 到 252K 次迭代,另增 0.8 点;训练及评估的空间分辨率由 256 到 384、时长由 16 到 64 帧,最终达到 88.2%。累计提升 4.0 点,每项改动都有正效应,支持视频自监督学习的规模扩展潜力。
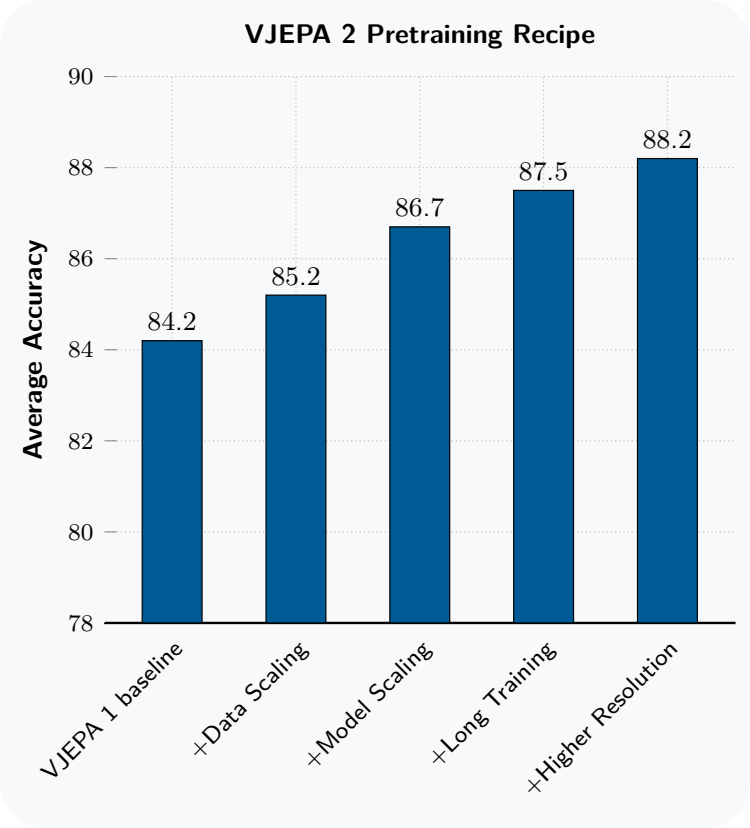
图 3:扩展要素对六个图像及视频分类任务(SSv2、Diving-48、Jester、Kinetics、COIN、ImageNet)平均准确率的影响,以 ViT-L/16 为基线。
2.3. 预训练数据集
扩大数据集。我们结合公开可用的数据来源,便于其他研究者复现实验:SSv2 的第一视角视频(Goyal 等, 2017)、Kinetics 400/600/700 的第三视角行动视频(Kay 等, 2017;Carreira 等, 2018, 2019)、HowTo100M 的 YouTube 教程(Miech 等, 2019)、YT-Temporal-1B 的普通 YouTube 视频(Zellers 等, 2022,简称 YT1B),并加入 ImageNet 图像(Deng 等, 2009)扩大视觉覆盖。
为联合预训练图像与视频,把一张图像沿时间复制成 16 个相同帧。训练时按人工调节、经验确定的权重从各来源采样。所得 VideoMix22M(VM22M)包含 2200 万样本,来源及权重见表 1。
| 来源 | 样本数 | 类型 | 总小时数 | 数据整理 | 采样权重 |
|---|---|---|---|---|---|
| SSv2 | 168K | 第一视角视频 | 168 | 否 | 0.056 |
| Kinetics | 733K | 第三视角视频 | 614 | 否 | 0.188 |
| Howto100M | 1.1M | 第三视角视频 | 134K | 否 | 0.318 |
| YT-Temporal-1B | 19M | 第三视角视频 | 1.6M | 是 | 0.188 |
| ImageNet | 1M | 图像 | n/a | 否 | 0.250 |
图 4 左对比 VM22M 与 Bardes 等(2024)的 200 万样本 VideoMix2M。ViT-L/16 在 VM22M 上训练,视觉理解任务平均提高 1 点;Kinetics-400、COIN、ImageNet 等外观任务提升更明显,说明这些任务需要更多视觉覆盖。
数据整理。YT1B 有约 140 万小时视频,未整理且筛选少于 Kinetics、SSv2 等小数据集。未整理、不平衡数据会妨碍性能(Assran 等, 2022;Oquab 等, 2023)。我们把现有检索式整理流程扩展到视频:分割场景、计算每场景嵌入,用聚类检索按 Kinetics、SSv2、COIN 和 EpicKitchen 训练集构成的目标分布选择场景,细节见 A.2。确保目标验证集的视频不在初始数据池中。
图 4 右中,用整理后 YT1B 训练的 ViT-L 平均提高 1.4 点;在 ViT-L 规模上,它与完整 VM22M 竞争力相近。但更大的模型更受益于 VM22M(见附录 A.2),说明整理后 YT1B 与其他数据源结合有利于扩展。
译者注:正文称 YT1B 约 140 万小时,表 1 为 160 万小时;此处各自保留原文数字。
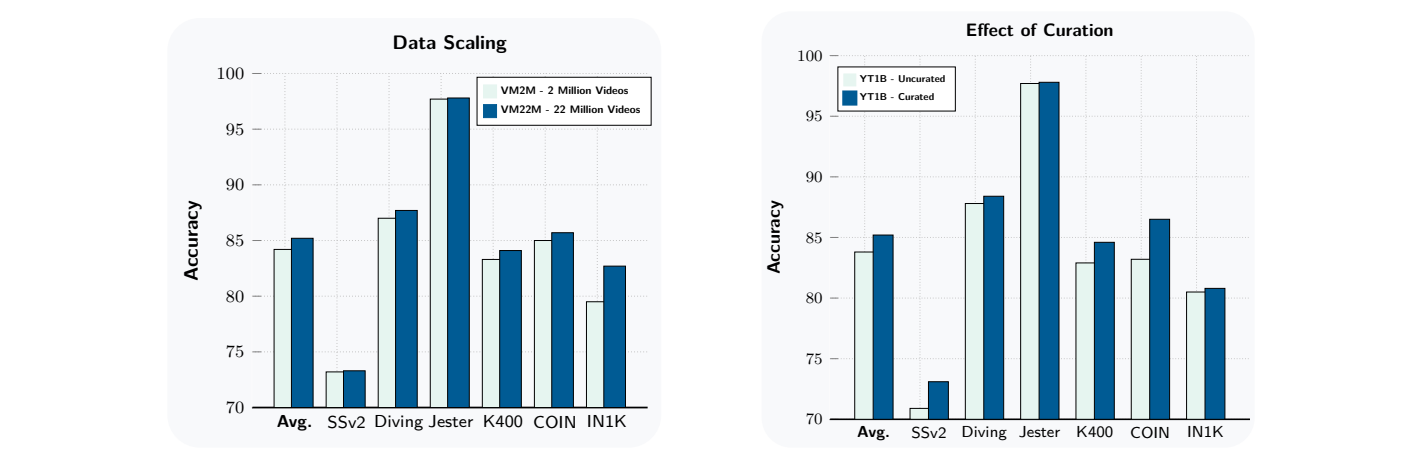
图 4:数据扩展与整理。ViT-L/16 按 Bardes 等(2024)用余弦学习率训练 90K 次。左:VM22M 比 VM2M 平均高 1 点,外观任务改善更大。右:聚类检索整理后的 YT1B 比原始 YT1B 平均高 1.4 点。
2.4. 预训练方案
模型规模。我们训练从约 3 亿参数 ViT-L 到 10 亿参数 ViT-g 的编码器族,架构见表 12。每个编码器使用相同、类似 ViT-small 的预测器。图 5 左展示平均视觉理解表现:扩大编码器平均提升 1.5 点,SSv2 增 1.6 点、Kinetics 增 1.5 点(表 4)。运动与外观任务都受益,自监督视频预训练可利用更大的模型容量。
训练日程。采用预热—恒定学习率,随后降温(Zhai 等, 2022;Hägele 等, 2024)。效果与半余弦日程相当(Loshchilov and Hutter, 2016),但能从恒定阶段的不同检查点启动多次降温,更经济地探索长训练。我们固定教师 EMA 和权重衰减系数,不再逐步提高,因其对下游任务影响很小。ViT-g 从 90K 延长到 252K 次迭代,平均增 0.8 点(图 3);降温阶段也便于逐步提高视频分辨率。
高效渐进分辨率训练。此前视频编码器多处理短 16 帧片段(Bardes 等, 2024;Wang 等, 2024b, 2023)。我们探索最高 64 帧、16 秒及更高空间分辨率。直接让 ViT-g 始终处理 64×384×384 输入,预计需要约 60 GPU 年(图 5 中)。为降低成本,使用渐进分辨率策略(Touvron 等, 2019;Oquab 等, 2023):先用 16 帧、256×256 视频,12K 次线性预热,228K 次恒定学习率,再用 12K 次降温提高时长、分辨率并线性降低学习率。
更高时空分辨率的额外成本只在最后降温阶段发生。相较全部阶段从零按完整分辨率训练,处理 64 帧、384×384 输入的模型 GPU 时间降低 8.4 倍(图 5 中),仍可得到处理更长、更高分辨率视频的收益。
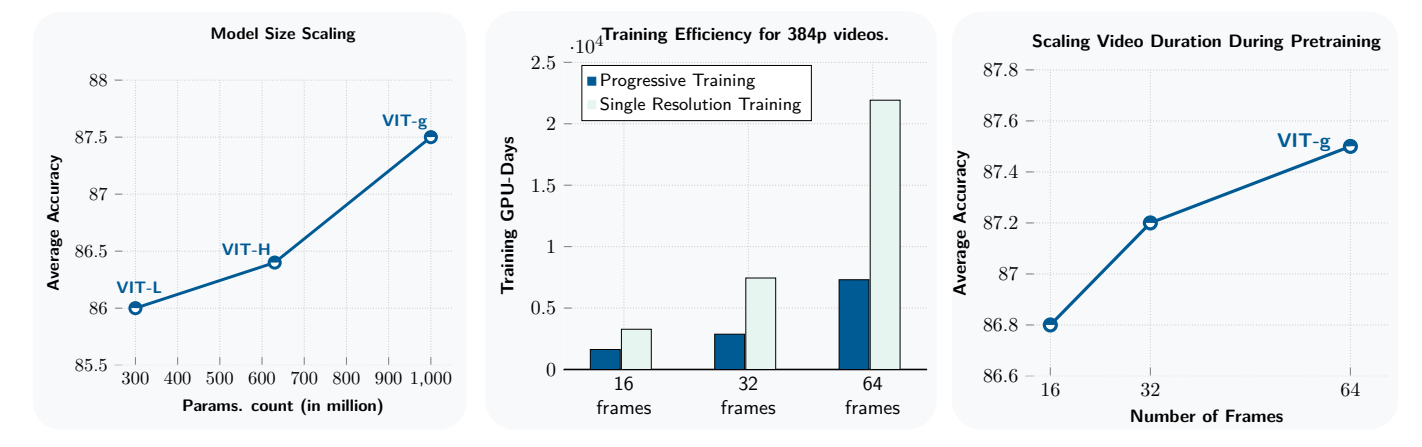
图 5:模型扩展。左:在 VM22M 上恒定学习率训练到下游表现平台,再用 64 帧、256×256 降温,模型由 300M 到 1B 平均增 1.7 点。中:A100 上 384×384 视频的 GPU 日数,比较渐进训练(252K 次 16 帧/256×256,再 12K 次 384×384 降温)与完整分辨率训练的预计时间,提速最高约 8 倍。右:ViT-g 降温阶段从 16 到 64 帧,即使推理只用 16 帧,平均也增 0.7 点。
译者注:图 5 各子实验的训练计数和提升值按其图注保留,不能把图 5 左的 1.7 点直接替换成正文或图 3 的 1.5 点。正文日程为 12K + 228K + 12K,图 5 中另写 252K + 12K。
时间及空间分辨率。固定 16 帧评估时,训练片段由 16 到 64 帧,平均增 0.7 个百分点。评估时同时提高时长和分辨率,也让各任务显著改善(表 4、A.4.2)。自监督视频训练在训练和评估中都受益于更长片段。我们也试了 128、256 帧,但在这组理解任务上没有看到超过 64 帧的进一步改善。
3. V-JEPA 2-AC:学习行动条件世界模型
预训练的 V-JEPA 2 能预测视频缺失部分,却不直接考虑智能体可能行动的因果影响。下一阶段用少量交互数据,使模型能规划:在冻结的视频编码器上学习按帧因果的行动条件预测器(图 2 右),数据来自遥操作桌面 Franka Panda 机械臂的 Droid。所得 V-JEPA 2-AC 可进入模型预测控制循环,在新环境规划行动(第 4 节)。
3.1. 行动条件世界模型训练
目标是把预训练模型转为可通过闭环模型预测控制驱动具身智能体的潜在世界模型。V-JEPA 2-AC 根据控制行动及本体感知观测,自回归预测未来视频表征。这里具体应用于固定第三视角相机下的桌面机械臂,控制行动为末端执行器指令。
训练用 Droid 原始数据中约 62 小时无标注视频,通常长 3–4 秒,拍摄带双指夹爪的 7 自由度 Franka Emika Panda。“无标注”指不使用额外元数据来指出奖励、演示的任务类别或是否成功;使用的仍有原始视频,以及每帧的末端状态:位置三维、姿态三维、夹爪一维。
输入。每次随机采样一批 4 秒片段,为简便丢弃不足 4 秒的视频,留下不足 62 小时的数据。256×256、4 fps,得到 16 帧 (xₖ)。末端状态 sₖ 为相对机器人基座的实值七维向量,前三维是笛卡尔位置,中间三维是外禀欧拉角,最后一维是夹爪状态。相邻状态差构成 15 个七维行动 aₖ。随机缩放裁剪增强的宽高比范围为 0.75–1.35。
损失。把 V-JEPA 2 编码器作为图像编码器,独立编码各帧:zₖ := E(xₖ) ∈ ℝ^(H×W×D)。特征实际由 ViT-g 编码,形状为 16×16×1408;后训练期间编码器保持冻结。把 (aₖ, sₖ, zₖ) 按时间交织输入 Transformer 预测器 Pφ,得到下一状态预测 ẑₖ₊₁。教师强制损失为:
Lteacher-forcing(φ) := (1/T) Σ[k=1…T] ‖ẑₖ₊₁ − zₖ₊₁‖₁ = (1/T) Σ[k=1…T] ‖Pφ((aₜ, sₜ, E(xₜ))ₜ≤ₖ) − E(xₖ₊₁)‖₁,T = 15。 (2)
为提升推理时的自回归滚动能力,另计算两步滚动损失。略复用记号,让 Pφ(â₁:T; sₖ, zₖ) 表示从 (sₖ,zₖ) 开始按候选行动序列自回归运行所得最终状态表征,则:
Lrollout(φ) := ‖Pφ(a₁:T; s₁, z₁) − zT₊₁‖₁。 (3)
实际取 T = 2,因此只通过一个循环步骤对预测器求导。总体目标为 L(φ) := Lteacher-forcing(φ) + Lrollout(φ),对预测器权重 φ 最小化。 (4)图 6 为示意,在两项损失中都画成 T = 4。
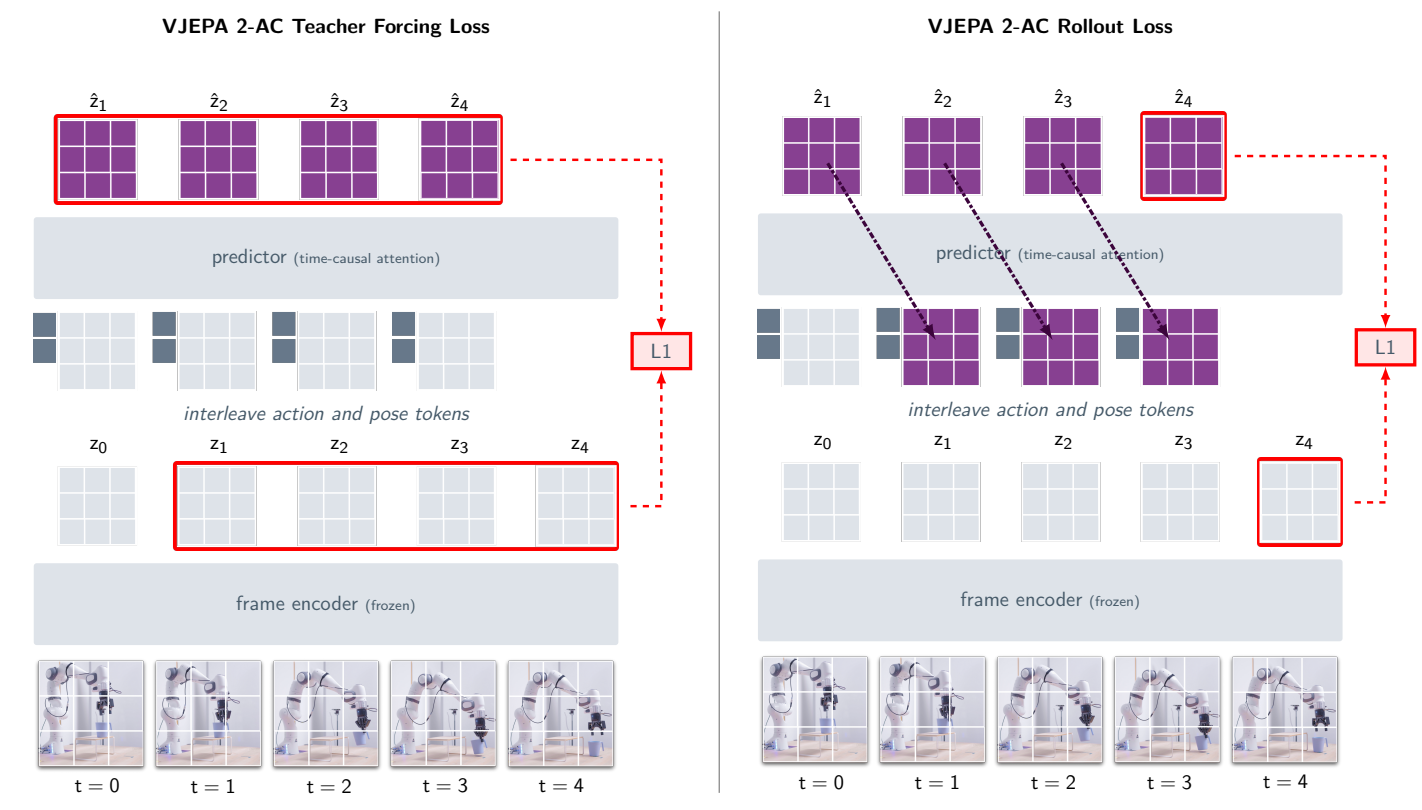
图 6:V-JEPA 2-AC 训练。左:教师强制损失以当前帧的编码为输入,学习预测下一时刻表征。右:滚动损失把预测器输出重新送入,训练多个未来步;联合优化两者可减轻滚动中的误差积累。
架构。预测器约 300M 参数,24 层、16 个注意力头、隐藏维度 1024、GELU 激活。行动、末端状态与展平特征各用可学习仿射变换映射到隐藏维度,最后注意力块输出再映回编码器嵌入维度。视频图像块用三维 RoPE 表示时空位置,行动和姿态 token 只用时间旋转嵌入。块因果注意力让某时刻的每个图像块读取同一时刻及此前的行动、末端状态和其他图像块特征。
3.2. 通过规划推断行动
能量最小化。给定目标状态图像,每一时刻规划固定时域的行动序列,最小化目标条件能量,执行第一步、观察新状态,再重复。当前末端状态为 sₖ,当前帧 xₖ 和目标帧 xg 编码为 zₖ、zg。规划时域 T 下:
ℰ(â₁:T; zₖ, sₖ, zg) := ‖P(â₁:T; sₖ, zₖ) − zg‖₁;a*₁:T := argmin[â₁:T] ℰ(â₁:T; zₖ, sₖ, zg)。 (5)
所选轨迹使 T 步后的想象状态与目标表征之间 L1 距离最小。实际每步用交叉熵方法(Cross-Entropy Method;Rubinstein, 1997)优化,只执行第一个行动后重规划,属于滚动时域控制。
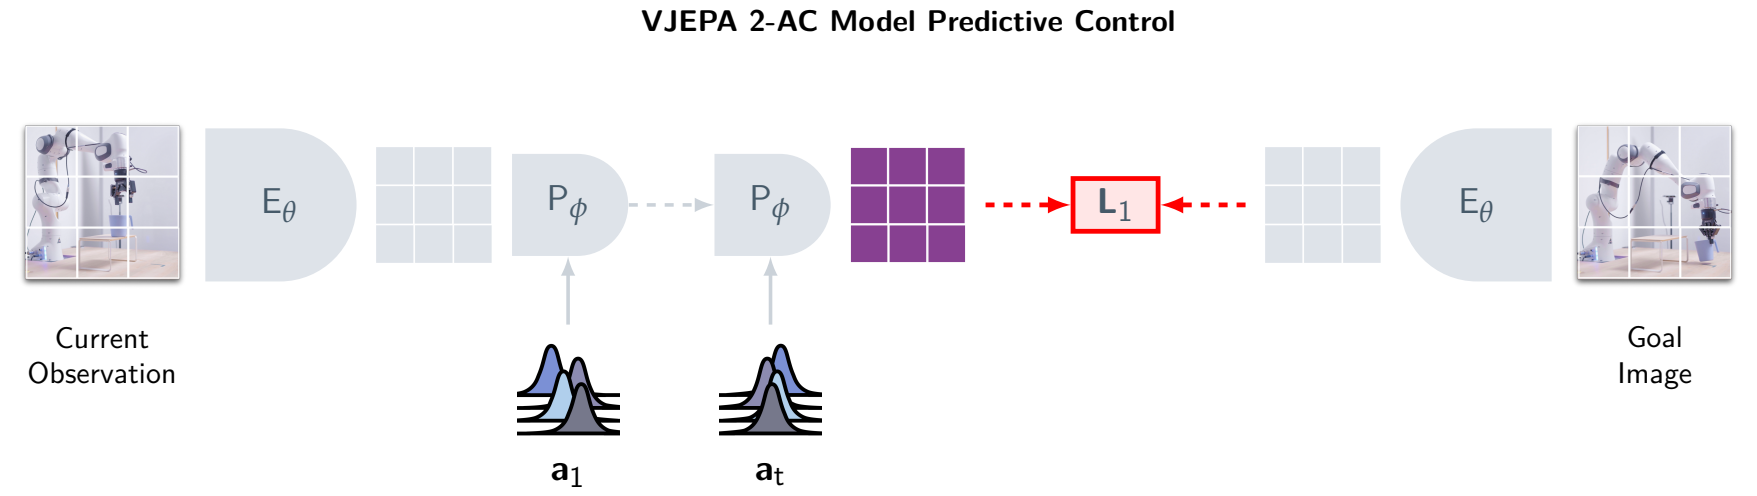
图 7:固定时域 T 的规划。用交叉熵方法最小化想象未来状态与目标表征的 L1 距离;每次先从零均值、单位方差的高斯序列采样各时刻行动坐标,取 top-k 轨迹更新均值方差,多次迭代后返回高斯序列均值作为行动轨迹。
4. 规划:零样本机器人控制/4.1. 实验设置
本节用模型预测控制实现到达、抓取、拾取放置等基本机器人技能,以视觉目标指定任务,并展示 V-JEPA 2-AC 对新环境的零样本泛化。
基线。比较两个方法:行为克隆训练的视觉语言行动模型,以及基于视频生成的世界模型。第一种为可接受目标图像的 Octo(Octo Model Team 等, 2024)。采用开源 octo-base-1.5 权重,在超过 100 万轨迹的 Open-X Embodiment 上预训练;作为对照,V-JEPA 2-AC 用 Droid 约 2.3 万条成功与失败轨迹训练。Octo 在全部 Droid 上用行为克隆微调,采用目标图像和末端状态的事后重标记(Andrychowicz 等, 2017;Ghosh 等, 2019):采样随机轨迹片段,均匀选择之后最多 20 步的目标图像。用官方微调代码及标准 Droid 超参数,单侧视图 256×256、历史两帧、未来四个行动。
第二种为 Cosmos(Agarwal 等, 2025)。采用基于连续 tokenizer 的 latent diffusion-7B 无行动条件开源权重,原预训练视频约 2000 万小时;按官方行动条件微调代码在 Droid 上训练。为改善表现,我们降低学习率到视频条件方案水平、取消视频条件 dropout、把噪声强度提高 e² 倍,因低噪声模型难利用条件帧信息。Cosmos 技术报告把规划或模型预测控制列为未来应用;据我们所知,这是首次报告用 Cosmos 控制机器人。
部署。所有模型零样本部署在两个不同实验室的 Franka Emika Panda、RobotiQ 夹爪上,这些实验室都不在 Droid 数据中。视觉输入来自未校准、低分辨率单目 RGB 相机;两台机器人用完全相同的权重与推理代码,并用相近的操作空间底层控制器。V-JEPA 2-AC 和 Cosmos 采用阻塞控制,完成上一指令才发下一指令;Octo 试阻塞与非阻塞,报告较好结果。
规划时,V-JEPA 2-AC 和 Cosmos 的每个采样行动约束到以原点为中心、半径 0.075 的 L1 球;原文称这对应单次末端最大约 13 cm 位移,因为大行动相对偏离模型数据分布。
译者注:原文将“半径 0.075 的 L1 球”和“约 13 cm 最大位移”并列。若只对以米计的三维平移向量采用该 L1 约束,欧氏位移上界应为 7.5 cm;这里保留作者的两个表述,具体采样约束需与实现核对,不能视为等价的数学换算。
4.2. 结果
单目标到达。根据单个目标图像,把末端移到期望空间位置,检验对行动及单目场景三维结构、深度的基本理解。图 8 是三种任务中的末端与目标欧氏距离;模型都能到达距目标不足 4 cm 的位置,并选择使误差单调下降的行动。可把它看作视觉伺服(Hill and Park, 1979),利用相机反馈控制运动,但与经典视觉伺服不同,我们从无任务标注的现实视频学习。
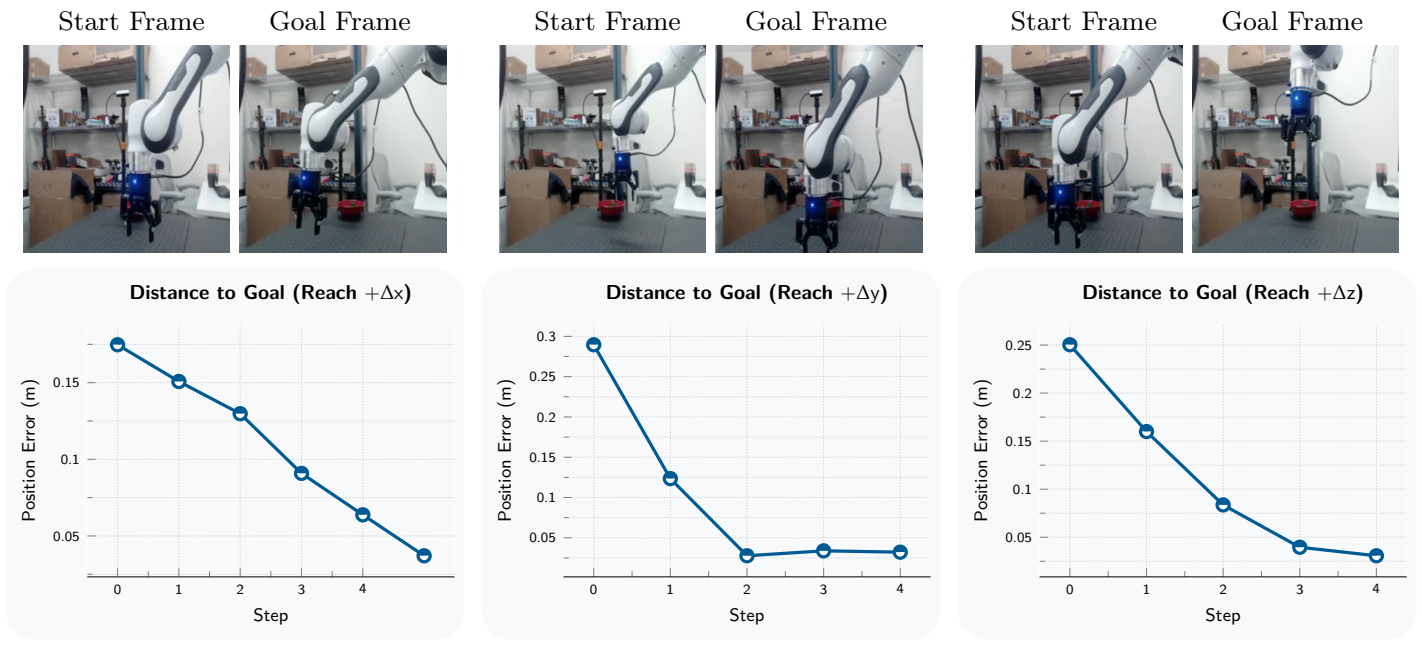
图 8:单目标到达。依据单目目标图像规划,每步最小化未来与目标特征的 L1 距离,执行第一行动后重规划;原文约束每个行动在半径 0.075 的 L1 球内,并称每步最大可减少约 0.13 m 距离。
图 9 扫描 Δx、Δy,固定 Δz = 0,展示单步笛卡尔行动的能量景观。最小值靠近真实行动,支持模型无需精密感知也能合理推断行动效果;景观相对平滑、局部凸,有利于规划。
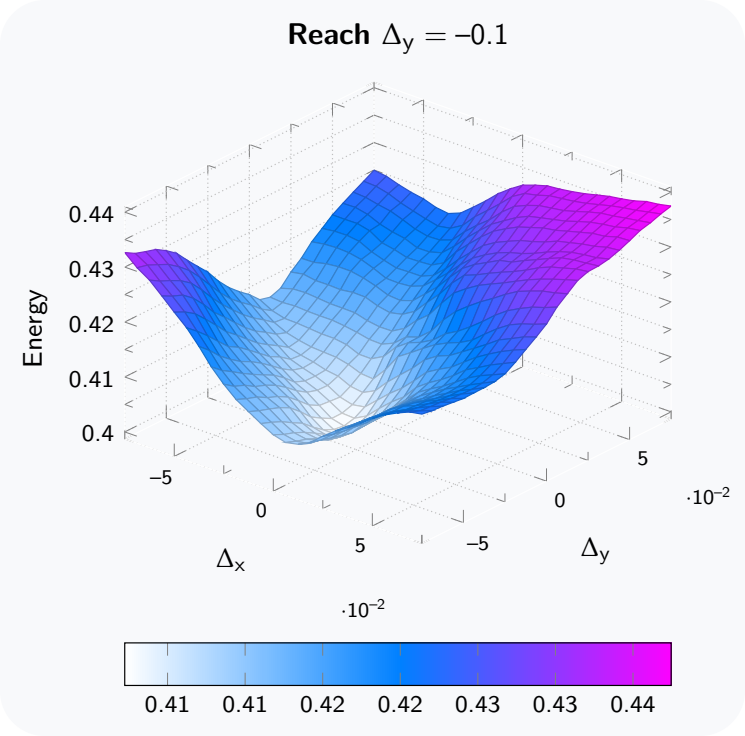
图 9:V-JEPA 2-AC 能量景观。目标相对起始帧的真实行动为 (Δx,Δy) = (0,−0.1);能量最低点约为 (0,−0.05),表明模型能合理估计行动效果,不要求精密感知。
抓持操作。更难的任务是抓取、带物体到达、拾取放置。表 2、3 报告每任务 10 次试验,在物体位置、初始姿态等变化下平均。抓取和带物到达给一个目标图像;拾取放置另给两个中间子目标:第一张物体被抓住,第二张物体接近期望位置,最后一张物体放好。模型对第一子目标优化 4 步,自动切换第二子目标 10 步,再最后目标 4 步。图 10 展示执行,实验室 1 全部任务起止帧见 B.2。
抓取需要视觉反馈下的精确夹持;带物到达需要持物运动并避免掉落;拾取放置检验组合这两种基本技能。所有模型到达成功率较高,涉及物体交互时差异更明显。成功率也取决于物体:杯子容易用一指伸入、夹住杯沿,但动作不准会错过;盒子可行抓取姿态较多,却需要夹爪充分打开。次优行动与不同物体的挑战共同影响成功率。V-JEPA 2-AC 在全部任务取得最高成功率,支持潜在规划用于机器人操作的可行性。
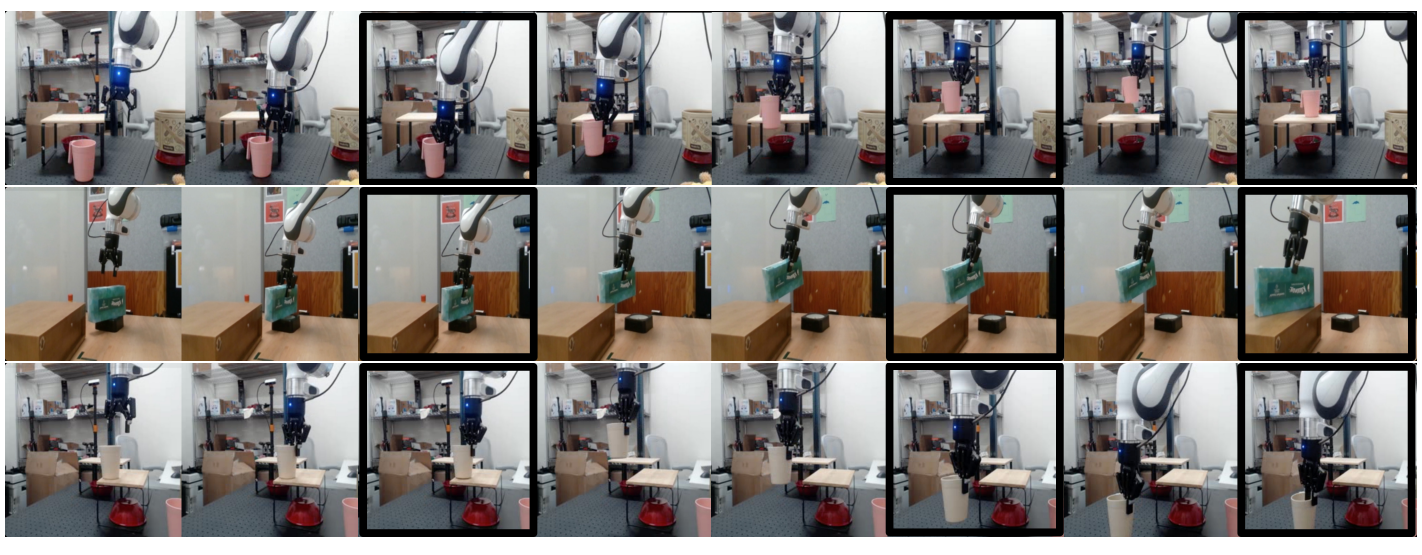
图 10:多子目标拾取放置的闭环执行。高亮帧表示达到子目标并切换:抓住物体、移到目标附近、放好。三个阶段分别为 4、10、4 步。机器人行动由目标条件规划推断;两个实验室、不同物体配置和杂乱环境中均展示零样本操作。
| 方法 | 实验室 | 到达 | 抓取:杯 | 抓取:盒 | 带物到达:杯 | 带物到达:盒 | 拾取放置:杯 | 拾取放置:盒 |
|---|---|---|---|---|---|---|---|---|
| Octo | Lab 1 | 100% | 20% | 0% | 20% | 70% | 20% | 10% |
| Octo | Lab 2 | 100% | 10% | 0% | 10% | 70% | 10% | 10% |
| Octo | 平均 | 100% | 15% | 0% | 15% | 70% | 15% | 10% |
| V-JEPA 2-AC (ours) | Lab 1 | 100% | 70% | 30% | 90% | 80% | 80% | 80% |
| V-JEPA 2-AC (ours) | Lab 2 | 100% | 60% | 20% | 60% | 70% | 80% | 50% |
| V-JEPA 2-AC (ours) | 平均 | 100% | 65% | 25% | 75% | 75% | 80% | 65% |
Cosmos 比较。两种世界模型都用单张 RTX 4090 和交叉熵方法,以潜在空间目标帧构造能量。Cosmos 每轮采样 80 个行动,优化 10 次,时域 1,单步耗时 4 分钟;到达成功率 80%,物体交互较弱,整段拾取放置需超过一小时。V-JEPA 2-AC 每轮采样多 10 倍,却只需 16 秒/行动,各项技能表现更高(表 3)。
| 方法(实验室 2) | 样本数 | 优化迭代 | 规划时域 | 每步时间 | 到达 | 抓取:杯 | 抓取:盒 | 拾取放置:杯 | 拾取放置:盒 |
|---|---|---|---|---|---|---|---|---|---|
| Cosmos | 80 | 10 | 1 | 4 min. | 80% | 0% | 20% | 0% | 0% |
| V-JEPA 2-AC (ours) | 800 | 10 | 1 | 16 sec. | 100% | 60% | 20% | 80% | 50% |
未来可增加规划算力,减少每步采样及优化次数,在世界模型想象中训练前馈策略以初始化搜索,或在 V-JEPA 2-AC 上采用梯度规划,降低两类模型的规划时间。
4.3. 局限
相机位置敏感性。模型依据末端笛卡尔行动预测下一帧表征,却没有显式相机校准,只能从单目画面隐式推断行动坐标轴。基座常不在画面中,使坐标轴推断欠定、导致预测错误。实际实验先人工尝试不同机位,再选择能贯穿实验的机位;量化分析见 B.4。
长时规划。首先,自回归滚动越长,表征预测准确性越低,误差积累使长期规划困难。其次,时域线性增长,候选行动轨迹数指数增长,搜索计算困难。而无需中间图像目标的拾取放置等非贪心任务又需要长时规划。进一步研究将帮助解决更复杂的任务。
图像目标。当前优化假设可获得视觉目标,沿用此前目标条件操作工作。野外部署时,用语言等形式指定目标可能更自然;让行动条件潜在模型与语言模型对齐,是向自然语言通用任务指定迈进的方向。
5. 理解:基于探针的分类
表征空间世界模型的能力,必然受限于表征所编码的状态信息。本节及后续检验 V-JEPA 2 表征。分类任务可偏外观或运动:外观任务通常单帧即可完成,即便标签叫行动;运动任务需要多帧(Goyal 等, 2017)。因此选 SSv2、Diving-48、Jester 评运动,K400、COIN、IN1K 评外观。结果显示 V-JEPA 2 的运动理解优于其他领先编码器,外观也有竞争力。
注意力探针。在冻结编码器输出上,使用各任务训练数据训练 4 层 Transformer;最后一块把自注意力改为可学习查询 token 的交叉注意力。推理按通常流程采样固定帧数的多个片段,平均类别 logits;分辨率近预训练。探针深度、片段数等见附录 C。
评估流程。比较带 registers 的 DINOv2(Darcet 等, 2024)、图文对比预训练 SigLIP2(Tschannen 等, 2025)和 Perception Encoder PEcoreG(Bolya 等, 2025),以及自监督 V-JEPA(Bardes 等, 2024)和以图文对比预训练为主的 InternVideo2s2-1B(Wang 等, 2024b)。同样冻结编码器并训练注意力探针。图像模型逐帧提特征后拼接;InternVideo2 在 ImageNet 用图像位置嵌入,视频中把位置嵌入从 4 帧插值到 8 帧,使 token 数近 V-JEPA 2。
虽采用共同评估流程,不同编码器的训练数据和协议不同,例如 DINOv2 用 LVD-142M,PEcoreG 用 MetaCLIP,不能直接归因比较,只能做系统层面的比较。表 4 还纳入文献中冻结评估但探针头可能不同的 VideoMAEv2、InternVideo-1B/6B、VideoPrism 结果。完整超参数见 C.1。
| 方法/评估分组 | 参数 | 平均 | SSv2(运动) | Diving-48(运动) | Jester(运动) | K400(外观) | COIN(外观) | IN1K(外观) |
|---|---|---|---|---|---|---|---|---|
| 文献报告结果 | — | — | — | — | — | — | — | — |
| VideoMAEv2 | 1B | -- | 56.1 | -- | -- | 82.8 | -- | 71.4 |
| InternVideo2-1B | 1B | -- | 67.3 | -- | -- | 87.9 | -- | -- |
| InternVideo2-6B | 6B | -- | 67.7 | -- | -- | 88.8 | -- | -- |
| VideoPrism | 1B | -- | 68.5 | 71.3 | -- | 87.6 | -- | -- |
| 相同流程评估:图像编码器 | — | — | — | — | — | — | — | — |
| DINOv2 | 1.1B | 81.1 | 50.7 | 82.5 | 93.4 | 83.6 | 90.7 | 86.1 |
| PEcoreG | 1.9B | 82.3 | 55.4 | 76.9 | 90.0 | 88.5 | 95.3 | 87.6* |
| SigLIP2 | 1.2B | 81.1 | 49.9 | 75.3 | 91.0 | 87.3 | 95.1 | 88.0 |
| 相同流程评估:视频编码器 | — | — | — | — | — | — | — | — |
| V-JEPA ViT-H | 600M | 85.2 | 74.3 | 87.9 | 97.7 | 84.5 | 87.1 | 80.0 |
| InternVideo2s2-1B | 1B | 87.0 | 69.7 | 86.4 | 97.0 | 89.4 | 93.8 | 85.8 |
| V-JEPA 2 ViT-L | 300M | 86.0 | 73.7 | 89.0 | 97.6 | 85.1 | 86.8 | 83.5 |
| V-JEPA 2 ViT-H | 600M | 86.4 | 74.0 | 89.8 | 97.7 | 85.3 | 87.9 | 83.8 |
| V-JEPA 2 ViT-g | 1B | 87.5 | 75.3 | 90.1 | 97.7 | 86.6 | 90.7 | 84.6 |
| V-JEPA 2 ViT-g₃₈₄ | 1B | 88.2 | 77.3 | 90.2 | 97.8 | 87.3 | 91.1 | 85.1 |
结果。ViT-g₂₅₆ 在运动任务明显优于其他编码器:SSv2 top-1 为 75.3,InternVideo 为 69.7,PEcoreG 为 55.4。ImageNet 达到 84.6,比 V-JEPA 高 4.6 点;六任务平均最高。更高分辨率、更长时长的 ViT-g₃₈₄ 各任务进一步改善,平均达 88.2。
6. 预测:基于探针的行动预判
行动预判是用行动开始前的上下文视频预测未来行动。我们在 Epic-Kitchens-100(EK100;Damen 等, 2022)上展示表现随模型规模持续提高;仅在表征上训练注意力探针,也显著超过此前专为预判设计的方法。
任务。EK100 含 45 个厨房环境中第一视角拍摄的 100 小时烹饪视频。每个行动片段有起止时间、行动标签;3568 个不同行动标签由 97 类动词、300 类名词组合。给行动开始前的上下文,预测名词、动词和联合行动类别;上下文结束与行动开始的间隔即预判时间,默认 1 秒。同一上下文可能对应多种未来,故采用按类别平均的 recall-at-5。
预判探针。冻结编码器、预测器,输入结束于行动前 1 秒的片段。预测器接收编码表征及 1 秒后帧的掩码 token,预测未来帧表征。编码器与预测器输出沿 token 维拼接,送入类似第 5 节的注意力探针;最后交叉注意力用三个查询,各接线性分类器,分别预测行动、动词、名词。各分类器独立 focal loss(Lin 等, 2017),相加后向共同注意力块反向传播。细节见 D.1。
基线。InAViT(Roy and Fernando, 2024)是显式建模手与物交互的监督方法;Video-LLaMA(Zhang 等, 2023)和 PlausiVL(Mittal 等, 2024)采用大语言模型。原文该句称参数“最多 70 亿”,但表 5 给 PlausiVL 80 亿,具体规模以表中数值及后续比较为准。
| 方法 | 参数 | 动词 | 名词 | 行动 |
|---|---|---|---|---|
| InAViT | 160M | 51.9 | 52.0 | 25.8 |
| Video-LLaMA | 7B | 52.9 | 52.0 | 26.0 |
| PlausiVL | 8B | 55.6 | 54.2 | 27.6 |
| 冻结主干 | — | — | — | — |
| V-JEPA 2 ViT-L | 300M | 57.8 | 53.8 | 32.7 |
| V-JEPA 2 ViT-H | 600M | 59.2 | 54.6 | 36.5 |
| V-JEPA 2 ViT-g | 1B | 61.2 | 55.7 | 38.0 |
| V-JEPA 2 ViT-g₃₈₄ | 1B | 63.6 | 57.1 | 39.7 |
结果。ViT-L、H、g 使用 256×256、8 fps、32 帧上下文,参数从 300M 到 1B;另报 384×384 的 g₃₈₄。行动 recall-at-5 随规模线性提高:L 为 32.7,g 为 38.0,增加 5.3 点;g₃₈₄ 又增加 1.7 点。即使 300M 模型也超过 8B 的 PlausiVL。g₃₈₄ 比 PlausiVL 增 12.1 点,相对提升 44%。
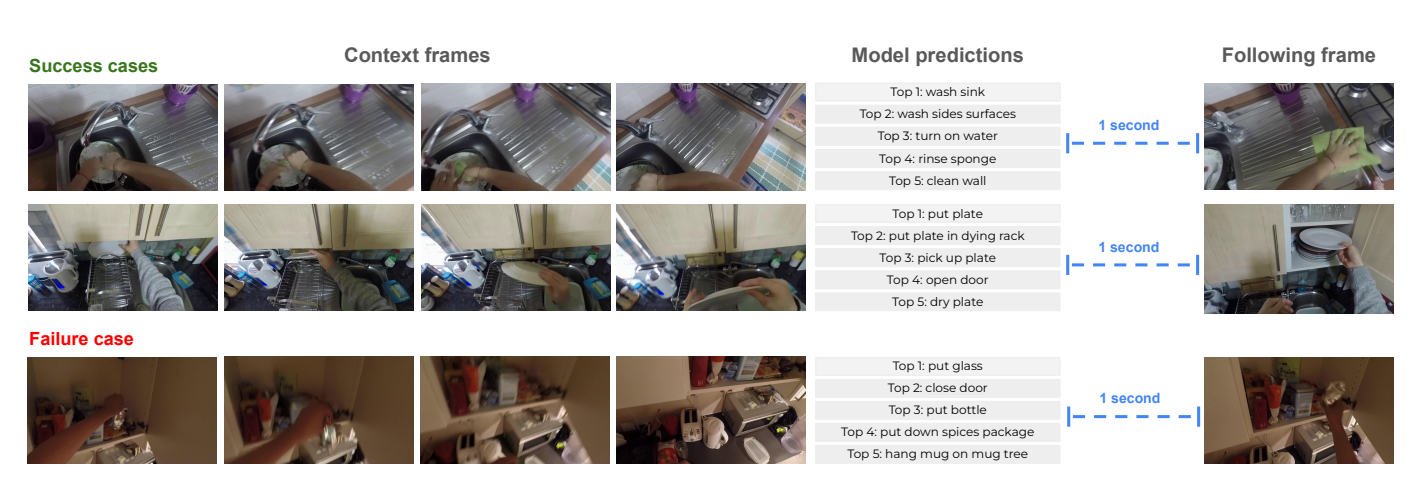
图 11:EK100 预测可视化。左:上下文中选取的四帧;中:按似然排列的模型预测;右:1 秒预判间隔后的帧。展示两个成功与一个失败例子。
7. 理解:视频问答/7.1. 实验设置
我们探索开放语言视频问答(VidQA)。用 V-JEPA 2 作为视觉编码器,采用 LLaVA 系列普及的非离散 token 早期融合结构(Wadekar 等, 2024;Li 等, 2024):把图像块嵌入投影到 LLM 输入空间,随后端到端训练或冻结视觉编码器训练。常见 VidQA 编码器是逐帧使用的图像编码器,如 CLIP、SigLIP、Perception Encoder,通常因图像描述预训练的语言语义对齐而被采用。据我们所知,这是首次用没有语言监督预训练的视频编码器训练 VidQA 的多模态大语言模型。
下游表现也高度依赖对齐数据。我们用近似 PerceptionLM(Cho 等, 2025)的 8850 万对图像或视频与文本。先在 1800 万子集的受控设置比较编码器(7.2),再扩大编码器和分辨率(7.3),最后用全体数据检验语言对齐极限(7.4)。受控设置已有竞争力,扩大数据后多个 VidQA 基准达到当时领先表现。
任务。PerceptionTest 检验记忆、抽象、物理、语义(Pătrăucean 等, 2023);MVP 用最小视频对减轻文本和外观偏差,检验物理世界理解(Krojer 等, 2024)。TempCompass、TemporalBench、TOMATO 检验时间理解和记忆。MVBench 检验一般理解但偏单帧外观;TVBench 被提出为减轻这种偏差的一般与时间理解替代基准。
视觉指令微调。沿 LLaVA 的做法(Liu 等, 2024b, 2024d),可学习的 MLP 投影器把视觉 token 转为 LLM 输入,渐进训练三阶段:第一阶段仅用图像描述训练投影器;第二阶段用大规模图像问答训练完整模型;第三阶段继续用大规模视频描述及问答。视觉编码器可以冻结或一同微调:冻结更清晰地测特征质量,微调则总体效果更好。完整流程见附录 E。
7.2. 与图像编码器比较
为隔离视觉编码器贡献,用相同 LLM 和训练设置训练不同编码器的 MLLM。受控设置使用 Qwen2-7B-Instruct(Yang 等, 2024b)、冻结视觉编码器及 1800 万对齐样本。比较 512×512 预训练的 V-JEPA 2 与 DINOv2、SigLIP2、Perception Encoder。
| 方法 | 编码器/LLM 参数 | 平均 | PerceptionTest(验证集 SFT) | MVP(成对准确率) | TempCompass(选择题) | TemporalBench(MBA-short QA) | TVBench | TOMATO | MVBench |
|---|---|---|---|---|---|---|---|---|---|
| DINOv2 ViT-g₅₁₈ | 1.1B/7B | 45.7 | 67.1 | 22.4 | 62.3 | 26.8 | 47.6 | 32.0 | 61.8 |
| SigLIP2 ViT-g₃₈₄ | 1.1B/7B | 48.1 | 72.4 | 26.2 | 66.8 | 25.7 | 48.7 | 33.2 | 64.0 |
| PE ViT-G/14₄₄₈ | 1.9B/7B | 49.1 | 72.3 | 26.7 | 67.0 | 27.5 | 51.6 | 34.0 | 64.7 |
| V-JEPA 2 ViT-g₅₁₂ | 1B/7B | 52.3 | 72.0 | 31.1 | 69.2 | 33.3 | 55.9 | 37.0 | 67.7 |
除 PerceptionTest 略低于 SigLIP2 和 PE 外,V-JEPA 2 在所测基准均较好,MVP、TemporalBench、TVBench 等时间理解任务更明显。仅改变视觉编码器,就显示无语言监督预训练的视频编码器也可超过有语言监督的编码器,挑战已有看法(Tong 等, 2024;Li 等, 2024;Liu 等, 2024a;Yuan 等, 2025)。视频编码器相较图像编码器改善时空理解,说明需要发展更好的视频编码器。
7.3. 扩大视觉编码器和输入分辨率
此前研究(Fan 等, 2025)显示,对自监督图像编码器,扩大视觉编码器和分辨率可改善 VQA。我们把 V-JEPA 2 从 300M 扩到 1B、分辨率从 256 到 512,结果见表 7。固定 256 分辨率时,PerceptionTest 增 0.9 点、TVBench 增 3.3 点、MVBench 增 1.2 点;再升到 512,PerceptionTest 另增 2.2 点、TemporalBench 增 4.0 点、TVBench 增 3.3 点,支持进一步扩展。
| 方法 | 编码器/LLM 参数 | 平均 | PerceptionTest(验证集 SFT) | MVP(成对准确率) | TempCompass(选择题) | TemporalBench(MBA-short QA) | TVBench | TOMATO | MVBench |
|---|---|---|---|---|---|---|---|---|---|
| V-JEPA 2 ViT-L₂₅₆ | 300M/7B | 51.7 | 74.6 | 32.3 | 70.1 | 30.2 | 50.9 | 36.5 | 67.1 |
| V-JEPA 2 ViT-H₂₅₆ | 600M/7B | 52.0 | 74.7 | 30.6 | 70.9 | 29.8 | 54.6 | 35.1 | 68.0 |
| V-JEPA 2 ViT-g₂₅₆ | 1B/7B | 52.3 | 75.5 | 31.9 | 70.7 | 28.3 | 54.2 | 37.3 | 68.3 |
| V-JEPA 2 ViT-g₃₈₄ | 1B/7B | 54.0 | 76.5 | 33.0 | 71.7 | 33.1 | 56.5 | 39.0 | 68.5 |
| V-JEPA 2 ViT-g₅₁₂ | 1B/7B | 54.4 | 77.7 | 33.7 | 71.6 | 32.3 | 57.5 | 38.5 | 69.5 |
7.4. 扩大数据以改善领先水平
明确受控设置能力后,把 MLLM 数据由 1800 万扩大到 8850 万,即 4.7 倍。较高分辨率增加 LLM 输入的视觉 token,因此选择每帧 288 个视觉 token 的 ViT-g₃₈₄。沿用 PerceptionLM 训练方案,以 Llama 3.1 为主干,使用无池化 MLP 投影器简化训练,详见 E.3。
| 方法 | 编码器/LLM 参数 | 平均 | PerceptionTest(测试集) | MVP(成对准确率) | TempCompass(选择题) | TemporalBench(MBA-short QA) | TOMATO | TVBench | MVBench |
|---|---|---|---|---|---|---|---|---|---|
| InternVL-2.5 | 300M/7B | 52.1 | 68.9 | 39.9 | 68.3 | 24.3 | 29.4 | 61.6 | 72.6 |
| Qwen2VL | 675M/7B | 47.0 | 66.9 | 29.2 | 67.9 | 20.4 | 31.5 | 46.0 | 67.0 |
| Qwen2.5VL | 1B/7B | 49.7 | 70.5 | 36.7 | 71.7 | 24.5 | 24.6 | 50.5 | 69.6 |
| PLM 8B | 1B/8B | 56.7 | 82.7 | 39.7 | 72.7 | 28.3 | 33.2 | 63.5 | 77.1 |
| V-JEPA 2 ViT-g₃₈₄ LLama 3.1 8B | 1B/8B | 59.5 | 84.0 | 44.5 | 76.9 | 36.7 | 40.3 | 60.6 | 73.5 |
扩大数据改善各下游基准,在 PerceptionTest、MVP、TempCompass、TemporalBench、TOMATO 达到当时最先进水平。相较 PerceptionLM 8B,分别增 1.3、4.8、4.2、8.4、7.1 点。V-JEPA 2 未超过 PerceptionLM 的 TVBench、MVBench,但明显高于 InternVL 2.5、Qwen2VL、Qwen2.5VL。这强调视觉与语言对齐需要扩大数据,也证明无语言监督预训练编码器可在充分规模下达到领先结果。
9. 结论
本研究展示联合嵌入预测架构可从网络规模数据和少量机器人交互中自监督学习,形成具理解、预测、规划能力的世界模型。V-JEPA 2 在需要运动理解的行动分类、人类行动预判上表现领先,与 LLM 对齐后的视频问答也优于此前编码器。其表征经行动条件后训练形成 V-JEPA 2-AC,可在实体机器人上零样本完成拾取放置等抓持操作,向有效感知并行动的高级 AI 迈进一步。
未来工作。当前任务需要预测未来约 16 秒,单图目标可完成较简单的抓取、带物到达;无需子目标的拾取放置和更复杂长时任务仍需要建模创新。跨空间与时间尺度、不同抽象层次的层级模型值得探索。
其次,V-JEPA 2-AC 当前按图像目标指定任务;某些情形更适合语言。让模型把语言目标嵌入相应表征空间,是重要方向,第 7 节语言对齐可作起点。最后,本工作只扩大到约 1B 参数,已有稳定收益;此前视觉编码器曾到 20B(Zhai 等, 2022;Carreira 等, 2024),还需研究可持续扩大、保持性能收益的预训练方案。
致谢
我们感谢 Rob Fergus、Joelle Pineau、Stephane Kasriel、Naila Murray、Mrinal Kalakrishnan、Jitendra Malik、Randall Balestriero、Julen Urain、Gabriel Synnaeve、Michel Meyer、Pascale Fung、Justine Kao、Florian Bordes、Aaron Foss、Nikhil Gupta、Cody Ohlsen、Kalyan Saladi、Ananya Saxena、Mack Ward、Parth Malani、Shubho Sengupta、Leo Huang、Kamila Benzina、Rachel Kim、Ana Paula Kirschner Mofarrej、Alyssa Newcomb、Nisha Deo、Yael Yungster、Kenny Lehmann、Karla Martucci,以及 PerceptionLM 团队,包括 Christoph Feichtenhofer、Andrea Madotto、Tushar Nagarajan、Piotr Dollar,为本项目提供反馈和支持。
附录 A. V-JEPA 2 预训练/A.1. 超参数
如第 2.4 节,训练由恒定学习率与降温两阶段组成。所有模型先训练到 IN1K、COIN、SSv2 表现平台或下降,再开始降温。第一阶段先预热 12,000 步,随后保持学习率;每 60,000 步评估一次。降温从 5.25×10⁻⁴ 线性降低到最终学习率,两阶段其他超参数固定。
| 参数 | 主要训练阶段 | 降温阶段 |
|---|---|---|
| 帧数 | 16 | 64 |
| 帧率(fps) | 4.0 | 4.0 |
| 裁剪尺寸 | 256 | [256, 384, 512] |
| 随机缩放宽高比 | [0.75 1.35] | [0.75, 1.35] |
| 随机缩放比例 | [0.3, 1.0] | [0.3, 1.0] |
| 训练步数 | 可变 | 12000 |
| 预热步数 | 12000 | N/A |
| 全局批量大小 | 3072 | 3072 |
| 起始学习率 | 1e-4 | 5.25e-4 |
| 最终学习率 | 5.25e-4 | 1e-6 |
| 权重衰减 | 0.04 | 0.04 |
| EMA | 0.99925 | 0.99925 |
| 空间掩码比例 | [0.15, 0.7] | [0.15, 0.7] |
| 时间掩码比例 | [1.0, 1.0] | [1.0, 1.0] |
| 掩码宽高比 | [0.75 1.5] | [0.75, 1.5] |
| 时间块长度 | 2 | 2 |
| 图像块尺寸 | 16 | 16 |
降温保持 fps 不变,增加片段帧数,也增大裁剪尺寸。IN1K 从 256 裁剪的 84.6 提高到 384 裁剪的 85.1,两阶段设置见表 9。
附录的“缩短方案”指沿用 Bardes 等(2024)的 90,000 步训练。它与主方案区别在于:预热后余弦衰减学习率;权重衰减与 EMA 从起始值线性升到最终值;总步数限制为 90,000。数据混合消融用此方案,在较少算力下检验整理效果。
| 参数 | 缩短训练方案 |
|---|---|
| 帧数 | 16 |
| 帧率(fps) | 4.0 |
| 裁剪尺寸 | 256 |
| 随机缩放宽高比 | [0.75 1.35] |
| 随机缩放比例 | [0.3, 1.0] |
| 训练步数 | 90000 |
| 预热步数 | 12000 |
| 全局批量大小 | 3072 |
| 起始学习率 | 2e-4 |
| 学习率 | 6.25e-4 |
| 最终学习率 | 1e-6 |
| 起始权重衰减 | 0.04 |
| 最终权重衰减 | 0.4 |
| 起始 EMA | 0.999 |
| 最终 EMA | 1.0 |
| 空间掩码比例 | [0.15, 0.7] |
| 时间掩码比例 | [1.0, 1.0] |
| 掩码宽高比 | [0.75 1.5] |
| 时间块长度 | 2 |
| 图像块尺寸 | 16 |
A.2. 预训练数据
先用 PySceneDetect 在场景切换处分割 YT1B,丢弃不足 4 秒的场景,保留 3.16 亿场景。DINOv2 ViT-L 编码每段中间帧,按 Oquab 等(2023)的策略聚为 150 万簇。目标分布中的全部视频也按相同方式取嵌入,分配到最近 YT1B 簇;只保留至少有一个目标视频分配的簇,约 21 万簇、1.15 亿场景。
聚类检索匹配了目标分布的支持集,却未匹配权重。我们加权采样再平衡:w[c] = Σ[d=1…D] w[d] × N[d,c] / N[d]。w[c] 为第 c 簇权重,w[d] 为第 d 个目标数据集权重(表 11),N[d,c] 为该目标集落在该簇的样本数,N[d] 为目标集总样本数,D 为目标集个数。检索权重大致按各目标集检索到的场景数设置,并额外提高 EpicKitchen 权重,使统计更贴近人工整理数据集;单独使用整理后 YT1B,理解任务明显优于未整理版本。
| 检索目标 | 聚类数 | 场景数 | 检索权重 |
|---|---|---|---|
| 未整理 YT1B | 1.5M | 316M | — |
| K710 | 170k | 100M | 0.7 |
| SSv2 | 41k | 19M | 0.125 |
| COIN | 37k | 21M | 0.125 |
| EpicKitchen | 4k | 13k | 0.05 |
| 最终整理数据(含重复) | 210k | 115M | — |
整体更偏 K710 检索到的簇,加上 0.7 的检索权重,使数据较偏 Kinetics,也反映在消融的 K400 表现中(A.4.1)。最终将整理后 YT1B 与 SSv2、Kinetics、HowTo100M、ImageNet 合成 VM22M,如正文表 1。
A.3. 模型规模
架构见表 12。所有模型为 ViT,标准空间图像块 16×16。扩大模型时,编码器由 300M 的 ViT-L 到 1B 的 ViT-g,预训练各实验中预测器规模保持固定。
| 模型/组件 | 参数 | 宽度 | 深度 | 注意力头 | MLP | 嵌入器 |
|---|---|---|---|---|---|---|
| 编码器 Eθ(·) | — | — | — | — | — | — |
| ViT-L | 300M | 1024 | 24 | 16 | 4096 | 2×16×16 步长卷积 |
| ViT-H | 600M | 1280 | 32 | 16 | 5120 | 2×16×16 步长卷积 |
| ViT-g | 1B | 1408 | 40 | 22 | 6144 | 2×16×16 步长卷积 |
| 预测器 Pφ(·) | — | — | — | — | — | — |
| ViT-s | 22M | 384 | 12 | 12 | 1536 | N.A. |
A.4. 更多结果/A.4.1. 数据整理的影响
表 13 用缩短方案,在 ViT-L、ViT-g 规模比较部分分类任务。较小 ViT-L 单独用整理后 YT1B,比未整理版本全面改善;但加入图像和人工选择视频的混合设置中,部分任务反而下降:VM22M(混合 + 整理后 YT1B)在 SSv2 为 72.8,混合 + 未整理 YT1B 为 73.3。有时只用整理后 YT1B 还超过混合数据,如 COIN 86.5 对 86.25、K400 84.6 对 83.7。这有些意外,因为混合数据里加入 K710 并未让 K400 超过仅用整理后 YT1B。
| 训练数据/模型 | IN1K | COIN | SSv2 | K400 |
|---|---|---|---|---|
| ViT-L | — | — | — | — |
| 未整理 YT1B | 80.6 | 83.2 | 70.9 | 82.9 |
| 整理后 YT1B | 80.8 | 86.5 | 73.1 | 84.6 |
| 混合数据 + 未整理 YT1B | 82.9 | 86.25 | 73.3 | 83.0 |
| VM22M | 82.9 | 86.0 | 72.8 | 83.7 |
| ViT-g | — | — | — | — |
| 未整理 YT1B | 81.8 | 86.4 | 73.6 | 85.1 |
| 整理后 YT1B | 81.7 | 88.4 | 74.8 | 86.5 |
| 混合数据 + 未整理 YT1B | 83.7 | 88.5 | 75.5 | 85.9 |
| VM22M | 83.9 | 89.2 | 75.6 | 86.2 |
这种现象并非跨规模固定。ViT-g 上,VM22M 在所有任务超过混合 + 未整理 YT1B。长训练下差别也存在(图 12):两个模型起初提升相似,约第 600 epoch 后开始分离,未整理数据模型不再提升。
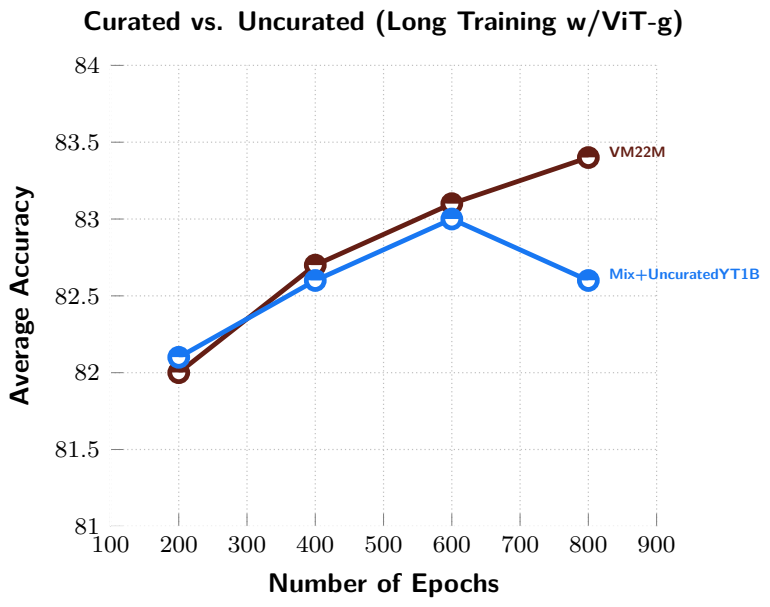
图 12:数据整理对预训练的影响。以预训练 epoch 为横轴,每 epoch 相当于 300 次优化,纵轴为 IN1K、COIN、SSv2、K400 平均表现。两种数据的模型在约 600 epoch 前接近,之后使用未整理 YT1B 的模型表现开始下降。
A.4.2. 长训练与降温的影响
表 14 展示两阶段训练效果。与表 13 的 ViT-g 相比,降温前恒定学习率日程不如缩短方案。主要收益出现在降温阶段,同时使用 64 帧预训练和下降学习率;原文概括为各项评估超过一个点的明显收益,具体数值见表。
| 训练阶段 | IN1K | COIN | SSv2 | K400 |
|---|---|---|---|---|
| 阶段 1(第 800 epoch,无降温) | 83.8 | 89.1 | 75.1 | 85.8 |
| 阶段 2(降温,256×256) | 84.6 | 90.7 | 75.3 | 86.6 |
| 阶段 2(降温,384×384) | 85.1 | 90.2 | 76.5 | 87.3 |
译者注:表 14 的部分任务增量不足一个点,例如 SSv2 的 75.1 到 75.3;不将作者的概括扩大为每个表中任务都超过一个百分点。
A.4.3. 评估时视频长度的影响
图 13 检验输入时长对下游表现的影响。模型已用 64 帧预训练,评估由 16 到 64 帧,平均增 9.7 个百分点。受显存限制,本消融每视频只采一个片段,采用单片段评估,区别于标准多片段设置。
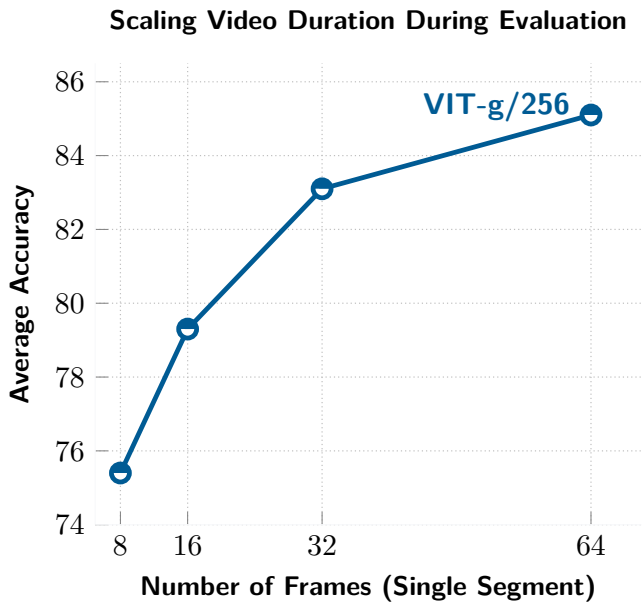
图 13:评估视频时长的影响。全部使用以 64 帧、256×256 降温的 ViT-g;受内存限制只评单片段。推理增加帧数,平均表现最多提升 9.7 点。
附录 B. V-JEPA 2-AC 后训练/B.1. 超参数
使用 AdamW(Loshchilov and Hutter, 2017)及预热—恒定—衰减学习率,固定权重衰减 0.04。4500 次迭代将学习率由 7.5×10⁻⁵ 线性升至 4.25×10⁻⁴,保持 85,500 次,最后 4500 次降至 0。批量 256,Droid 原始轨迹随机采样 4 秒、4 fps 视频。
只训练 Droid 的左侧外部相机视图。也可用右侧,但没有额外相机位置条件时,混用左、右视图会降低表现。为简便丢弃不足 4 秒视频,剩余训练视频少于 62 小时;随机缩放裁剪的宽高比范围为 0.75–1.35。
B.2. 机器人任务定义
图 14 展示实验室 1 杯子抓持任务的起止帧。抓取、带物到达只给一个目标图像;拾取放置另有两个子目标,分别为抓住、接近目标位置,最终为放好。三个阶段分别优化 4、10、4 步,自动切换。规划用 800 样本,按上一迭代最好的 10 个样本细化,共 10 次细化,规划时域为 1。任务较贪心,所以短时域足够;更长时域也能工作,但规划更慢。
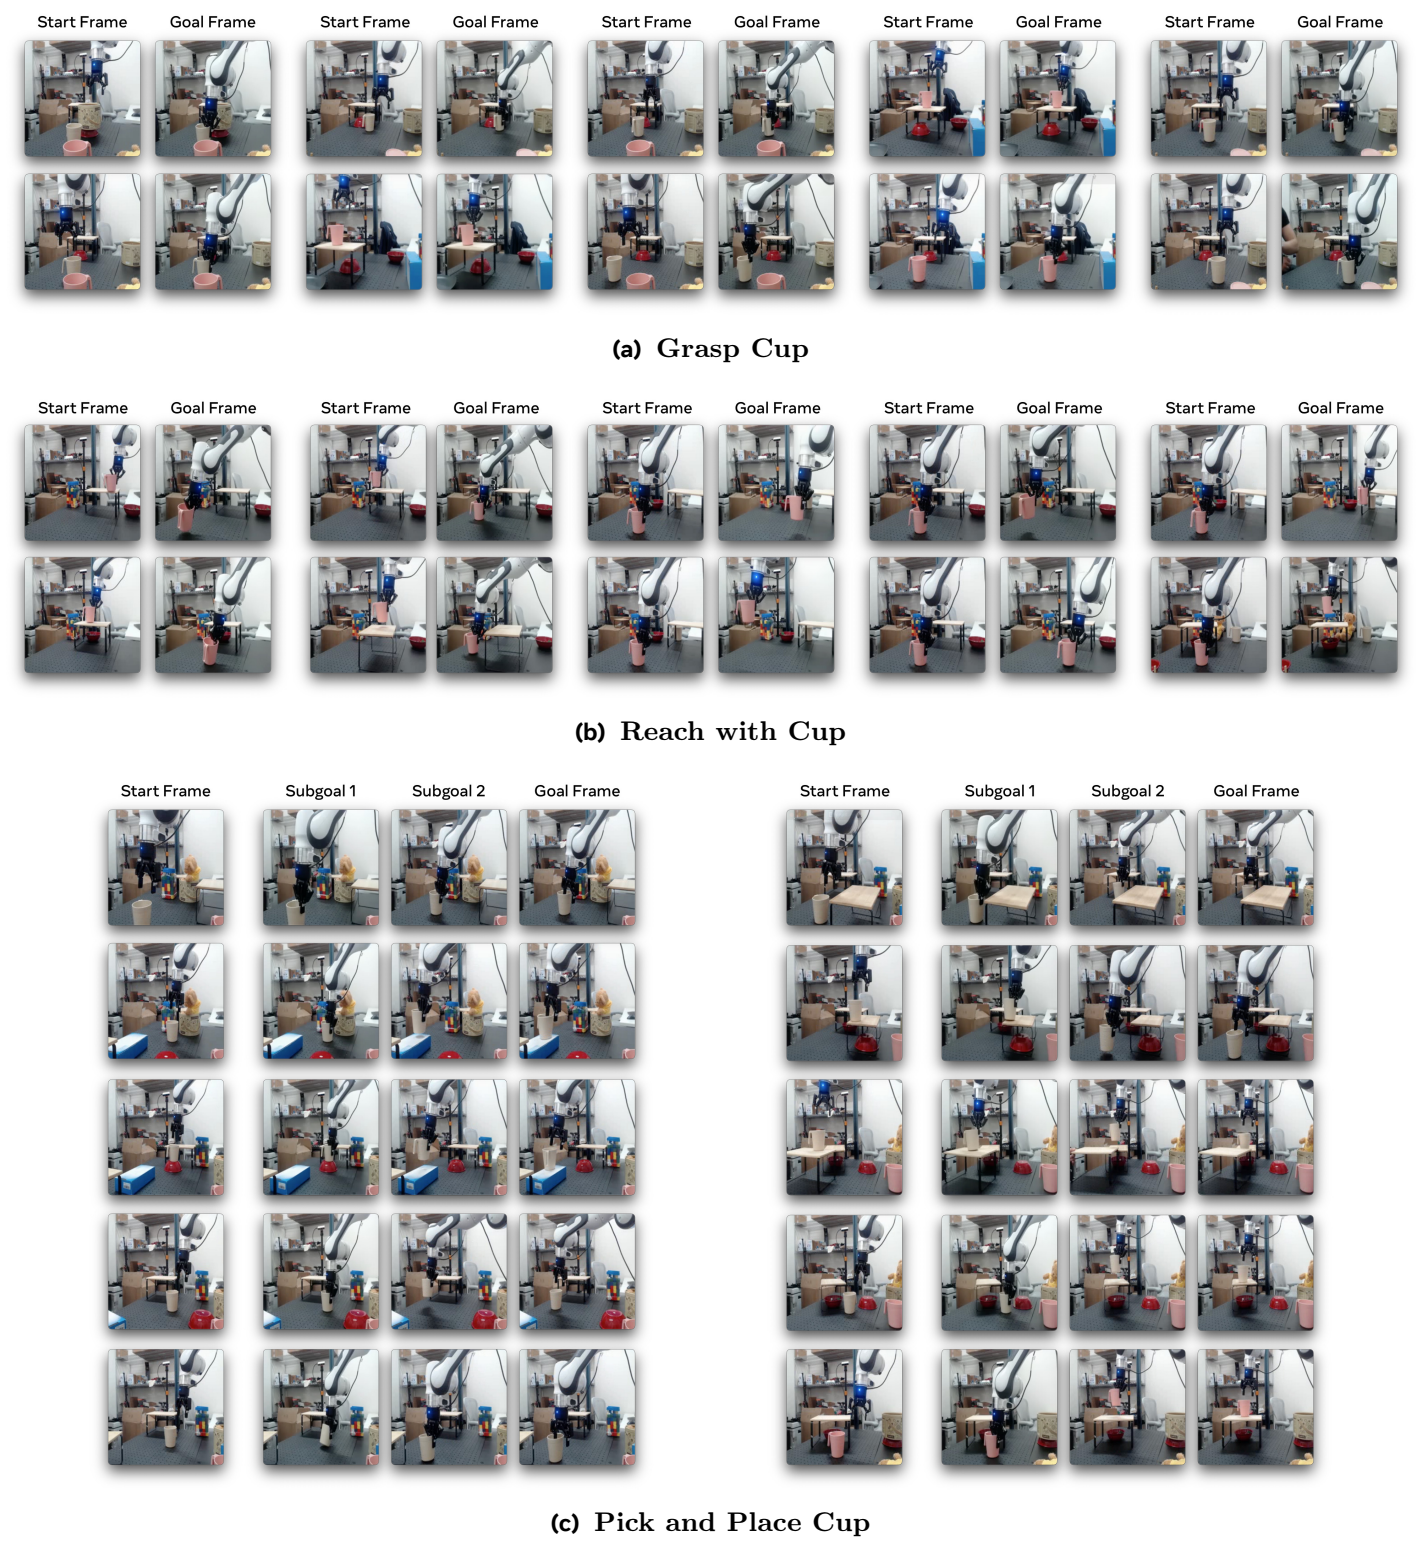
图 14:实验室 1 中用杯子的抓持任务定义。抓取、带物到达给单图目标;拾取放置给两张中间目标与最终目标,阶段步数依次 4、10、4。
B.3. 世界模型预测的可视化
为把预测转为可理解的像素,我们在 Droid 上训练帧解码器。冻结 V-JEPA 2 编码四帧片段,分别解码每帧,用均方(L2)像素重建损失更新解码器。它是完全确定性、没有内部采样的前馈 ViT-L,输出 256×256×3。AdamW 训练 150,000 步,权重衰减 0.1、梯度裁剪 1.0、每批 1024 帧;学习率 2000 步预热到 5×10⁻⁴ 后余弦衰减。
推理把在编码器表征上训练的解码器,直接用于 V-JEPA 2-AC 预测器输出。选择简单前馈、逐帧解码,而非视频级解码,是为了作为解释工具分析不同机器人行动序列的滚动结果。
图 15a 上行为实验室机器人真实轨迹,中行为每帧编码后解码,下行为只给初始帧及真实行动序列的自回归预测,再解码。中行表明编码器捕捉视觉控制的重要信息,背景模糊部分可能来自解码器容量低。下行能让机器人运动,同时保持背景及没有交互的架子等物体不变。闭合夹爪时,模型正确预测杯子随机械臂移动,体现物体恒常性、形状恒常性和重力等直观物理;但末帧杯子比真实位置略低,显示误差积累。
图 15b 使用相同动作序列,只改变夹爪闭合或打开;打开时,模型预测杯子位置随时间保持不变。
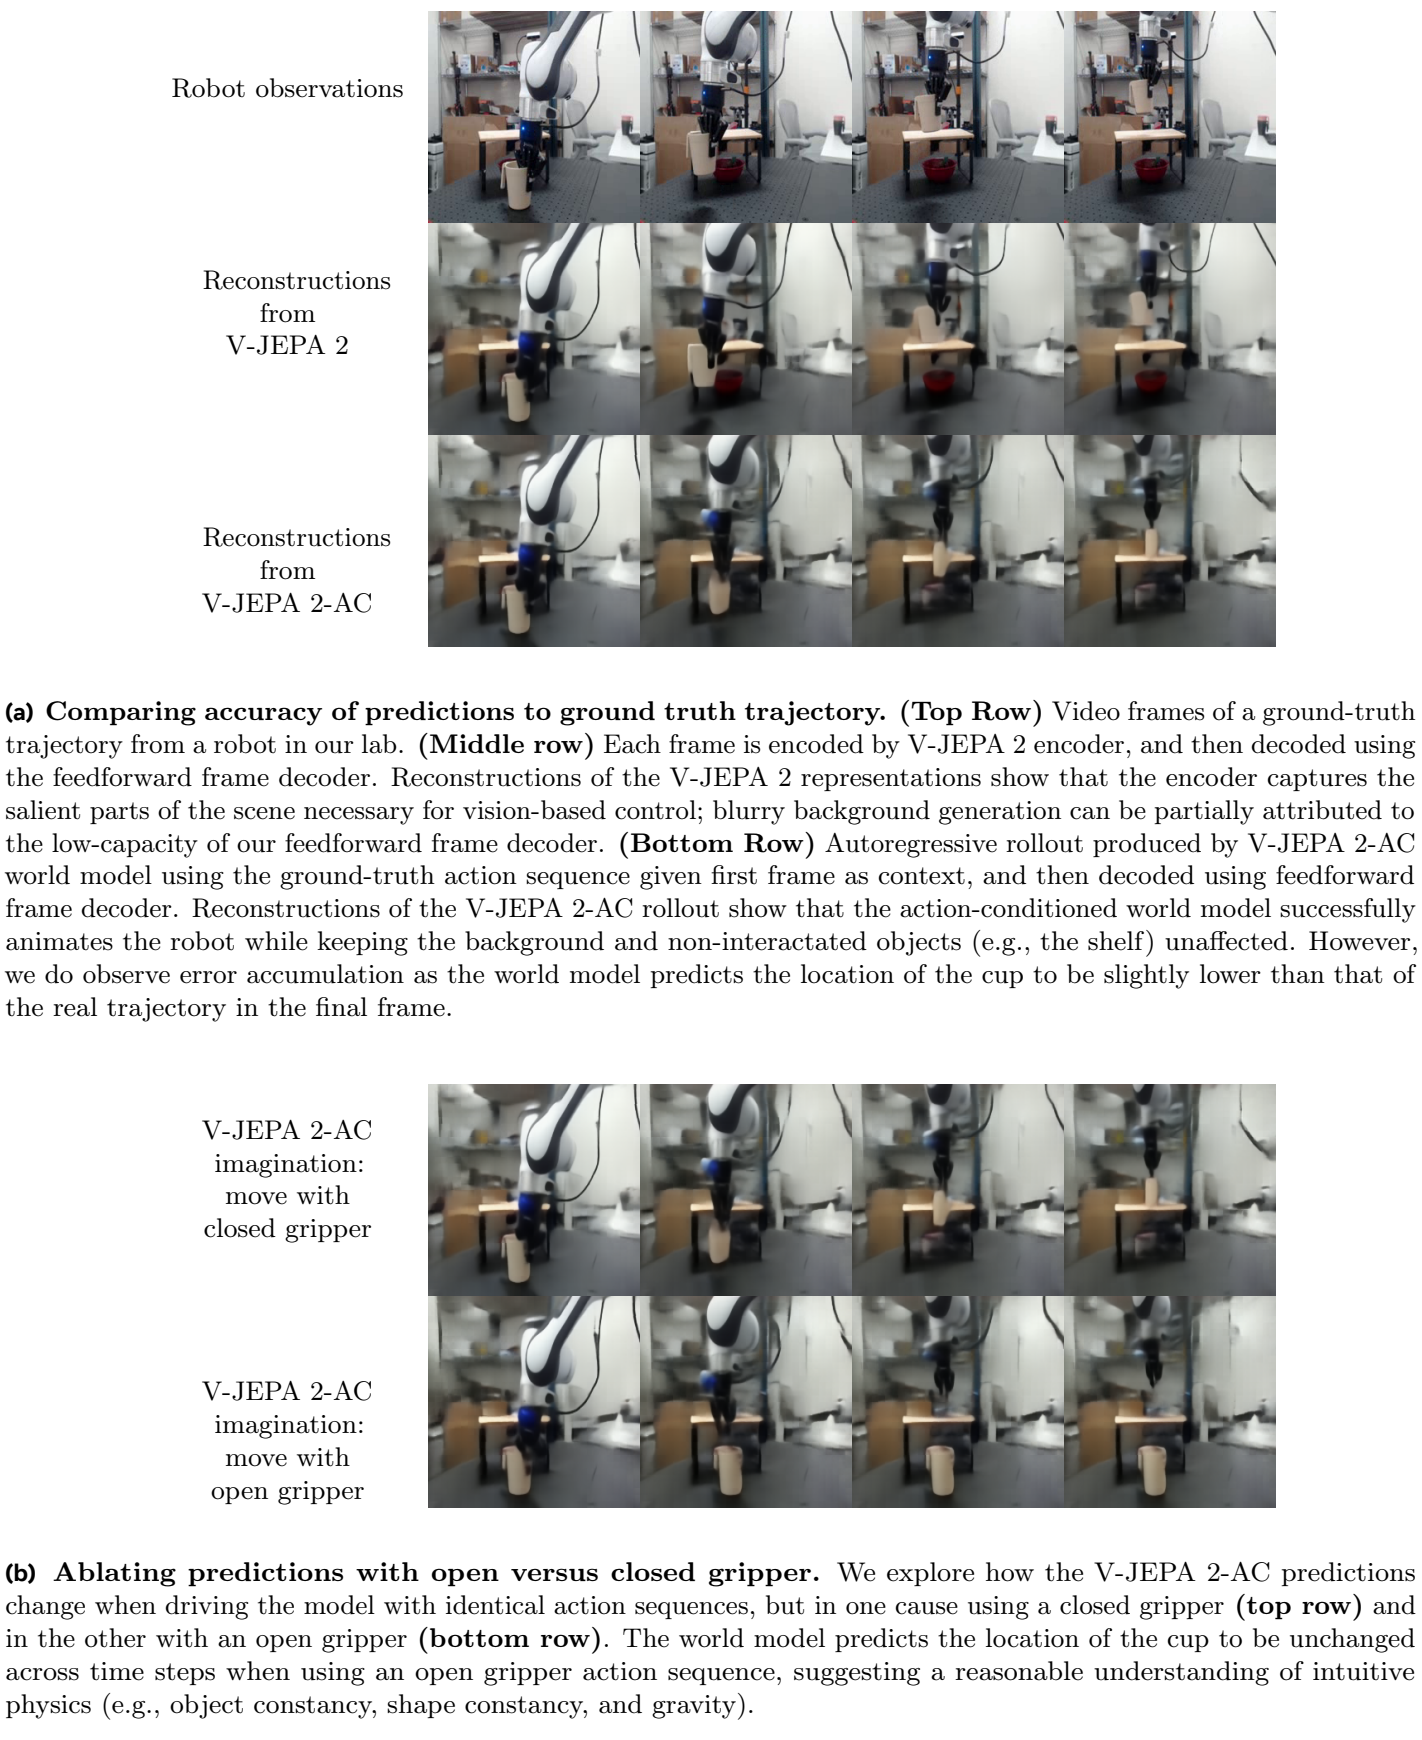
图 15:表征解码。解码器将 V-JEPA 2 表征映为像素,以均方重建损失在 Droid 上训练,完全确定性且无采样。a:上行真实观测,中行编码器重建,下行给定真实行动的 V-JEPA 2-AC 自回归滚动;能保持背景并预测杯子运动,但末帧杯子稍低。b:相同行动下,上行闭合、下行打开夹爪;打开时杯子不随之移动。
B.4. 相机位置敏感性
实际实验先手动试机位,选定后全部任务保持同一位置。本节量化机位敏感性:理想情况下推断的行动坐标轴不应随相机变,但实验显示会变,较大坐标误差会降低任务成功率。
机位用绕桌面中心的顺时针角度描述,0° 在机器人基座,90° 在基座左侧。因训练用 Droid 左侧外部相机,测试约 35°–85°。每机位收集 201 步水平 x-y 平面随机运动,对相邻帧用一步滚动能量最小化推断最优行动,形成实际与推断的 200 对行动,只看 Δx、Δy。设推断行动 A、真实行动 B 均为 ℝ^(200×2),解:
W* = argmin[W ∈ ℝ^(2×2)] ‖AW − B‖₂。
各机位平均绝对预测误差约 1.6 cm,相对于约 5 cm 的真实姿态变化,提示系统性误差。各 W* 的条件数约 1.5,除固定缩放系数后近似旋转矩阵,可用左、右奇异向量 U、V 得到 W̄* := UVᵀ,并以 W* ≈ W̄* = [[cos θ, −sin θ], [sin θ, cos θ]] 计算坐标轴旋转误差。
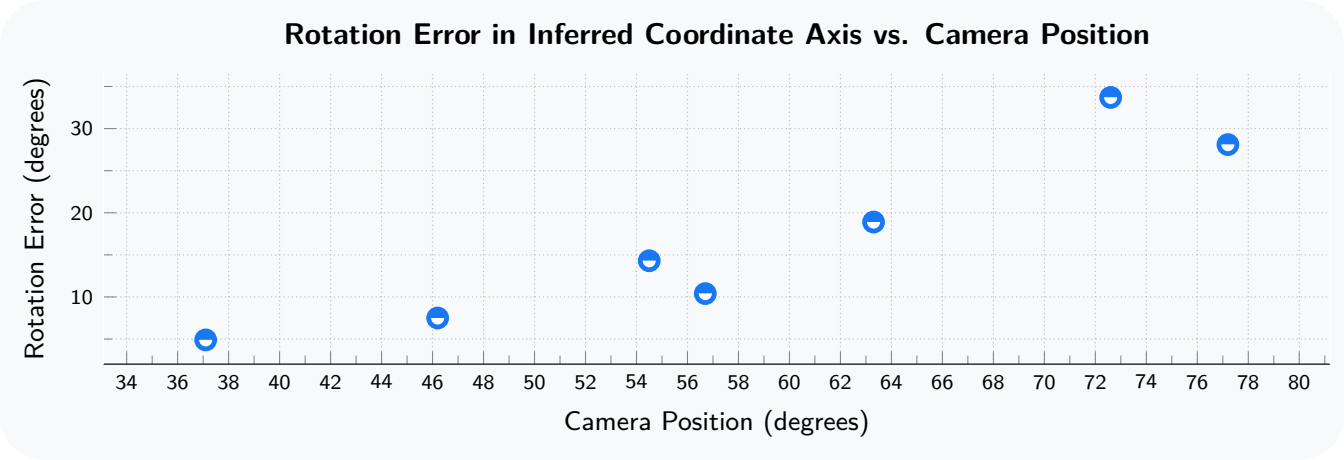
图 16:相机位置与推断行动坐标轴在 x-y 平面的旋转误差。0° 为基座处、90° 为基座左侧。理想应保持不变,实际存在机位敏感性。
图 16 显示旋转误差近似是相机位置的线性函数。单目标到达(图 8)中,视觉反馈仍可把机械臂移到距目标不足 4 cm,但旋转误差使各步行动次优,距离虽单调下降,却不是最大可能下降。
因为主要是旋转误差,可以用这种方法“校准”世界模型:机器人执行随机行动,比较推断与实际行动求线性最小二乘,再在执行时先用旋转矩阵变换推断行动后送给控制器。这个无监督校准想法很有意思,但我们强调:本论文实验没有做这种校准。
附录 C. 视觉分类/C.1. 超参数
本附录详细介绍第 5 节分类评估。探针由四个 Transformer 块组成,每块 16 头;前三块标准自注意力,最后为带可学习查询 token 的交叉注意力,其输出以残差加回查询,再做 LayerNorm、单 GeLU 的 MLP,最后接线性分类器。
评估。除 ViT-g₃₈₄,所有模型共同使用 256×256。每视频采多个时间片段,验证时每段取三个空间视图,训练只取一个。默认 SSv2 为 16×2×3、K400 16×8×3、COIN 32×8×3、Diving-48 与 Jester 32×4×3。g₃₈₄ 在 K400、COIN、Diving-48、Jester 用 384×384,在 ImageNet 用 512×512,SSv2 用 384×384、64×2×3。
译者注:正文表 4 图注概括 g₃₈₄ 六任务都使用 384×384,附录这里明确 ImageNet 用 512×512;两处各保留原文口径。
ImageNet。把单张图像复制成 16 帧;全局批量为 1024,区别于 256 或 128;不采用多片段、多视图。Jester 与 Diving-48 采用多层策略:读取编码器最后层和三个中间层(表 16),对全部 token 做注意力。只训练 3 个分类头,其他评估通常 20 个;训练 100 epoch 而非 20,因为它们更受益于长训练;批量 128。
优化。每次同时训练多个学习率、权重衰减不同的分类头,报告表现最好的准确率。Kinetics、SSv2、COIN、ImageNet 一般训练 20 epoch、20 个头,组合五个学习率和四个权重衰减;学习率余弦衰减。超参数见表 15。
| 参数 | 默认(K400) | ImageNet | SSv2 | COIN | Jester/Diving-48 |
|---|---|---|---|---|---|
| 帧数 | 16 | 16 | 16 | 32 | 32 |
| 每视频片段数 | 8 | 1 | 2 | 8 | 4 |
| 每片段视图数 | 3 | 1 | * | * | * |
| 取帧间隔 | 4 | n/a | * | * | 2 |
| 训练轮数 | 20 | * | * | * | 100 |
| 全局批量大小 | 256 | 1024 | * | 128 | 128 |
| 分辨率 | 256×256 | * | * | * | * |
| 分类器头数 | 20 (4x5) | * | * | * | 3 (3x1) |
| 分类器学习率 | [5e-3 3e-3 1e-3 3e-4 1e-4] | * | * | * | [1e-3 3e-4 1e-4] |
| 分类器权重衰减 | [.8 .4 .1 .01] | * | * | * | [.8] |
| 编码器 | 层数 | 被读取的层 |
|---|---|---|
| ViT-L | 24 | 17, 19, 21, 23 |
| ViT-H | 32 | 25, 27, 29, 31 |
| ViT-g | 40 | 24, 29, 34, 39 |
C.2. 更多结果
探针规模。把四层探针改为单个 16 头交叉注意力块,对 ViT-L 和 ViT-g 重新评六任务。本消融所有任务只用 16 帧,包括 Diving-48 和 Jester,区别于正文。表 18 显示除 Jester 外四层更好;原文报告 ViT-L 平均提升 1.4 点、ViT-g 提升 1.0 点。多层编码器输入方面,表 17 显示 Diving-48、Jester 明显受益于读取较深层的信息。
| 模型 | 读取编码器层数 | Diving-48 | Jester |
|---|---|---|---|
| ViT-g | 1 | 82.9 | 96.1 |
| ViT-g | 4 | 86.7 | 97.6 |
| 模型 | 探针层数 | 平均 | SSv2(运动) | Diving-48(运动) | Jester(运动) | K400(外观) | COIN(外观) | IN1K(外观) |
|---|---|---|---|---|---|---|---|---|
| ViT-L | 1 | 84.0 | 72.0 | 83.2 | 97.7 | 83.3 | 85.9 | 81.8 |
| ViT-L | 4 | 85.6 | 73.6 | 87.1 | 97.7 | 85.1 | 86.8 | 83.5 |
| ViT-g | 1 | 86.0 | 74.8 | 85.3 | 97.8 | 85.6 | 88.9 | 83.5 |
| ViT-g | 4 | 87.0 | 75.6 | 86.7 | 97.6 | 86.6 | 90.7 | 84.6 |
译者注:原文段落把 ViT-L 平均增量写为 1.4 点,但表 18 平均从 84.0 到 85.6,为 1.6 点;此处保留两处原值。
附录 D. 行动预判/D.1. 超参数
提供第 6 节 EK100 行动预判的细节、结果与消融。探针沿分类架构:四个 Transformer 块,最后是可学习查询 token 的交叉注意力,每个查询输出接线性分类器。
训练 focal loss 的 α = 0.25、γ = 2.0,适合长尾、不平衡类别。L、H、g 用 32 帧、8 fps、256×256,g₃₈₄ 用 384×384。训练随机取 0.25–1.75 秒预判时间、0.0–0.25 预判起点。起点表示行动段内部位置:0 是预测首帧表征后送探针,1 是预测末帧。验证时预判时间 1 秒、起点 0。
| 参数 | EK100 |
|---|---|
| 训练预判时间 | 0.25s -- 1.75s |
| 训练预判起点 | 0.0 -- 0.25 |
| 验证预判时间 | 1s |
| 验证预判起点 | 0.0 |
| 帧数 | 32 |
| 帧率(fps) | 8 |
| 训练轮数 | 20 |
| 预热轮数 | 0 |
| 全局批量大小 | 128 |
| 分类器头数 | 20 (4x5) |
| 分类器学习率 | [5e-3 3e-3 1e-3 3e-4 1e-4] |
| 分类器权重衰减 | [1e-4 1e-3 1e-2 1e-1] |
D.2. 更多结果
架构影响。表 20 分别给探针编码器、预测器、两者输出。只用编码器已具竞争力,再加预测器对动词、名词、行动有小而稳定的改善;只用预测器虽非平凡表现,却明显低于编码器,说明 EK100 更需要强语义理解,而非单纯未来预测能力。
| 编码器输出 | 预测器输出 | 动词 | 名词 | 行动 |
|---|---|---|---|---|
| ✓ | — | 61.3 | 57.0 | 39.1 |
| — | ✓ | 48.7 | 34.7 | 20.2 |
| ✓ | ✓ | 63.6 | 57.1 | 39.7 |
输入分辨率。图 17 检验上下文帧数、fps 与分辨率。更长上下文、更高帧率与分辨率带来收益,直到平台或略降。最佳为 32 帧、8 fps、384×384。
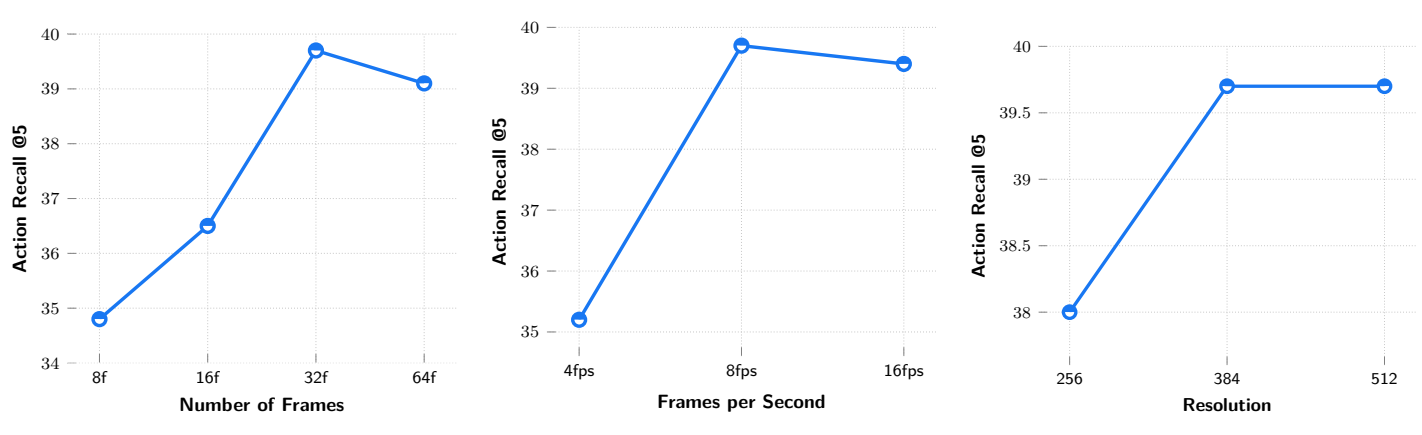
图 17:EK100 预判协议消融。左:上下文帧数;中:固定 32 帧时的推理 fps;右:上下文空间分辨率。
更长时预测。图 18 左将预判时间改为 1、2、4、10 秒,分别报 recall@1、5、10、20。时间越长表现明显下降,符合 EK100 未来并不确定的性质。失败分析。图 18 右列验证集中动词、名词、行动的成败组合;最多的是三者均对,最常见的失败组合都包含行动类别失败。
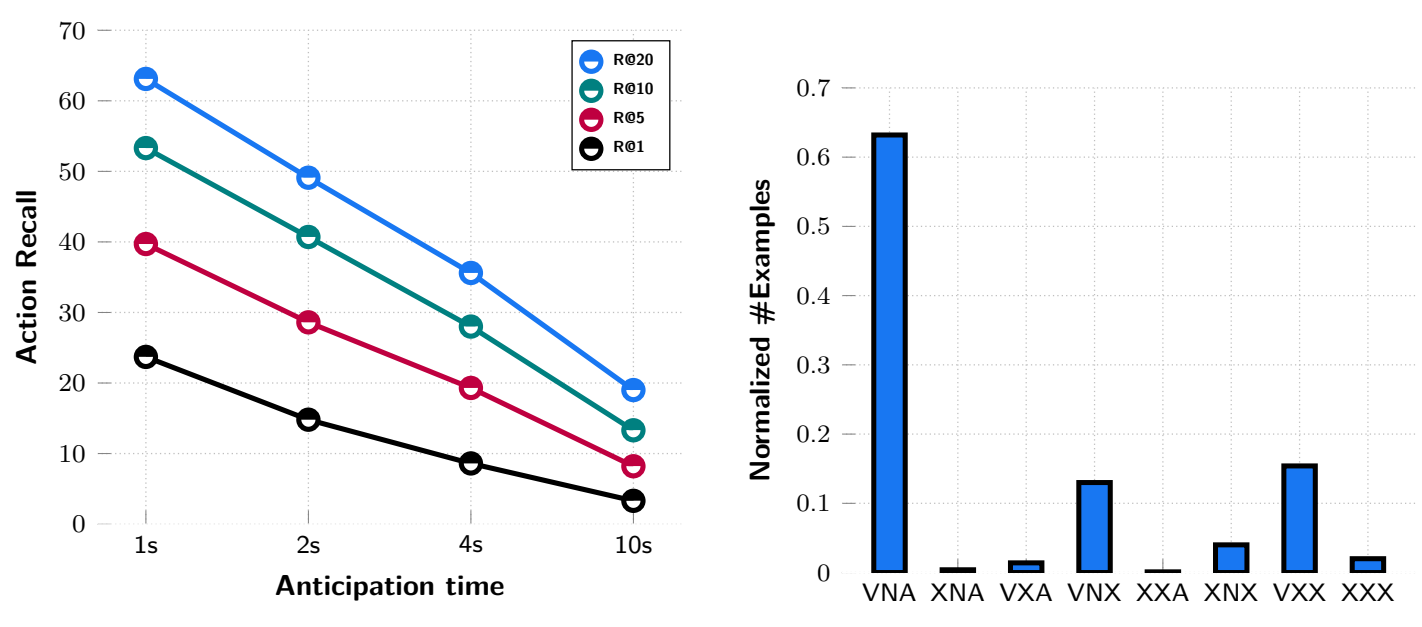
图 18:左:不同预判时长和 recall 值的 EK100 表现。右:验证集的成功及失败分布,VNA 为动词、名词、行动均正确,X 为对应属性错误。探针三个分类器独立,因此行动预测可以不同于动词和名词预测组成的配对。
附录 E. 视频问答/E.1. 图像与视频输入
沿 LLaVA 框架构建 MLLM:视觉主干 V-JEPA 2,语言主干可为现成 LLM,以通常两层 MLP 的投影器,将视觉嵌入映入 LLM 隐藏维度,使用图文、视频文本配对数据渐进训练。
数据与 PerceptionLM 相似,共 8850 万对。受控实验使用 1800 万对、不同编码器完全相同 MLLM 流程,语言主干为 Qwen2-7B-Instruct;扩展实验用全部数据及 ViT-g₃₈₄,语言主干为 Llama 3.1 8B Instruct。
视频的视觉 token 显著多于图像,必要时通过自适应 2×2 池化、Perceiver Sampler(Jaegle 等, 2021)、注意力池化等减少。图文学习对下游高表现很重要;把图像复制到模型最大帧数的简单做法,在早期实验中效果差,不能抽取细粒度信息。
因此采用 Liu 等(2024a)的改进 Dynamic S²:按原始分辨率和宽高比,把图像切成不超过模型支持尺寸的切片序列,保留精细信息。视频则固定帧数 fn,在视觉 token 数与计算预算间取舍。
E.2. 受控设置
训练细节。沿 LLaVA-NeXT,全部编码器用 Qwen2-7B-Instruct。按算力与图像块数,用 4–16 倍注意力池化减少视觉 token(表 21)。训练阶段为:1,以图像描述对齐注意力池化器;1.5,在高质量图像描述上训练完整模型;2,在大规模图像问答上训练完整模型;额外阶段 3,训练大规模视频描述和问答。共 1800 万配对样本,语言模型逐渐理解视觉 token,视频问答在阶段 3 后改善最大。
冻结与微调设置都训练 LLM、投影器的全部参数;微调设置另解冻 V-JEPA 2。除特殊注明,投影器采用四倍注意力池化,保持上下文长度。实现基于 LLaVA-NeXT,使用 PyTorch 2.5.1、Transformers 4.46.0、Flash Attention 2、DeepSpeed 0.14.4,分别支持实现、快速训练、多 GPU 分片。所有阶段用 128 张 H100、有效批量 256、AdamW、权重衰减 0。阶段 1、1.5 学习率 10⁻⁵、余弦衰减;阶段 2、3 恒定 5×10⁻⁶;每阶段前 3% 步数线性预热。
基线。DINOv2 是自监督图像模型,SigLIP2、Perception Encoder 用带噪声图文描述做语言监督;分别用原生 518、384、448px 分辨率,逐帧独立处理。其他设置相同,只把注意力池化比例增到 16,让图像 token 数接近。
| 模型 | 池化比率 | 视觉 token 数 | 批量 | 阶段 1/1.5 学习率 | 阶段 2/3 学习率 | 权重衰减 | 帧数 |
|---|---|---|---|---|---|---|---|
| V-JEPA 2 ViT-L₂₅₆ | 4 | 4096 | 256 | 1e-5 | 5e-6 | 0.0 | 128 |
| V-JEPA 2 ViT-H₂₅₆ | 4 | 4096 | 256 | 1e-5 | 5e-6 | 0.0 | 128 |
| V-JEPA 2 ViT-g₂₅₆ | 4 | 4096 | 256 | 1e-5 | 5e-6 | 0.0 | 128 |
| V-JEPA 2 ViT-g₃₈₄ | 4 | 9216 | 256 | 1e-5 | 5e-6 | 0.0 | 128 |
| V-JEPA 2 ViT-g₅₁₂ | 8 | 8192 | 256 | 1e-5 | 5e-6 | 0.0 | 128 |
| DINOv2₅₁₈ | 16 | 10952 | 256 | 1e-5 | 5e-6 | 0.0 | 128 |
| SigLIP2₃₈₄ | 16 | 5832 | 256 | 1e-5 | 5e-6 | 0.0 | 128 |
| PE₄₄₈ | 16 | 8192 | 256 | 1e-5 | 5e-6 | 0.0 | 128 |
评估。使用 lmms-eval——支持视觉的 llm-eval-harness 分支——确保可重复的时空推理评估。受控设置中,各模型、数据集均匀采样 128 帧推理;PerceptionTest 另在训练集训 5 epoch。
时长影响。固定 V-JEPA 2 或 DINOv2 编码器,增加训练和测试帧数。V-JEPA 2 下游表现线性改善,DINOv2 则下降或持平(图 19),显示视频编码器与 LLM 对齐后处理自然语言长视频问题的潜力。
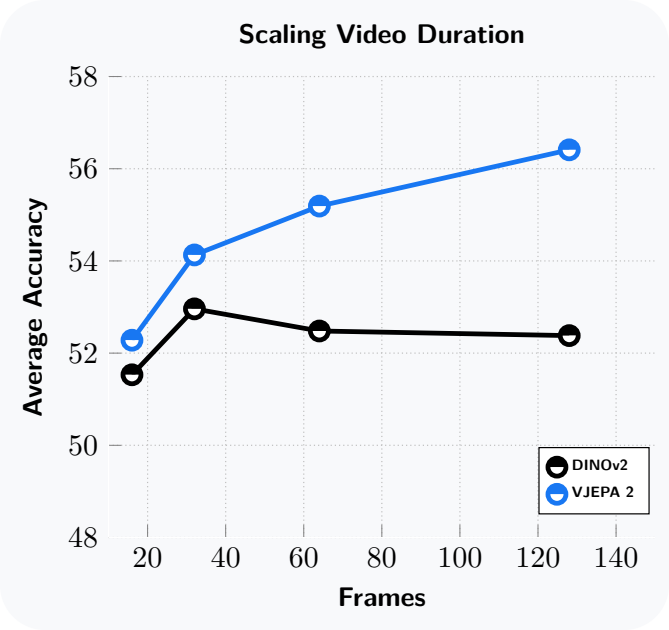
图 19:冻结编码器的视觉指令微调中,增加帧数的影响。与自监督图像编码器 DINOv2 相比,V-JEPA 2 随更多帧线性改善。
E.3. 数据扩展设置
训练细节。沿用 Cho 等(2025)训练 PerceptionLM 8B 的框架,其公开代码基于 Lingua。改为 V-JEPA 2 编码器及 Llama 3.1 8B Instruct。不同于 PerceptionLM,这里不池化,以 MLP 投影器训练 ViT-g₃₈₄,每帧 288 个 token。三阶段分别用图像描述对齐 MLP、用图文描述和问答训练、用视频文本描述和问答训练,数据扩大到 8850 万。
使用 PyTorch 2.5.1 及修改后的 PerceptionLM 训练代码。阶段 2、3 用 512 张 H100;本段原文的全局批量分别为 2048、1024。其他超参数见表 22。
| 参数 | 值 |
|---|---|
| 共同参数 | — |
| 裁剪尺寸 | 384 |
| 视频帧率(fps) | 1 |
| 采样方法 | 均匀 |
| 随机种子 | 777 |
| 阶段 1 | — |
| 训练步数 | 16000 |
| 预热步数 | 96 |
| 全局批量大小 | 128 |
| 学习率 | 1e-4 |
| 最终学习率 | 1e-6 |
| 权重衰减 | 0.05 |
| 最大序列长度 | 1920 |
| 阶段 2 | — |
| 训练步数 | 35000 |
| 预热步数 | 200 |
| 全局批量大小 | 2048 |
| 学习率 | 4e-5 |
| 最终学习率 | 4e-7 |
| 权重衰减 | 0.05 |
| 最大序列长度 | 6400 |
| 图像切片数 | 16 |
| 视频帧数 | 16 |
| 阶段 3 | — |
| 训练步数 | 28000 |
| 提前停止步数 | 22000 |
| 预热步数 | 168 |
| 全局批量大小 | 2048 |
| 学习率 | 1e-5 |
| 最终学习率 | 1e-7 |
| 权重衰减 | 0.05 |
| 最大序列长度 | 12800 |
| 图像切片数 | 32 |
| 视频帧数 | 32 |
译者注:表 22 的阶段 3 全局批量为 2048,与本段正文的 1024 不同;译稿分别保留,不能用其一静默覆盖另一个。原文在“无池化”之后又把 MLP 称为 pooler,此处依据明确的方法说明译为投影器。
基线。比较 Qwen2VL、Qwen2.5VL、InternVL-2.5、PerceptionLM 8B;除 MVP 自行运行外,其余分数直接取各论文。评估流程近受控设置,同用 lmms-eval,本设置报告 32 帧的结果。
原文与来源
图片:Mahmoud Assran 等 · V-JEPA 2(2025,arXiv v1)· CC BY 4.0 · 原图图内内容未改动