
杯子还没落下,机器人就得作决定
设想机械臂已经夹起一个杯子,要把它放进托盘。杯子与托盘之间隔着一道稍高的边缘:直接横移,路程短;先抬高再横移,多走一步,却可能避开碰撞。控制系统必须在动作发生前比较这些后果。下面沿用这个解释性场景说明模型的工作方式,它不是某篇论文中的实验记录。
我们很容易把这种比较想成脑海里播放两段小电影:一段杯子撞上边缘,一段杯子平稳落下。生成未来画面确实能让人看懂预测,但控制器未必需要用照片保存这两种未来。只要模型保留了影响选择的信息,并能预测不同动作的后果,它也可以在一组紧凑的数值中完成比较。
PlaNet、DreamerV3 和 TD-MPC2 就把重要计算放在潜在空间中,不过它们使用预测的方式各不相同:PlaNet 在执行时搜索动作序列,DreamerV3 用想象轨迹学习策略,TD-MPC2 用不解码观察的模型进行轨迹优化。理解这些差别,要追踪一份预测从哪里来、怎样改变动作选择。
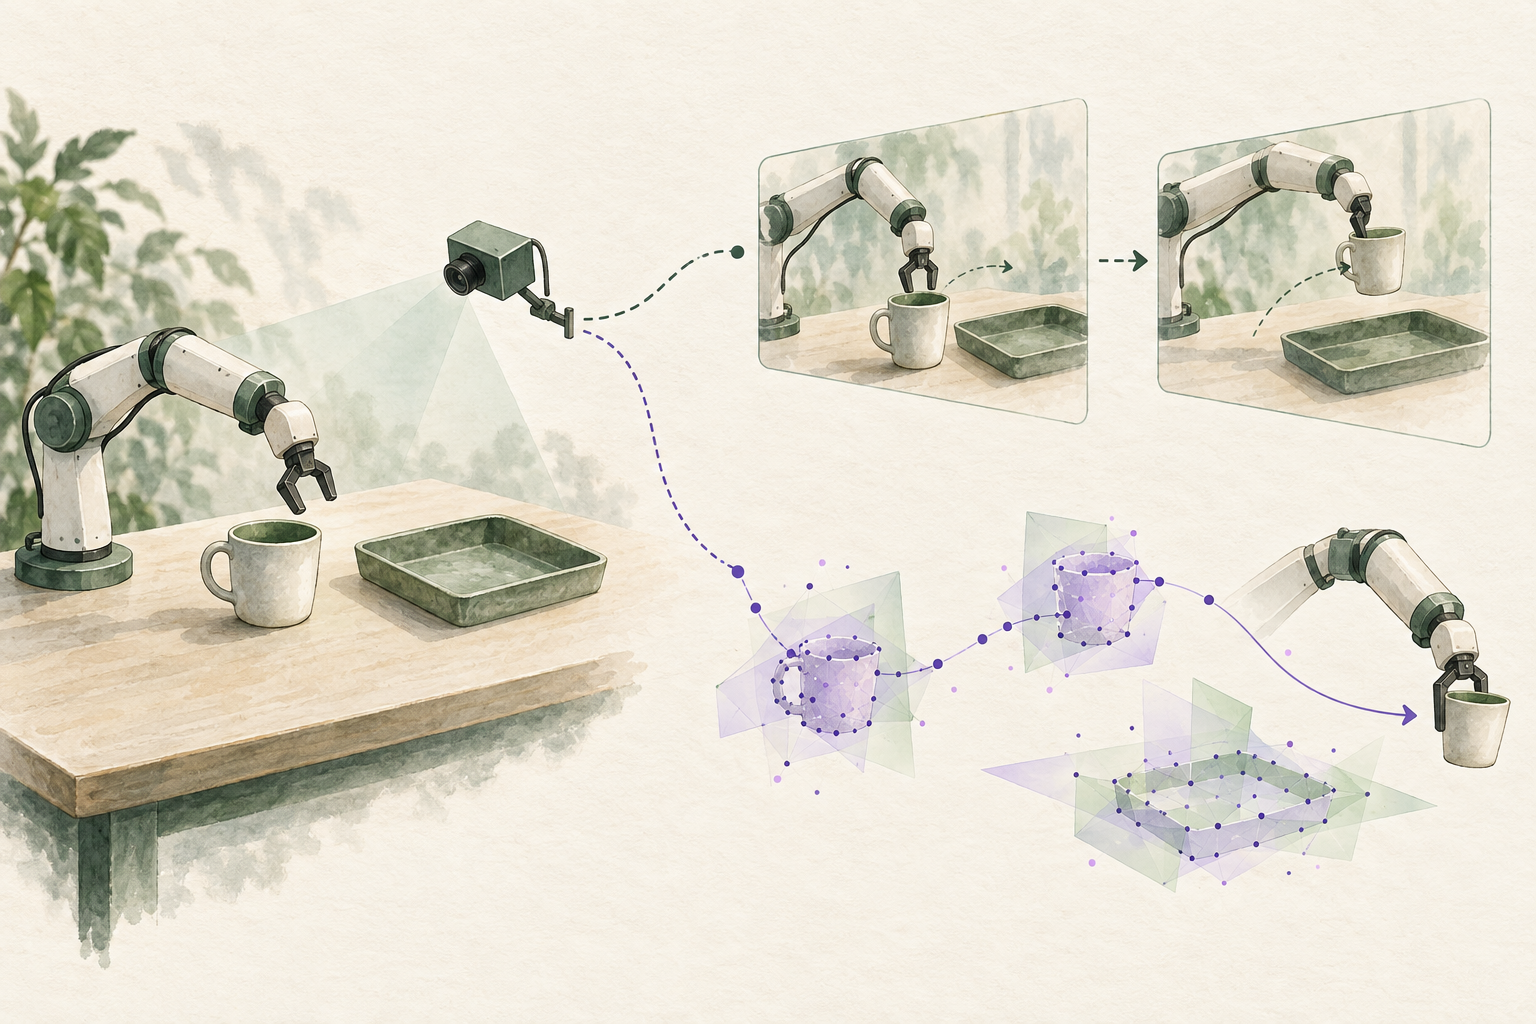
同一观察可以接向未来图像,也可以接向紧凑表征,再用于判断下一步动作。AI 生成的概念示意图,不是某个模型的预测结果或实验记录。
一幅画面与一个表征,各自保存什么
如果输出是未来图像,我们可以直接检查杯子的位置、夹爪的运动和托盘的轮廓。颜色、纹理、背景也会一起出现。对需要观看、编辑或重建场景的应用,这些视觉内容本来就是所需结果;对控制器而言,还要从结果中判断哪条动作路线更合适。
潜在表征则先把观察编码成一组学习得到的数值,再预测这些数值如何随动作变化。“潜在”表示它们处在模型内部,通常不能像读一张物体位置表那样逐项解释。某个数值未必单独对应杯子高度,也不能仅凭两组数字很接近,就断定真实杯子只移动了一点。表征怎样关联观察、预测和任务,要靠训练约束建立。
把这个区别放回托盘场景:一张图像可以同时表现杯子的花纹、桌面颜色和托盘边缘。紧凑表征可能以另一种方式保留杯子相对托盘的关系、正在发生的运动,以及与下一步动作有关的信息。控制所需的关键是让“低处横移可能碰撞”和“抬高后能够通过”产生可区分的后果。它不必把每个背景细节都还原成可见像素。
但哪些信息可以省略,取决于任务。把杯子移到指定位置时,位置与运动可能最重要;任务改成倒水,杯口朝向、液体和接触条件就会进入判断。同样一份压缩表征,可能支持前一个任务,却漏掉后一个任务需要的信息。表征紧凑只说明表达形式,不能保证任务相关信息都在。
因此,图像与表征之间也不是一个简单的“细致程度”刻度。图像容易被人检查,内部表征便于模型在自己的空间里计算;两者最终都要接受任务检验。下面的分歧进一步发生在训练与使用阶段:模型学会重建画面,并不意味着每次选动作时都要把未来画出来。
训练时重建,不等于规划时生成
PlaNet 从真实交互中学习潜在状态变化、观察重建和奖励预测。观察模型把潜在状态解码成图像,提供丰富的训练信号,使内部状态受到实际观察的约束。论文同时明确说明:这个观察模型不用于规划。规划器使用潜在动力学和奖励预测,寻找未来动作序列。
用托盘场景理解这条计算链,首先是观察更新。系统收到杯子、夹爪和托盘的当前画面,将它与已有动作和观察历史结合,形成对当前状态的内部估计。历史有作用:一张静态照片可能看不出杯子正朝哪个方向移动,过去的观察能帮助推断正在发生的变化。PlaNet 的状态推断利用观察与动作历史;这里的杯子场景仍只是对这一机制的解释。
随后,规划器在模型中比较候选动作。可以把两条候选粗略理解成“直接横移,再下降”和“先抬高,再横移,最后下降”。候选中每个动作都推动内部状态向前预测,奖励模型为这些未来步骤提供评分,规划器再比较累计回报。候选未来不必先变成两段视频,状态和评分就能进入搜索。
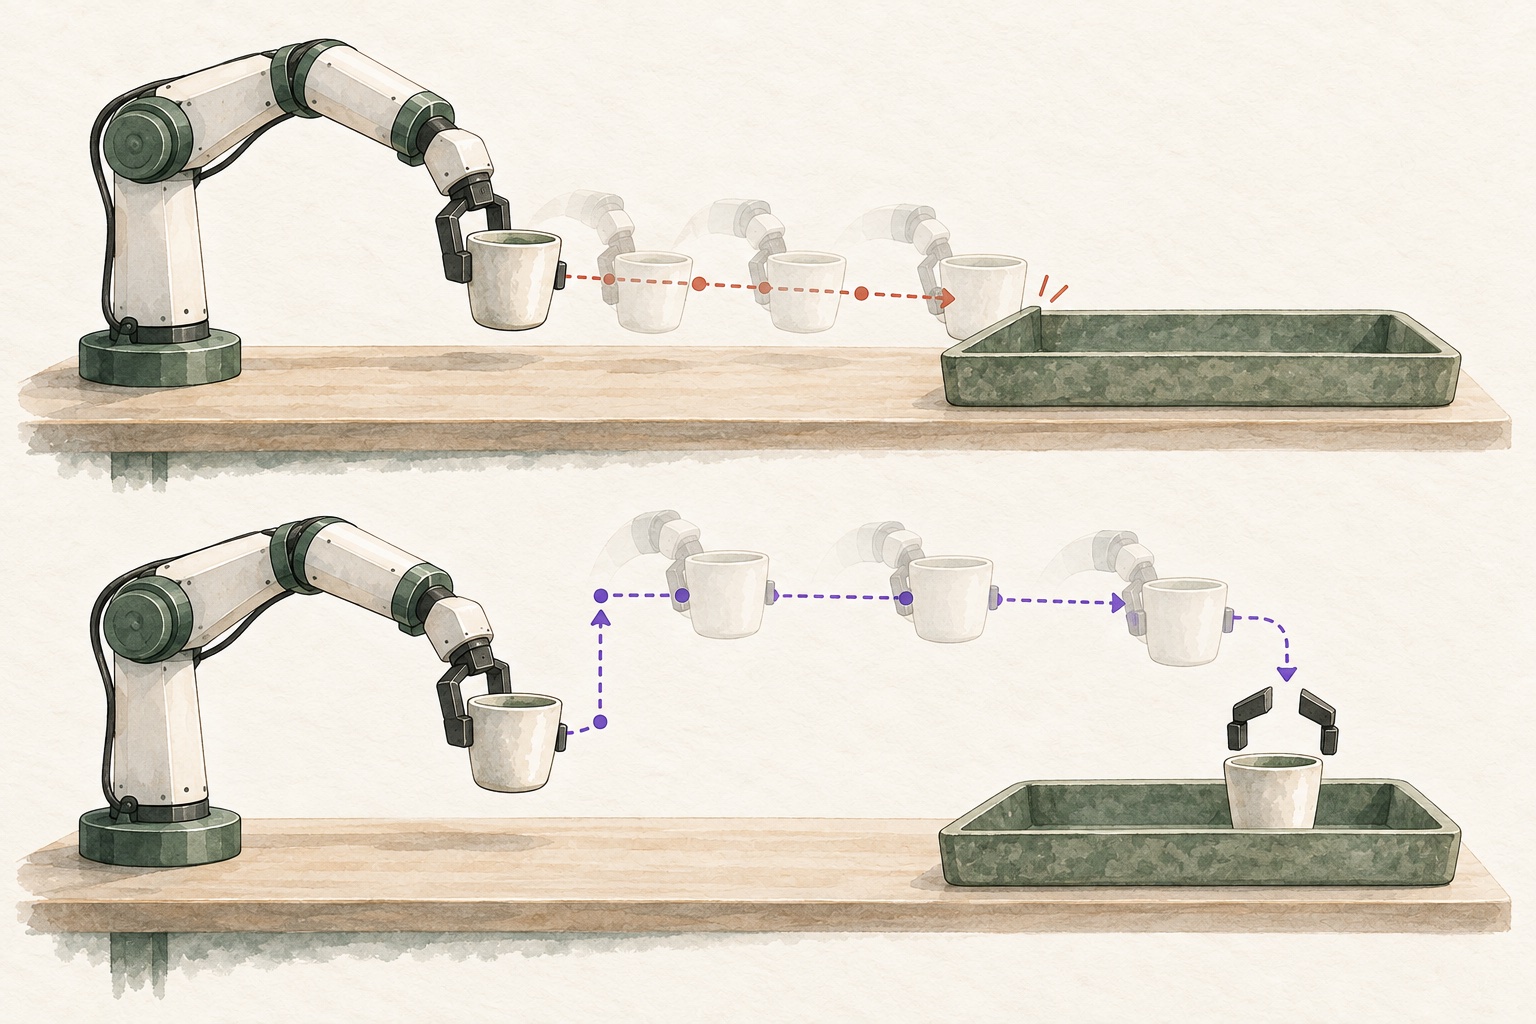
上方是低位横移,下方是先抬高再横移。半透明位置用于帮助人阅读候选路线;模型内部的比较未必生成这些画面。AI 生成的解释性示意,不是预测结果或实验记录。
这里有一项容易被略过的前提:评分必须与任务相符。在这个解释性例子里,如果设计者只奖励最后接近托盘的位置,却没有让评分反映需要避免的碰撞,模型即使预测出了两条不同路线,也可能偏向错误方案。预测提供候选后果,任务目标决定如何取舍;会预测与会作出合适选择之间,还有这层联系。
假设模型把抬高路线评为更合适,系统也不会把整条计划一次执行到底。PlaNet 采用模型预测控制:先执行所选序列的第一个动作,收到新观察后重新规划。对杯子来说,抬高后的位置可能与预期略有不同,此时应从新状态重新比较后续移动,而不继续沿用原来的全部预测。
如果后续观察与计划相符,控制器继续让杯子移到托盘上方、下降,再按任务流程放下。这个例子的结果应由任务要求检查:杯子是否确实进入目标位置、是否被托盘支撑等。一次预测路线看起来可行,只是选择下一步的依据;完成放置,还要靠后续动作和实际结果把这条过程走完。
图像重建在这里仍有价值。训练时,它帮助模型把内部状态与观察联系起来;诊断时,解码结果让人检查模型预测出了什么。但搜索中每条候选、每个时间步都生成完整画面,会加入额外的解码计算。PlaNet 将这部分计算留在训练或检查环节,执行时直接在潜在空间规划。
DreamerV3 将“用预测改善行为”安排在另一处。世界模型产生抽象状态、奖励等想象轨迹,actor 学习在这些状态中选择动作,critic 学习估计后续回报。actor 可以理解为策略,critic 可以理解为回报评估器;它们在想象中更新,使策略逐渐偏向模型认为更有利的行为。
真正与环境交互时,DreamerV3 更新当前模型状态,再从 actor 网络采样动作,不在每一步重新向前搜索候选计划。沿用杯子例子,这相当于把预测经验用于事先训练“遇到这类状态应怎样行动”的策略,执行时由策略选择下一步。它仍要处理实际观察,只是想象轨迹与候选比较没有按 PlaNet 的方式每步运行。
也有模型从训练开始就不负责画图
PlaNet 和 DreamerV3 都用观察重建塑造内部表征,TD-MPC2 进一步改变了训练约束。它把自己的世界模型称为隐式、无解码器模型,通过潜在预测、奖励预测和价值学习来训练,并在潜在空间进行局部轨迹优化。它需要输入编码器,但不依靠把未来观察还原成图像来完成这些学习目标。
可以沿着一次实际交互理解这些约束。系统看到当前观察,执行动作,再收到下一观察。模型在内部预测动作后的表征,训练时将它与实际下一观察的编码联系起来;同时学习这一转移的奖励,以及后续可能获得的回报。这样,内部表征受到状态变化和控制任务共同约束。
回到托盘场景,这类模型需要把会影响行动结果的差异反映在内部预测或回报估计中。例如,低处直接横移与抬高后横移,应当在与任务相关的结果上有所区别。没有图像重建头,并不免除这种要求,也不保证模型自然学会接触、支撑或稳定性。
因此,阅读“无解码器”时要问清它改变了哪一环:是训练时没有图像重建目标,还是执行时省略图像解码?又由什么学习目标和决策过程接替这部分工作?这三个问题比看到模型名称后直接推断能力,更能解释方法之间的实际差别。
预测里丢掉的一点差别,可能改变选择
紧凑表征可以减少需要处理的内容,但压缩也可能丢失有用线索。DIAMOND 在 Atari 中采用扩散世界模型,其正式接收摘要讨论了视觉细节改善与智能体表现的关系,并指出紧凑的离散表征可能忽略强化学习所需细节。这是特定研究中的证据,不能扩展成所有任务都应预测像素。
在杯子例子中,托盘边缘很薄,占据的像素也许不多,却决定杯子能否直接通过。假如内部表征把“边缘低于杯底”和“边缘略高于杯底”压成几乎相同的情况,两条路线的结果就可能难以区分。规划器即使认真搜索,也是在一份漏掉关键差异的预测上作选择。
另一方面,如果模型把桌面花纹、杯子反光和背景颜色画得很逼真,却没有准确预测杯子是否仍被夹住,控制器同样可能选错。视觉上显眼的误差与决策中重要的误差,不一定落在同一位置。应该追问某处误差会不会改变动作排序、让计划失效,而不只评价整幅画面像不像。
任务变了,检查重点也会变。把杯子放进空托盘时,背景纹理可能不重要;如果任务要求按杯身标记调整朝向,原本不起眼的纹理就成了任务线索。信息的重要性由任务赋予,保留更多像素或压缩更多内容,都需要说明在当前目标下保住了什么、丢掉了什么。
看到预测视频,还要查它怎样被使用
论文中的预测视频可能是在展示模型学到了什么,也可能是决策流程的一部分。单看视频,通常无法判断图像解码发生在训练、诊断还是实际执行中。PlaNet 和 DreamerV3 都有观察重建,但它们的动作选择分别使用在线规划和已训练策略。需要把演示与算法说明放在一起读。
| 方法 | 主要训练约束 | 实际交互时怎样选动作 |
|---|---|---|
| PlaNet | 观察重建、潜在动力学与奖励预测 | 在潜在空间搜索动作序列,执行首步并重新规划 |
| DreamerV3 | 世界模型学习,并用想象轨迹训练策略与价值评估 | 更新模型状态,由 actor 采样动作,不逐步向前搜索 |
| TD-MPC2 | 潜在预测、奖励预测与价值学习,无观察解码目标 | 用隐式模型进行局部轨迹优化 |
再看研究如何验证选择是否有效:使用了什么观察和动作接口,在什么任务上评估,哪些结果来自实际执行,哪些只是模型中的预测?杯子碰到边缘这种失败,只有落到执行或明确的任务检查上,才能判断预测误差是否真的影响了行为。好看的未来画面与可靠的任务表现,需要分别核对。
让预测方式服从任务
回到开头的问题,机器人需要先比较横移与抬高路线,依据任务目标选择动作,再用实际观察检查并继续行动。完成这条过程需要有用的状态信息、动作后果预测和合适的选择机制。它们可以通过未来图像连接,也可以通过潜在状态、奖励与价值连接;图像是否生成,要看它在这条过程中承担什么作用。
不妨再给这个任务加一个条件:杯身的紫色标记必须朝向相机。原先只检查“杯子是否进入托盘”,现在还要比较放下后的朝向。两条路线都能把杯子送到同一位置,却可能只有一条满足新目标。如果表征丢掉了标记方向,或评分只关心位置,系统就可能分不清它们;完整画面保留了标记,也仍需让选择过程使用这条信息。
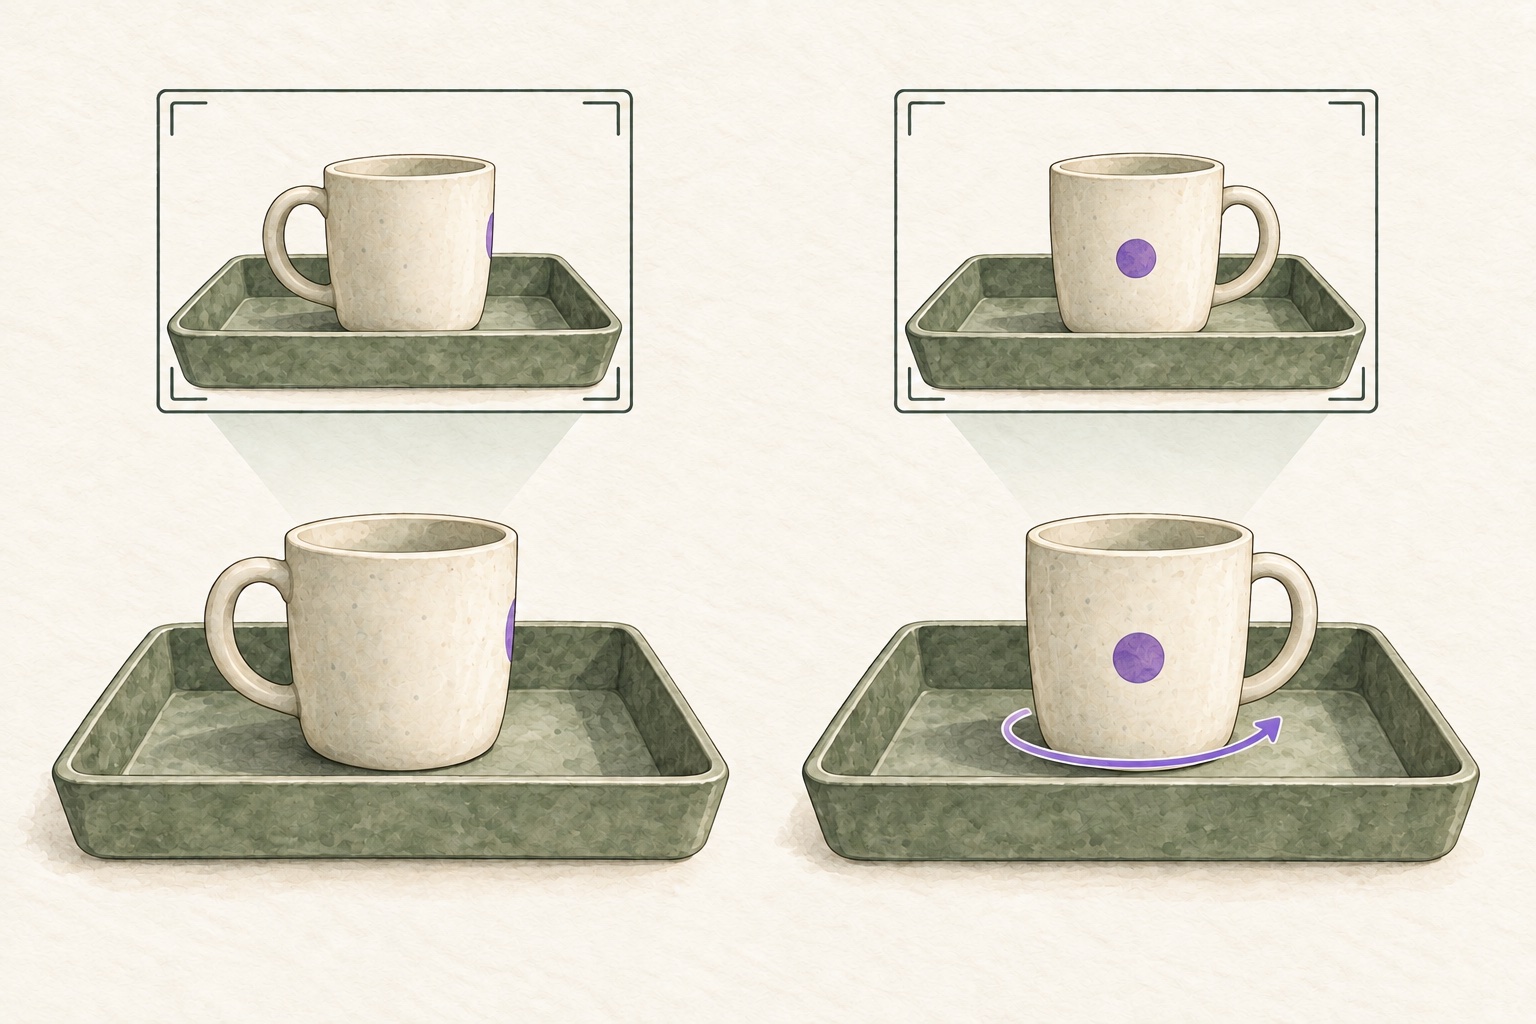
只要求放入托盘,与还要求标记朝向相机,需要检查的信息不同。紫色弧线表示杯子转向;上方画框对应观察视角。AI 生成的假设场景,不是某个模型的输出。
因此,判断一个新模型时,可以从任务倒着追问:什么才算完成,选择动作时用了哪些预测,关键差异由什么训练信号保留下来,实际结果又怎样检查。对有预测视频的方法,要查这些画面怎样参与选择;对没有可观看未来的方法,要查内部状态、奖励或价值是否支持同样的判断。顺着这几步读,才能把“画得像不像”与“任务做得怎样”分别放到合适的位置。
原文与来源
- PlaNet:ICML 2019 正式论文全文 ↗
- DreamerV3:Nature 2025 正式版全文、Methods 与许可说明 ↗
- TD-MPC2:ICLR 2024 论文,arXiv v2 全文 ↗
- DIAMOND:NeurIPS 2024 正式接收摘要与论文入口 ↗
图片:AI 生成概念示意图 · 世界模型图谱