
同一份训练方法,可以得到很多个专用模型
设想一个实验室要让机器人学会开门、关门和搬运。研究者使用同一套训练程序和同一组设置,先在开门任务训练,保存一个模型;再从头训练关门,保存第二个;最后训练搬运,保存第三个。三个任务都成功了,可以说明这套方法有适用面,但把第一个模型拿到搬运任务,它未必知道该做什么。
另一种实验把三类经历放进同一训练过程,最终得到一个模型。测试时,这个模型接收当前观察和任务信息,既能选择开门动作,也能在任务改变后选择搬运动作。这里共享的不只是训练程序,还包括学到的参数。这两种成果都重要,但它们解决的困难不同,需要的证据也不同。
论文标题中的“通用”“多样任务”“固定超参数”有时会把这几层意思挤在一起。TD-MPC2 很适合用来拆开阅读,因为同一篇论文分别报告了 104 个任务上的单任务训练,以及一个共享智能体执行 80 个任务的多任务实验。两个数字回答不同问题,不能拼成“一个模型已经掌握 104 个任务”。
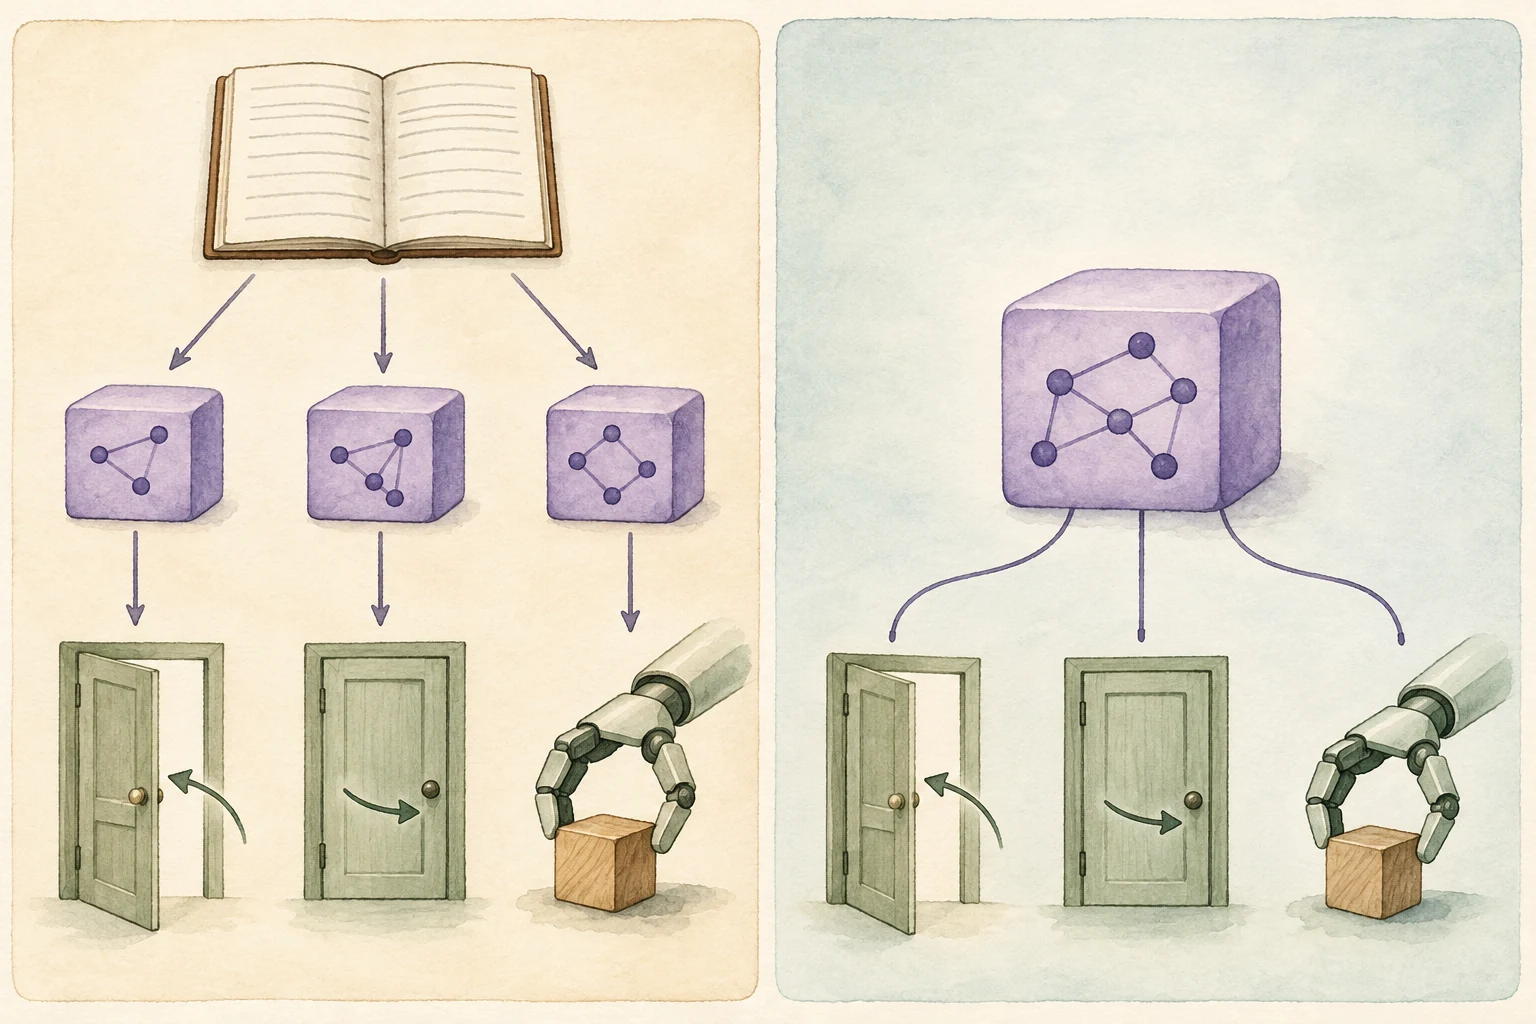
左侧是同一套方法训练出多个专用模型,右侧是多个任务使用一个共享模型。AI 生成概念图,图中的任务数量只是示意。
要区分的三层共享,分别改变了什么?
第一层是共享算法,也就是训练和决策的计算规则。相同算法可以采用不同模型规模、学习率、规划步数,也可以为每个任务单独调这些设置。算法名称相同,不意味着实验条件已经相同。第二层是共享一组超参数:研究者希望同样的设置在不同任务上都能工作,减少每换一个任务就重新调参的成本。
第三层才是共享训练后的模型。不同任务的数据共同更新它的参数,任务之间可能互相帮助,也可能相互干扰。成功的多任务学习要解决怎样复用有用规律、怎样保留任务差异,以及有限的模型容量怎样分配。一个方法逐任务都能训练成功,并不能保证把所有数据混起来后仍然成功。
TD-MPC2 论文的单任务结果主要回答第二层问题:在 DMControl、Meta-World、ManiSkill2 和 MyoSuite 共 104 个连续控制任务上,是否可以沿用一套方法和设置得到较强结果。多任务部分另选了 Meta-World 的 50 个任务与 DMControl 的 30 个任务,把数据放在一起训练一个智能体,回答第三层问题。
“固定”也需要读到实现细节。论文用预先给定的规则,按任务回合长度计算折扣因子和开始更新前的随机采集步数;高维动作任务的规划迭代数也有规则调整。多任务训练的批大小是单任务设置的四倍。固定的是共同算法与配置规则,不是所有实际运行数值都逐项完全相等。
一个模型接到任务以后,怎样知道该做哪件事?
回到开门与关门。相同的门、相同的当前位置,可以对应相反目标。如果模型只看到当前状态,却没有任何任务线索,就难以分辨这次应当继续拉开还是把门推回去。多任务学习不是把不同目标直接抹平,通常还要让目标以某种形式进入模型。这个门的例子是解释性场景。
TD-MPC2 采用可学习的任务嵌入:每个任务对应一个固定长度向量,训练时与模型的其他参数一起更新。编码器、潜在动力学、奖励、终端价值和策略先验都接收它,因此同一组共享计算能依据任务信息给出不同预测。论文不要求预先提供语言描述,也没有声称模型单看场景就能自动猜出所有任务意图。
不同身体又带来另一个问题:一只机械手、一个行走身体和一个简单摆杆,观察及动作的维度可能不同。TD-MPC2 将输入输出补零到共同的最大维度,并在训练、推理和规划时屏蔽无效动作维度。一个只有几个有效控制量的任务,不应因填充了更多位置,就被当作真的多出了可用动作。
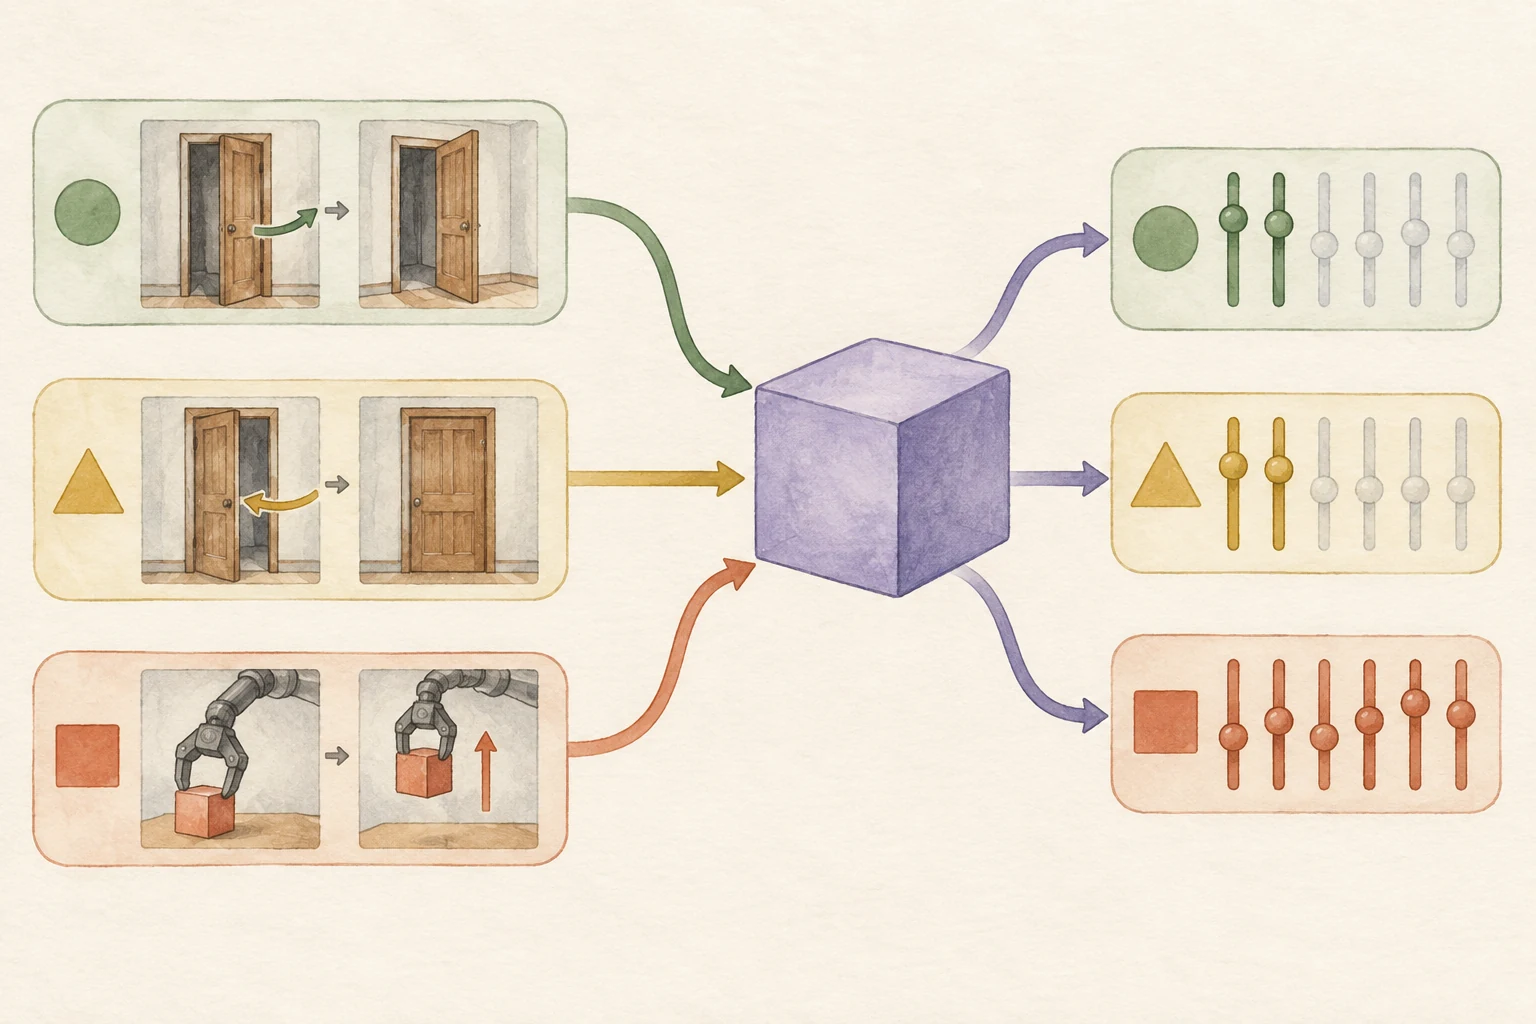
任务信息与对应经历一起进入共享学习过程;有效动作维度随任务保留。AI 生成概念图,不表示某个模型的真实网络结构或训练数据。
这种安排让共享成为可能,却不自动保证迁移。向量可以区分任务,动作屏蔽可以对齐接口,但模型仍需从数据中学到每个动作意味着什么。把一个新的机器人控制指令补到同样长度,不能凭这个格式操作就让旧模型学会控制新身体。
80 个任务的数据,是怎样进入一个模型的?
TD-MPC2 的大规模多任务实验,并非让一个初始空白智能体同时在所有环境中在线摸索。作者先从 240 个单任务智能体的回放缓冲区中收集了 5.45 亿条转移,再用这些数据训练多任务模型。数据包含从随机到专家水平的不同阶段行为,因此也不是只有成功演示。把数据来源说清楚,才能理解实验究竟解决了哪一段学习过程。
作者训练了五种规模的共享模型,从约 100 万到 3.17 亿参数。在这个 80 任务数据集上,归一化平均分从 16.0 上升到 70.6。这个结果支持在该设置中扩大模型容量有帮助,但不能直接当作已经测得一条普遍适用的规模定律。作者也明确没有给出 scaling law。
这项平均分把 Meta-World 的成功率,与 DMControl 归一到 0—100 的回合回报汇总到一起。70.6 不是“80 个任务都以 70.6% 的成功率完成”,更不是 80 个任务全部精通的证书。两类环境的指标来源不同,同一个平均数也可能由很不同的强项和弱项组成。
模型变大还要付出训练成本。表 1 在单张 RTX 3090 上报告,约 100 万参数模型需要 3.7 GPU 天,3.17 亿参数模型需要约 33 GPU 天。这些是该论文的近似训练成本,不能理解成今天任意机器的运行承诺。若目的是找到可用系统,还应继续检查推理速度、每个任务的结果和可支配资源。
| 实验 | 训练与测试关系 | 支持的主要判断 |
|---|---|---|
| 104 任务单任务训练 | 各任务分别学习,采用共同的算法和超参数规则 | 方法对多种任务的适用性与调参稳健性 |
| 80 任务共享模型 | 从单任务智能体回放中整理数据,训练一个任务条件化模型 | 同一模型的多任务能力与规模实验 |
| 70 任务预训练后适配 10 个留出任务 | 对每个新任务继续进行在线强化学习 | 给定交互预算下的少样本适配能力 |
没参与预训练的新任务,还需要怎样学习?
多任务模型在已学任务上工作,并不等于它面对新任务可以直接成功。TD-MPC2 还做了一个独立实验:先在 70 个任务上训练一个约 1900 万参数的模型,留出 DMControl 和 Meta-World 各 5 个任务;再把这个预训练模型分别微调到每个新任务。每个适配过程都有在线交互和参数更新。
论文图 8 在 2 万步环境交互后,汇总分数为从头学习 24.0、预训练后微调 47.0,使用 3 个随机种子。原文将其概括为低数据区间约两倍的改善。这里的结论是,已有训练在这个预算下帮助新任务学得更快;它不是完全没有新数据,也不是一个最终模型无需适配就同时完成全部留出任务。
2 万步究竟少不少,还取决于“步”的计量方式和任务设置。论文脚注说明,它对应 DMControl 的 20 个回合或 Meta-World 的 100 个回合。对模拟器而言,这可能是一笔相对有限的预算;对实体设备而言,采集、复位、维护的成本又不同。少样本是相对于明确参照的说法,不能只凭这个词判断落地代价。
留出任务的范围也要读到附录:它们来自这两个已覆盖的任务域,一些新任务和已见任务共享身体或相近结构。对这样的任务微调成功,提供的是这一组迁移关系的证据,还不能自动推出换到全新机器人、全新传感器和全新现实场景仍会同样有效。
把“通用”改写成一句可核对的话
以后遇到“能处理上百个任务”的表述,可以先在纸上画出训练前后各有几个模型。若最终每个任务各有一个模型,重点应放在算法的适用范围;若最终只有一个共享模型,再检查测试时输入了哪些任务信息、参数是否还会更新。这个小动作往往比先争论“够不够通用”更能澄清问题。
接着追踪数据:是每个任务独立在线收集,还是把多个专用智能体的经历整理在一起?是成功演示,还是包含失败与探索的混合数据?这些区别会改变成果的意义。一个已经掌握多种技能的模型,可能非常有用,但我们也需要知道取得这些技能之前,训练系统做过多少工作。
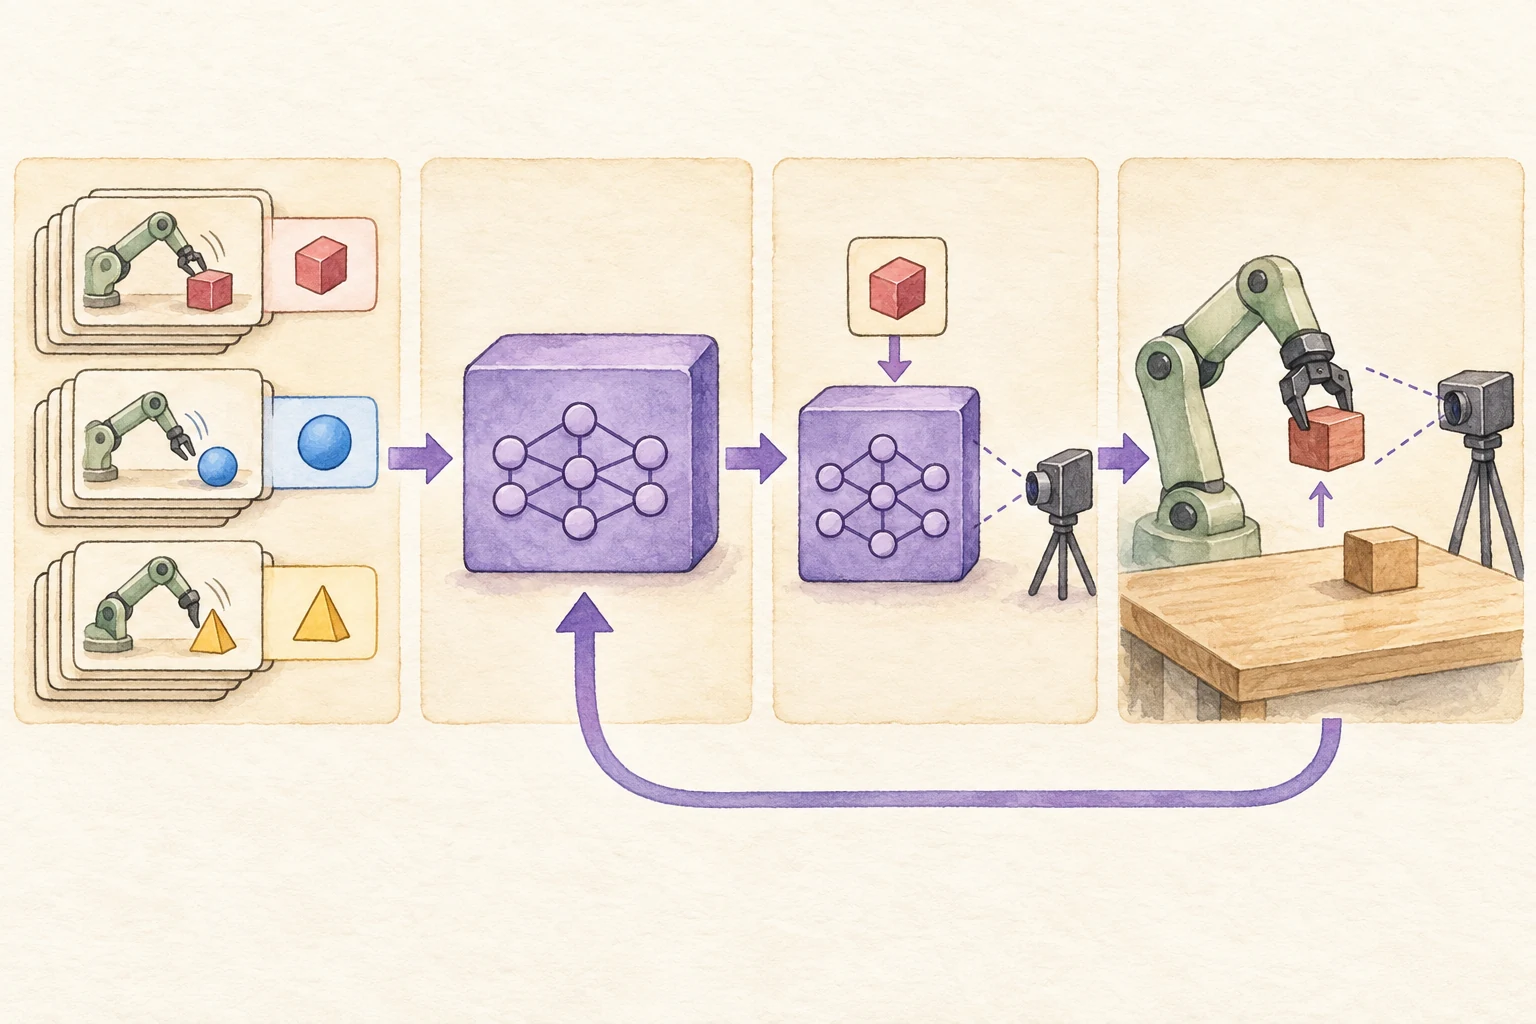
读一项多任务能力声明时,沿训练数据、共享模型、任务输入和测试反馈逐步核对。AI 生成概念图,不是实验结果或性能排名。
最后把“通用”改写成带条件的句子。例如:在这份混合经验数据上训练一个共享模型,在提供任务嵌入且不更新参数的已学任务中评估;或者:在若干任务预训练后,用每个新任务 2 万步交互进行适配。句子长了一点,却让别人知道它能否支持自己关心的使用场景。
同样的训练方法能在很多任务上奏效,降低了寻找方法的成本;一个共享模型能处理很多任务,进一步改变了经验如何复用。把这两种价值分别讲清楚,也就能看见下一步该验证什么:任务之间是否真正共享了有用知识,新的任务又能以多大代价接进来。
原文与来源
图片:AI 生成概念示意图 · 世界模型图谱