
版本与译文说明
原题:TD-MPC2: Scalable, Robust World Models for Continuous Control(TD-MPC2:面向连续控制的可扩展、稳健世界模型)。作者:Nicklas Hansen、Hao Su、Xiaolong Wang,加利福尼亚大学圣迭戈分校;Su与Wang为共同指导作者。论文标注发表于ICLR 2024,本译稿固定采用2024年3月21日的arXiv v2。原始预印本首次提交于2023年10月25日。译者:世界模型图谱。
翻译范围为摘要、正文第1—6节、致谢及附录A、E、H,保留10幅正文原图、附录E图17,以及表1、7、8、9和对应公式。完整参考文献、附录B—D、F—G、I—K仍从原文阅读;正文对这些未译附录的指引按原文保留。附录H的架构代码按相同记号整理为组件及尺寸表,SimNorm代码按执行顺序译写。
正文中的“我们”均指原作者,比较结果与研究展望保留发表时语境。文中的DreamerV3基线指该实验采用的历史实现与设置,不能自动等同于本站译介的Nature 2025正式版。本站未独立复现这些实验。固定版本的arXiv许可链接为CC BY 4.0;译文为翻译及排版改编,也采用CC BY 4.0。原图保留图内文字、完整面板及比例,来源与署名集中于文末。
摘要
TD-MPC是一种基于模型的强化学习算法,在学到的隐式、无解码器世界模型的潜在空间中进行局部轨迹优化。本文提出TD-MPC2,对TD-MPC作出一系列改进。我们在覆盖4类不同任务域的104个在线强化学习任务中,展示TD-MPC2显著改善了相对基线的表现,以一组超参数持续取得较强结果。我们还表明,智能体能力随模型与数据规模增长,并成功训练了一个3.17亿参数的智能体,执行跨越多个任务域、身体与动作空间的80个任务。最后讨论大型TD-MPC2智能体带来的经验、机会与风险。视频、模型、数据与代码见原项目页。
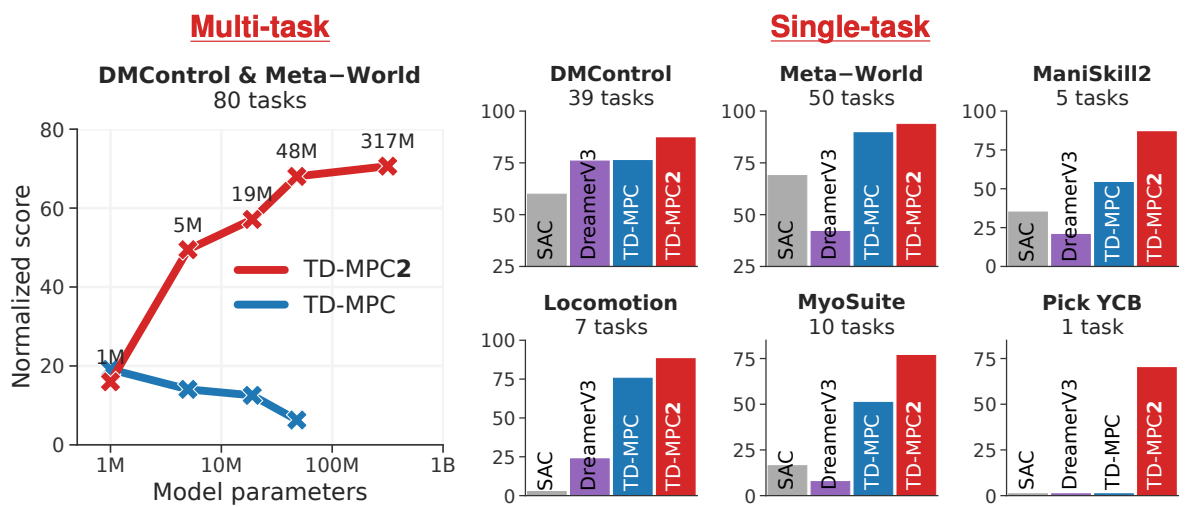
图1:整体结果。右侧展示同一组超参数下,104个连续控制任务上的比较;其中Locomotion与Pick YCB是已有任务域中的困难子集,不能再次相加为总任务数。左侧展示一个3.17亿参数智能体执行跨领域、身体及动作空间的80项任务时的规模结果。
1 引言
在互联网规模数据上训练大模型,已经产生能执行广泛语言与视觉任务的通用模型(Brown等,2020;He等,2022;Kirillov等,2023)。成功很大程度上来自海量数据,以及能随模型和数据规模可靠扩展的架构。研究者已把这种范式扩展到机器人,但从包含多种质量的大型未整理数据集中,通过低层动作学习多样控制任务、跨越不同身体的通用具身智能体,仍未实现。
我们认为,当前方法存在两个主要问题:一是行为克隆依赖接近专家水平的轨迹,严重限制可用数据;二是缺少可处理大规模未整理数据的可扩展连续控制算法。强化学习本来适合从这类数据中提取专家行为,但大多数算法为单任务设计,依赖逐任务超参数,又没有原则性的调参方法。能消化大型多任务数据的算法,必须对动作维度、探索难度和奖励分布等任务差异保持稳健。
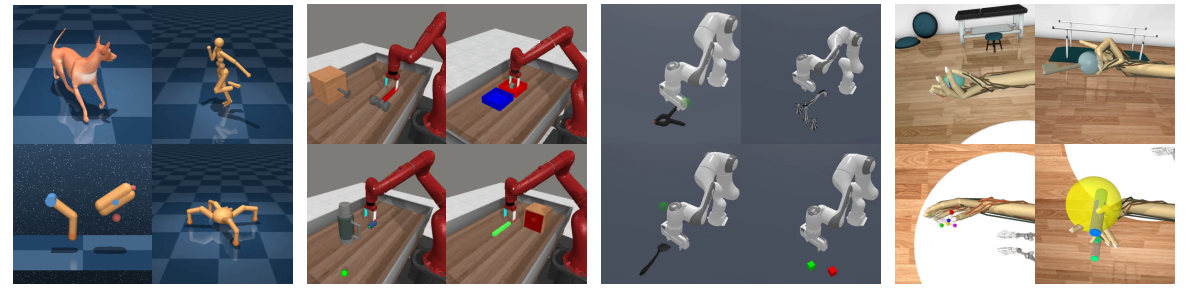
图2:任务示例。TD-MPC2使用同一组超参数执行104项任务,从左到右为DMControl、Meta-World、ManiSkill2、MyoSuite;全部任务可视化见原文附录B。
TD-MPC2是朝这一目标迈出的一步:它面向包含多个任务域、身体、动作空间的大型混合质量数据,学习通用世界模型,数据可以来自从随机到熟练程度各异的行为策略,而不需要逐任务调参。它基于TD-MPC,在学到的隐式、无解码器世界模型潜在空间进行局部轨迹优化。以往TD-MPC家族虽已有很强的经验表现,但多局限于单任务,较少关注规模扩展。
如图1,简单增加TD-MPC的模型与数据规模,往往反而降低智能体表现,这在强化学习文献中并不少见。TD-MPC2则随规模提高持续改善能力。关键贡献有两个方面:重新审视核心设计、提高算法稳健性;谨慎设计能容纳多种身体与动作空间数据的架构,不依赖领域知识。得到的算法能以一组超参数用于不同单任务、多任务连续控制问题。
我们在DMControl、Meta-World、ManiSkill2、MyoSuite共104个连续控制任务上评估,包括最高39维动作空间、图像观察、稀疏奖励、多物体操作、生理学准确的肌肉骨骼控制,以及Dog、Humanoid等复杂运动。TD-MPC2以同一组超参数持续优于已有基于模型和无模型方法。图1中Locomotion与Pick YCB分别是DMControl、ManiSkill2的困难子集。我们还训练一个3.17亿参数世界模型执行80个多领域任务,并公开300多个模型检查点、数据集、训练及评估代码,最后讨论经验、机会与风险。
2 背景
强化学习希望通过与环境交互学习策略,环境形式化为马尔可夫决策过程(MDP)。本文关注连续动作空间的无限跨度MDP,以(S,A,T,R,γ)表示:s∈S为状态,a∈A为动作,T:S×A→S为转移函数,R:S×A→ℝ为任务奖励,γ为折扣因子。目标是找到控制策略π:S→A,使期望折扣奖励总和Eπ[Σₜ₌₀∞γᵗrₜ]最大,其中rₜ=R(sₜ,π(sₜ))。我们学习环境的世界模型,再用模型规划动作。
模型预测控制(MPC)是基于模型控制的一般框架,通过优化有限长度动作序列aₜ:ₜ₊H,使跨度H内回报最大或成本最小:π(sₜ)=argmax_aₜ:ₜ₊H E[Σᵢ₌₀ᴴγᵗ⁺ⁱR(sₜ₊ᵢ,aₜ₊ᵢ)]。(1)候选轨迹的回报由学到的模型模拟估计。这样的策略只在时间上局部最优,不能保证、也不太可能直接解决完整强化学习问题。TD-MPC2使用学到的终端价值函数,对跨度H之后的回报作自举估计,以处理这一局限。
3 TD-MPC2
TD-MPC2以TD-MPC为基础,在隐式世界模型的潜在空间进行局部轨迹优化。我们提出的一系列改进,使算法具有较强稳健性,能对所有任务采用同一组超参数,并将世界模型参数扩展到此前约300倍。下文介绍算法,附录A列出完整主要改进。
3.1 学习隐式世界模型
用重建、即解码目标学习生成式环境模型很有吸引力,因为学习信号丰富。然而,准确预测长时间跨度的原始未来观察,例如图像或本体感觉特征,很困难,也不一定带来有效控制。TD-MPC2不通过重建显式建模动力学,而是希望学到最大限度有用的模型:在动作序列条件下准确预测结果,即回报。
具体而言,我们结合联合嵌入预测、奖励预测与时序差分学习,从环境交互中学习以控制为中心的隐式世界模型,不解码观察。我们认为,这种表述是以适度模型规模建模大型数据集的关键。随后可在MPC框架下通过局部轨迹优化做决策。
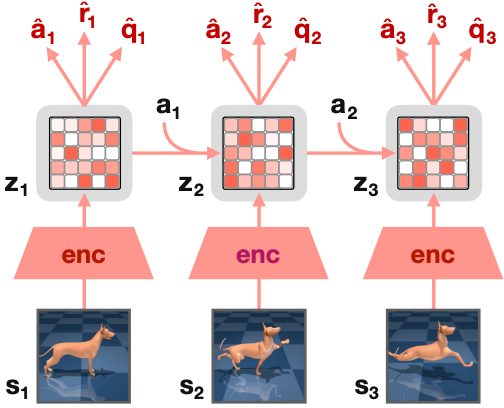
图3:TD-MPC2架构。观察s被编码为归一化潜在表示z,模型循环预测动作â、奖励r̂与终端价值q̂,而不解码未来观察。
| 组件 | 关系式 | 作用 |
|---|---|---|
| 编码器 | z=h(s,e) | 把观察映射到潜在表示 |
| 潜在动力学 | z′=d(z,a,e) | 建模潜在前向动力学 |
| 奖励 | r̂=R(z,a,e) | 预测一次转移的奖励r |
| 终端价值 | q̂=Q(z,a,e) | 预测折扣奖励总和,即回报 |
| 策略先验 | â=p(z,e) | 预测使Q最大的动作a* |
s、a分别为状态和动作,z为潜在表示,e为多任务模型中的可学习任务嵌入。为简洁,后文除必要处省略e。策略先验p引导基于采样的轨迹优化器,并降低TD学习的计算成本。在线交互时,TD-MPC2维护含轨迹的回放缓冲B,迭代从B采样更新世界模型,再用模型规划以采集新数据。
模型目标。h、d、R、Q联合最小化:ℒ(θ)=E_(s,a,r,s′)₀:ᴴ∼B[Σₜ₌₀ᴴλᵗ{‖z′ₜ−sg(h(s′ₜ))‖₂²+CE(r̂ₜ,rₜ)+CE(q̂ₜ,qₜ)}]。(3)三项分别对应联合嵌入预测、奖励预测与价值预测。sg为停止梯度,qₜ≔rₜ+γQ̄(z′ₜ,p(z′ₜ))为TD目标,λ∈(0,1]降低更远时间步的权重。用于计算目标的Q̄是Q的指数移动平均。
任务奖励规模可能差异很大,因此TD-MPC2把奖励和价值预测写成对数变换空间中的离散回归,即多类分类;以rₜ、qₜ为软目标,最小化交叉熵。该方法参考Bellemare等(2017)、Kumar等(2023)、Hafner等(2023)。
策略目标。先验p是随机最大熵策略,原文将其目标写为最大化:ℒ_p(θ)=E_(s,a)₀:ᴴ∼B[Σₜ₌₀ᴴλᵗ{αQ(zₜ,p(zₜ))−βℋ(p(·|zₜ))}],zₜ₊₁=d(zₜ,aₜ),z₀=h(s₀)。(4)ℋ为p的熵,可闭式计算;梯度仅作用于p。数值估计与熵在不同数据集和训练阶段的规模可能变化很大,必须平衡,以避免熵过早坍塌。常见方法固定α、β之一,按熵目标或移动统计调整另一个。我们用移动统计调整α,经验上两种选择没有显著结果差异。
架构。所有组件使用MLP,中间线性层后接LayerNorm和Mish。为缓解梯度爆炸,将z分成L组固定维度的单纯形,用softmax归一化。相比离散表示或挤压函数,单纯形表示无需强制硬约束,就能自然偏向稀疏性,称为SimNorm。令每组维度为V,则z°=[g₁,…,g_L],每组gᵢ=softmax(zᵢ:ᵢ₊V/τ)。(5)方括号表示拼接,τ>0控制表示稀疏程度。实验将展示它对训练稳定性的重要性。
为降低TD目标偏差,我们用式(3)训练Q函数集合,对每个Q维护指数移动平均Q̄。实际使用5个Q函数,计算目标时随机取两个目标Q,再取其中较小值。
3.2 带策略先验的模型预测控制
TD-MPC2在学到的世界模型中规划,得到闭环控制策略。我们采用MPC进行局部轨迹优化,以模型预测路径积分(MPPI)为无梯度优化器,采样动作序列并用潜在轨迹滚动评估。每个决策步估计时间变化、对角协方差多元高斯分布的参数μ*、σ*,使期望回报最大:
(μ*,σ*)=argmax_(μ,σ) E_(aₜ,…,aₜ₊H)∼𝒩(μ,σ²)[γᴴQ(zₜ₊H,aₜ₊H)+Σ_h₌ₜᴴ⁻¹γʰR(z_h,a_h)]。(6)原式的索引与折扣记号在此保留,μ、σ∈ℝᴴˣᵐ,动作空间A⊂ℝᵐ。
反复从该高斯分布采样序列、评估期望回报、按加权平均更新μ和σ,求解式(6)。终端价值把H以后的回报自举进来,从而估计第2节完整强化学习目标。固定次数迭代后,只在环境执行第一个动作aₜ∼𝒩(μ*ₜ,σ*ₜ)。为加快收敛,一部分动作序列来自策略先验p;每步规划还用上一步解平移一位,作为热启动。更多规划细节见Hansen等(2022)。
3.3 训练通用 TD-MPC2 智能体
前述算法解释了单任务表现;要跨任务域、身体与动作空间训练一个大型通用智能体,还需回答:如何表示任务语义,如何在不依赖领域知识时容纳不同观察和动作空间,以及如何利用已学模型少样本适配新任务。
可学习任务嵌入。多任务智能体需要利用任务相似性的共同表示,同时保留测试时区分任务的能力。若有自然语言指令等任务或领域知识,e可以编码这些信息;一般情形不能假设这些知识存在,则从数据学习嵌入及隐含任务关系。TD-MPC2的五个组件都接受固定维度任务嵌入e,与其他参数联合训练。为提高稳定性,约束e的L2范数≤1;实验中也产生更语义连贯的嵌入。微调新任务时,可以用相近任务的嵌入初始化,也可以随机初始化。
动作屏蔽。面对不同观察、动作空间,TD-MPC2把全部模型输入和输出补零到各自最大维度,并在训练及推理时,屏蔽策略先验预测中的无效动作维度。这使无效维度的预测误差不影响TD目标,也避免较小动作空间的任务因额外维度而虚增策略熵。规划时同样只在有效维度采样动作。
4 实验
我们评估DMControl、Meta-World、ManiSkill2、MyoSuite共104项连续控制任务,包括最高39维动作、稀疏奖励、多物体操作、肌肉骨骼控制和复杂运动,难度跨度很大;另含10项基于图像观察的DMControl任务。我们公开300多个模型检查点、数据集、训练和评估代码。
- 比较已有方法:在样本高效的连续控制上,与SAC、DreamerV3、TD-MPC相比如何?
- 规模扩展:算法改进能否随模型与数据增长改善能力,一个智能体能否跨任务、身体、动作空间学习多样技能?
- 分析:各设计怎样影响结果,规划贡献多大,任务嵌入是否有语义,大型多任务模型能否适配新任务?
主要基线为最大熵无模型actor–critic算法SAC;用生成式模型滚动训练无模型策略的DreamerV3;以及在隐式、非生成世界模型中规划的原始TD-MPC。视觉强化学习还与CURL、DrQ-v2比较,前者为SAC增加对比辅助目标,后者使用数据增强。SAC与TD-MPC采用逐任务超参数,TD-MPC2使用共同设置。
SAC、TD-MPC的批大小为512,TD-MPC2为256已能稳定学习;DreamerV3的更新/数据比(UTD)为512,TD-MPC2默认1。除非另作说明,TD-MPC2使用约500万参数模型;作为参照,DreamerV3基线约2000万可学习参数。实现设置详见附录H。
4.1 结果:与已有方法比较
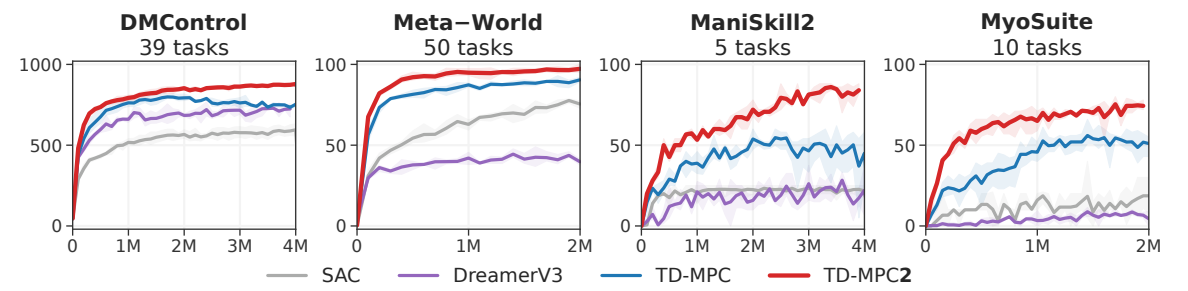
图4:104项任务的单任务在线强化学习。横轴为环境步数,DMControl纵轴为回合回报,其余为成功率。TD-MPC2使用共同超参数设置,在这些任务域表现出更高数据效率和渐近表现。曲线为3个种子的均值与95%置信区间。
我们先比较在线强化学习中104项任务的数据效率,汇总见图4。TD-MPC2在各任务域优于此前方法。MyoSuite尤其值得关注,因为在所报告实验之前,我们没有在这一基准运行TD-MPC2实验。高维运动和多物体操作等困难任务见图5、6。
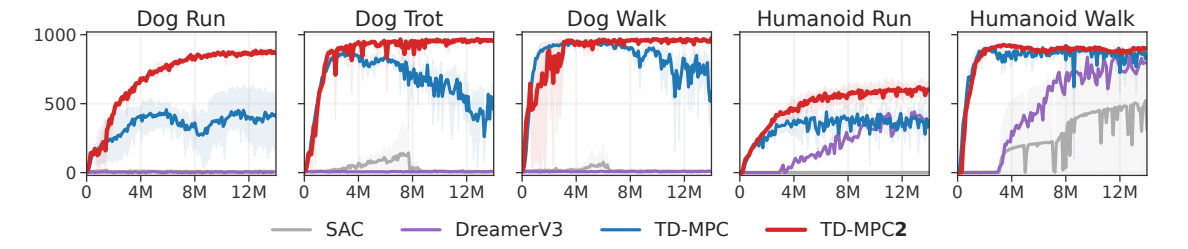
图5:高维运动任务。Humanoid动作维度21,Dog为38,显示回报随环境步数变化。论文报告SAC、DreamerV3在Dog上容易数值不稳定,在Humanoid上数据效率低于TD-MPC2。均为3个种子的均值及95%置信区间。完整单任务结果见原文附录D。
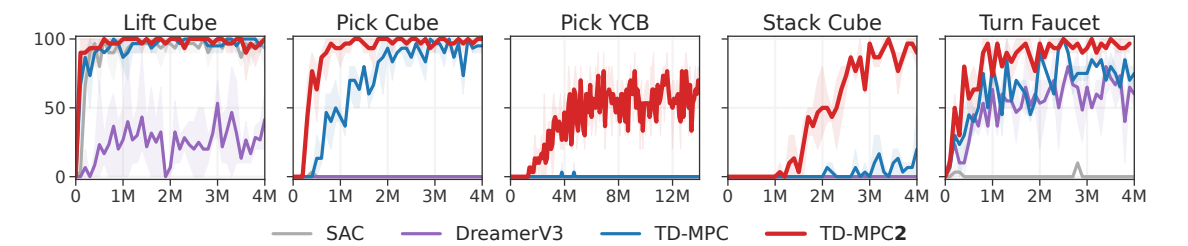
图6:ManiSkill2的5项物体操作任务,纵轴为成功率。Pick YCB涉及YCB数据集的全部74个对象。TD-MPC2在困难任务中表现较强,曲线为3个种子的均值及95%置信区间。
这些任务中,TD-MPC2以共同超参数大幅超过基线。TD-MPC有时因梯度爆炸而发散,TD-MPC2仍稳定;逐任务梯度可视化见附录G。DreamerV3偶尔在Dog任务数值不稳定,并在抬起、抓取、堆叠等精细物体操作中整体较困难。完整结果见原文附录D。
4.1 结果:大规模多任务与模型扩展
为展示改进支持世界模型扩展,我们在80项多样任务上评估100万至3.17亿参数的5种多任务模型。任务跨领域、目标、身体与动作空间。训练数据来自240个单任务TD-MPC2智能体的回放缓冲,共5.45亿条转移,因此覆盖从随机到专家的不同质量行为。任务集由Meta-World全部50项任务,以及DMControl的30项任务组成,后者包含19项原任务和11项新任务。还单列DMControl 30项任务、3.45亿转移的规模结果。
得益于算法设计,扩大规模很直接:为提高收敛速度,批大小取单任务实验的4倍,即1024,其余超参数不变。图7展示规模结果。汇总分数是Meta-World各任务成功率与DMControl归一化到[0,100]回报的平均。两组数据上,能力持续随模型增大而提高;最大3.17亿参数模型尚未显露饱和,因此我们预计继续增大会改善结果。我们没有制定规模定律,但归一化分数似乎随参数量的对数线性增长。
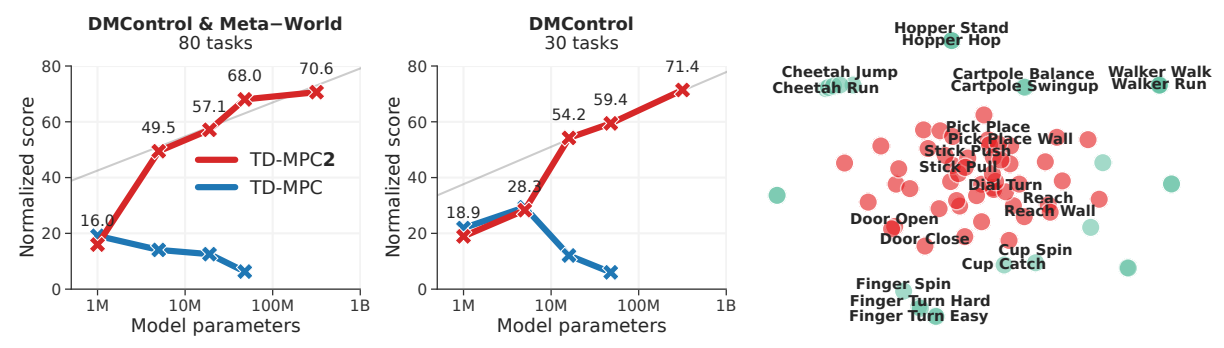
图7:大规模多任务世界模型。左侧为80任务和30任务数据集上,归一化分数随模型规模的变化;右侧为80任务模型学得的任务嵌入的T-SNE可视化,红色为DMControl,绿色为Meta-World。全部坐标、数值与任务标签保留。
| 参数量(百万) | GPU天 | 分数 |
|---|---|---|
| 1 | 3.7 | 16.0 |
| 5 | 4.2 | 49.5 |
| 19 | 5.3 | 57.1 |
| 48 | 12 | 68.0 |
| 317 | 33 | 70.6 |
为理解多任务学习为何有效,我们检查图7的任务嵌入。Door Open与Door Close等语义相近任务在空间中靠近。不过,嵌入相似性似乎更贴近身体、对象等任务动力学,而不是walk、run这样的目标;这也符合动力学与控制密切相关的直觉。
4.1 结果:少样本、消融与视觉控制
少样本学习。虽然本文主要关注规模与稳健性,也探索预训练世界模型对未见任务的微调。先在DMControl、Meta-World共70项任务上预训练一个1900万参数模型,再对10项留出任务分别用在线强化学习微调整个模型,两个任务域各5项。微调从空回放缓冲开始,不改超参数。图8显示,在低数据区间,即2万环境步,约比从头学习改善两倍。这是有潜力的初步结果,新任务世界模型微调仍是开放研究问题,细节及曲线见附录E。2万步对应DMControl的20回合或Meta-World的100回合。
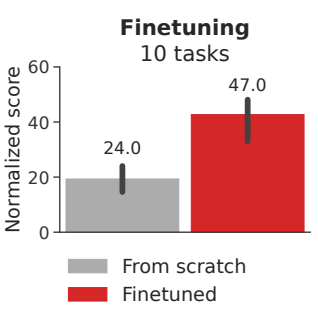
图8:少样本微调。1900万参数模型先在70项任务训练,再为10项留出任务分别在线微调2万环境步。3个种子汇总:从头学习24.0,微调47.0。
消融。我们分析actor选择、归一化、回归目标与Q函数数量,在3项最困难的在线任务及80任务大规模多任务训练中评估。图9表明,每项改进都对两种设置的稳健性与较强表现作出有意义贡献,设计的重要性关系也较一致。附录F还分析任务嵌入归一化,结果显示归一化嵌入对稳定训练有适度重要性,并使任务关系更有意义。
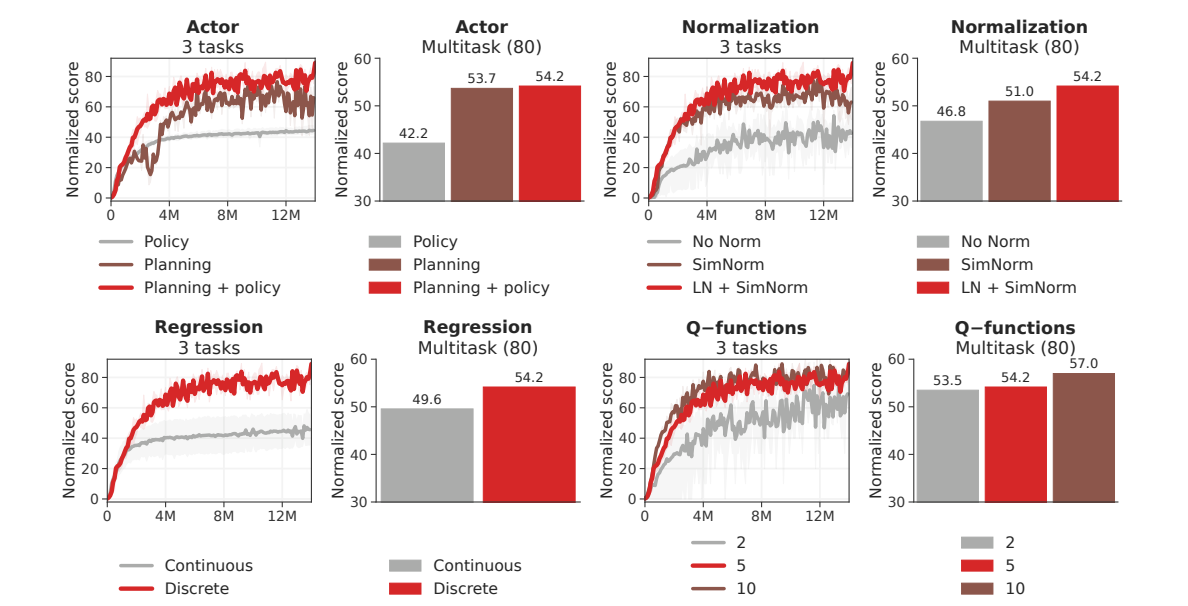
图9:主要消融。曲线为Dog Run、Humanoid Walk、Pick YCB三项任务汇总,3个随机种子均值与95%置信区间;柱状图为1900万参数、80任务模型的归一化分数。红色表示默认配置。更多消融见原文附录D、F。
视觉强化学习。本文主要考虑使用本体感觉状态的高维连续控制,但也可更换输入模态。将编码器改为浅层卷积编码器后,在难度不同的10项DMControl图像任务上比较,图10显示TD-MPC2与表现最好的DrQ-v2、DreamerV3相当,而无须改动超参数。
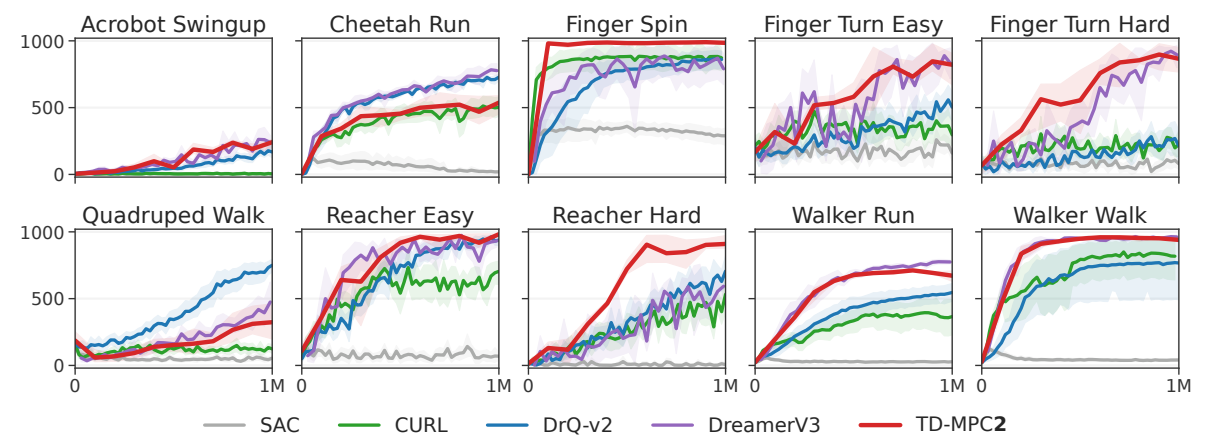
图10:10项基于图像的DMControl任务,横轴为环境步数,纵轴为回合回报。TD-MPC2表现与强基线相当,曲线为3个随机种子的均值及95%置信区间。
5 经验、机会与风险
经验。强化学习算法长期对架构、超参数、任务特征甚至随机种子非常敏感,也缺少原则性的调参方法,因此深度强化学习的成功应用常需大型专家团队和大量计算。TD-MPC2与一些同期方法希望通过提高开源算法稳健性,降低小型学术团队、从业者及个人使用强化学习的门槛。我们相信,稳健性仍将深刻影响领域发展。一个关键经验是,社区还没有找到真正开箱即用、掌握一切的算法。DreamerV3在Atari、Minecraft等离散动作困难任务表现强,而TD-MPC2在困难连续控制上明显更好;扩展到离散动作仍是开放问题。
机会。规模结果展示了把大规模多任务世界模型用作通用模型的路径。多任务世界模型仍研究较少,已有工作暗示,TD-MPC2的隐式模型可能比重建方法更适合视觉变化大的任务。我们设想,未来隐式模型能零样本执行已见身体上的多样任务,微调到新身体,并与视觉语言模型结合,把高级认知与低层物理交互连接起来。结果有潜力,但这种泛化可能需要比当前多几个数量级的任务。
TD-MPC2虽依赖奖励,也可把奖励广义理解为任务完成度量。现实中已有成功标签、人类偏好、干预,或既有表征中当前观察与目标的嵌入距离等信号;但利用它们进行大规模预训练仍是开放问题。为加快研究,我们发布300多个模型,其中包括12个多任务模型,以及数据和代码。
风险。通用世界模型仍面临挑战:任务奖励设定不当可能产生难以预见的后果;在没有额外安全检查时,让学习模型不受约束地自主控制实体机器人,可能导致灾难性失败;一些应用所需的大规模数据,对小团队而言可能贵到无法取得,造成权力集中。缓解这些问题都需要新的研究。
致谢
本项目部分由NSF CAREER Award(2240160)、NSF TILOS AI Institute(2112665)、NSF CCF-2112665(TILOS)、NSF 1730158 CI-New:Cognitive Hardware and Software Ecosystem Community Infrastructure(CHASE-CI)、NSF ACI-1541349 CC*DNI Pacific Research Platform资助,并获Qualcomm捐赠支持。
附录 A:主要改进汇总
架构。TD-MPC2各组件在层间使用LayerNorm与Mish,潜在状态z用SimNorm,使表示倾向稀疏并保持较小L2范数。默认训练5个Q,每个Q第一层后加1% Dropout;TD目标取随机选出的两个目标Q的最小值。原TD-MPC不使用LayerNorm,采用ELU,不约束潜在状态,有时导致梯度爆炸;只训练2个Q,也不用Dropout。默认模型由约100万参数增至约500万,净增约400万;但图7表明,单纯放大TD-MPC并不能持续提高表现,TD-MPC2则可以。
策略先验。TD-MPC2用最大熵强化学习训练随机先验;TD-MPC则训练确定策略,再向动作加入高斯噪声。精心调节的高斯噪声调度与最大熵先验结果可比,但最大熵更容易采用与任务无关的超参数。多动作空间任务中,只对有效维度计算熵。
规划。总体沿用TD-MPC,但去掉迭代间动量,结果相当、实现更简单;代码层优化使规划吞吐约提高两倍。
模型目标。TD-MPC2在对数变换空间对奖励、价值作离散回归,使用软交叉熵,使这两项损失的规模不依赖任务奖励大小。TD-MPC使用连续回归,在奖励较大任务可能不稳定;单任务中可用移动统计归一奖励缓解,但很难设计稳健的多任务归一方案。联合嵌入仍保留连续回归,因为SimNorm已归一潜在表示,而高维空间离散回归成本很高,每维都需要N个分箱。
多任务模型。引入所有组件均使用的归一化可学习任务嵌入,以补零和动作屏蔽容纳多种观察、动作空间;训练大量任务,再通过在线强化学习微调到跨身体的留出任务。原TD-MPC只研究少量、共享观察与动作空间的多任务学习,也不研究多任务模型微调。
算法与实现简化。移除MPPI动量,以均匀采样代替优先经验回放,不显著改变结果;使用多工作进程采样的更快回放缓冲,并通过Q集合向量化等代码优化提高训练和规划吞吐。虽然架构更大,TD-MPC2的墙钟时间与TD-MPC相当。
附录 E:少样本实验结果
我们将70项任务训练的1900万参数模型,分别微调到10个留出任务,单任务曲线见图17。与相近容量、从头训练的基线比较数据效率。不过,1900万参数从头训练的表现,与同样从头训练的500万模型相近。少样本结果显示微调效果有一定任务依赖;还需要更多研究确定原因是任务相似性,还是预训练智能体在源任务表现不佳。我们推测两者都可能影响结果。
为未见任务微调时,用预训练数据中语义相近任务的嵌入初始化新任务e。表7列出配对;没有实验其他初始化方案或任务配对。
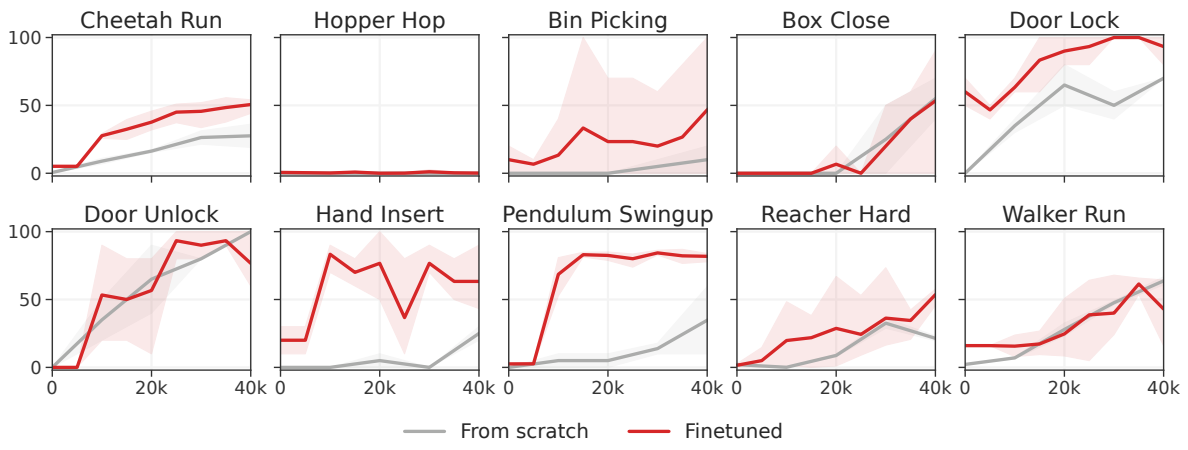
图17:少样本学习。将70任务预训练的1900万参数TD-MPC2模型微调到10项留出任务;DMControl纵轴为归一化回合回报,Meta-World为成功率。2万步对应前者20回合、后者100回合。曲线与阴影为3个种子的均值与95%置信区间。
| 目标任务 | 源任务 |
|---|---|
| Walker Run | Walker Walk |
| Cheetah Run | Cheetah Run Backwards |
| Hopper Hop | Hopper Stand |
| Pendulum Swingup | Pendulum Spin |
| Reacher Hard | Reacher Easy |
| Bin Picking | Bin Picking |
| Box Close | Assembly |
| Door Lock | Door Open |
| Door Unlock | Door Open |
| Hand Insert | Sweep Into |
附录 H:架构与实现细节
全部组件为MLP。编码器h随模型规模有2—5层,其余组件为3层MLP。中间层为线性层、LayerNorm、Mish,潜在表示归一为单纯形嵌入,Q额外使用Dropout。下表按原文类似PyTorch的代码记号,保留默认500万参数配置。原代码中S表示输入维度,T用于任务相关维度记号,A为动作空间;单任务去掉任务嵌入。原文参数计数给定S=39、任务数80、A=6,任务嵌入输出维度为96。
| 组件 | 结构或层宽 | 其他设置 |
|---|---|---|
| 任务嵌入 | Embedding(T,96,max_norm=1) | 任务向量最大范数1 |
| 状态编码器 | S+T → 256 → 512 | 中间Mish,输出SimNorm |
| 动力学 | 512+T+A → 512 → 512 → 512 | 前两层Mish,输出SimNorm |
| 奖励 | 512+T+A → 512 → 512 → 101 | 中间Mish,末层Linear |
| 策略 | 512+T → 512 → 512 → 2A | 中间Mish,末层带偏置 |
| Q函数集合 | 5×(512+T+A → 512 → 512 → 101) | 首层Dropout=0.01,中间Mish,末层带偏置 |
译注:上表尺寸表达式中的T沿用原代码。原代码文字把T称为任务数,但任务嵌入的输出维度为96;这两个量不能在自行实现时直接混用。此处保留原文记号,同时将已明确的任务数和嵌入维度分别列出。
| 组件 | 参数数 |
|---|---|
| 编码器 | 167,936 |
| 动力学 | 843,264 |
| 奖励 | 631,397 |
| 策略 | 582,668 |
| Q函数 | 3,156,985 |
| 任务 | 7,680 |
| 总计 | 5,389,930 |
超参数。不同任务使用同一组配置,见表8;部分实际数值由共同启发式自动设定。TD-MPC与SAC沿用Hansen等(2022)的设置,DreamerV3使用固定设置。
| 部分 | 超参数 | 取值 |
|---|---|---|
| 规划 | 跨度H | 3 |
| 规划 | 迭代数 | 6;动作维度≥20时再加2 |
| 规划 | 种群大小 | 512 |
| 规划 | 策略先验样本数 | 24 |
| 规划 | 精英数 | 64 |
| 规划 | 最小标准差 | 0.05 |
| 规划 | 最大标准差 | 2 |
| 规划 | 温度 | 0.5 |
| 规划 | 动量 | No |
| 策略先验 | 最小log标准差 | −10 |
| 策略先验 | 最大log标准差 | 2 |
| 回放缓冲 | 容量 | 1,000,000 |
| 回放缓冲 | 采样 | 均匀 |
| 架构5M | 编码器维度 | 256 |
| 架构5M | MLP维度 | 512 |
| 架构5M | 潜在状态维度 | 512 |
| 架构5M | 任务嵌入维度 | 96 |
| 架构5M | 任务嵌入范数 | 1 |
| 架构5M | 激活 | LayerNorm+Mish |
| 架构5M | Q函数Dropout | 1% |
| 架构5M | Q函数数 | 5 |
| 架构5M | 奖励/价值分箱数 | 101 |
| 架构5M | SimNorm维度V | 8 |
| 架构5M | SimNorm温度τ | 1 |
| 优化 | 更新/数据比 | 1 |
| 优化 | 批大小 | 256 |
| 优化 | 联合嵌入系数 | 20 |
| 优化 | 奖励预测系数 | 0.1 |
| 优化 | 价值预测系数 | 0.1 |
| 优化 | 时间系数λ | 0.5 |
| 优化 | Q移动平均系数 | 0.99 |
| 优化 | 策略先验熵系数 | 1×10⁻⁴ |
| 优化 | 策略先验损失归一化 | 移动的5%、95%分位数 |
| 优化 | 优化器 | Adam |
| 优化 | 学习率 | 3×10⁻⁴ |
| 优化 | 编码器学习率 | 1×10⁻⁴ |
| 优化 | 梯度裁剪范数 | 20 |
| 优化 | 折扣因子 | 启发式 |
| 优化 | 初始采集步数 | 启发式 |
附录 H:启发式、模型配置与 SimNorm
折扣因子按γ=clip(((T/5)−1)/(T/5),[0.95,0.995])设置。(7)这里T为动作重复后预期回合长度。DMControl的T=500,对应常用γ=0.99。短回合任务取较低折扣,长回合任务取较高折扣。本文任务均为固定回合长度的无限跨度MDP;多任务训练对各任务分别按该规则设折扣。回合长度可变或未知时,建议用经验平均长度、合理估计,或直接γ=0.99。为公平,TD-MPC与SAC也用相同折扣。
开始任何梯度更新前的初始环境采集步数为S=max(5T,1000)。(8)T仍为动作重复后预期回合长度。我们未实验其他启发式或常数,但推测它能在不同回合长度下为模型学习提供足够缓冲数据。
多任务实验的模型从100万到3.17亿参数。通过改变全连接宽度、潜在状态维度、编码器层数和Q函数数量扩大规模;除此之外,不改架构与超参数。具体配置见表9,所有规模计算TD目标时仍随机取两个Q;未实验其他模型配置。
| 配置 | 1M | 5M(默认) | 19M | 48M | 317M |
|---|---|---|---|---|---|
| 编码器维度 | 256 | 256 | 1024 | 1792 | 4096 |
| MLP维度 | 384 | 512 | 1024 | 1792 | 4096 |
| 潜在状态维度 | 128 | 512 | 768 | 768 | 1376 |
| 编码器层数 | 2 | 2 | 3 | 4 | 5 |
| Q函数数 | 2 | 5 | 5 | 5 | 8 |
| 任务嵌入维度 | 96 | 96 | 96 | 96 | 96 |
单纯形归一化SimNorm把z分成L组固定维度向量,各组经softmax成为单纯形。它自然偏向稀疏,但不施加离散或其他硬约束。可把它理解为VQ-VAE向量类别表示的“软”版本:VQ-VAE每组用独热离散编码,SimNorm每组为总和1的连续值;这类似softmax对argmax的松弛。实验不调整温度,但温度提供在两种极端间变化的机制。原文随后写道,τ→∞会得到独热编码,τ=0会得到均匀常量编码、阻碍信息传播。
译注:上一句极限方向与原文式(5)的softmax(z/τ)不一致。按该公式,对非并列最大值,τ→0⁺趋向独热选择,τ→∞趋向均匀分布。原论文文字按原样译出,此处单独说明,不把修正混入作者结论。
SimNorm代码执行顺序:记录z原形状;将最后一维重排为若干个维度V=8的分组;对每组最后一维作softmax;再恢复原形状。组数L可由V和z维度推得。softmax可选地由温度τ调节,每组变成单纯形。
附录 H:视觉输入与基线实现
视觉强化学习。图10实验将默认MLP编码器换为4层浅卷积编码器,图像64×64,并按此前工作施加随机平移增强。较低分辨率用于降低计算并与基线公平比较;此前研究已展示TD-MPC支持9×224×224输入。
TD-MPC基线使用官方实现nicklashansen/tdmpc,默认世界模型约100万参数,逐任务超参数。在DMControl和Meta-World有推荐值时沿用;Dog、Humanoid需调整规划迭代、潜在维度、批大小和学习率。完整列表见原论文。
DreamerV3基线使用danijar/dreamerv3官方重实现,沿用作者对DMControl本体感觉控制的建议,使用S尺寸、约2000万参数,以及UTD=512;全部任务都采用相同尺寸与UTD,完整超参数见原论文。
SAC基线沿用TD-MPC论文的选择,使用denisyarats/pytorch_sac实现,有作者推荐参数时采用;Dog、Humanoid调整潜在维度、学习率和批大小。完整列表见相应论文。
原文与来源
图片:Nicklas Hansen、Hao Su、Xiaolong Wang · TD-MPC2(2024)· CC BY 4.0 · 原图未改动